


 Spanish (pdf)
 Article in xml format
 Article references

 Automatic translation
 Send this article by e-mail
 Cited by SciELO
 Similars in
SciELO

 Permalink


I. INTRODUCCIÓN
En la última década, la inteligencia artificial (IA) dejó de ser un “sistema experto” confinado a laboratorios o a nichos industriales para convertirse en una infraestructura cotidiana: motores de recomendación que curan lo que vemos y escuchamos, sistemas de ranking que ordenan información “relevante”, modelos predictivos que sugieren rutas, productos, amistades, noticias, e incluso patrones de conducta “esperables”. Esta expansión no solo incrementó la eficiencia en la gestión de grandes volúmenes de datos; también transformó el modo en que las personas perciben opciones, anticipan consecuencias y justifican decisiones. En términos aplicados, la vida diaria se volvió un entorno de micro-decisiones mediadas por algoritmos, donde la optimización computacional (clics, tiempo de permanencia, conversión, retención) convive -a veces en tensión- con la experiencia subjetiva de autonomía, preferencia y sentido.
Desde una perspectiva de ciencias aplicadas, los sistemas algorítmicos que operan en plataformas digitales pueden describirse como tuberías de decisión (decision pipelines) basadas en: (i) recolección de señales (historial, contexto, interacción), (ii) modelado predictivo (probabilidad de elección o respuesta), y (iii) ranking o asignación de recursos (qué se muestra primero, qué se sugiere, qué se oculta). El resultado práctico es una “arquitectura de elección” dinámica que se actualiza en tiempo real. En este marco, la influencia algorítmica no requiere coerción explícita; basta con alterar el orden, la disponibilidad o la saliencia de las alternativas. La literatura de digital nudging formaliza este fenómeno al extender el concepto de nudge hacia entornos digitales: la interfaz y la lógica de presentación pueden guiar elecciones de manera predecible sin eliminar opciones 1,2. Esta perspectiva es especialmente pertinente porque conecta mecanismos de diseño (por ejemplo, defaults, jerarquización, recordatorios, señales de escasez) con resultados observables en comportamiento, abriendo la puerta a análisis cuantitativos robustos (modelos de elección, efectos de tratamiento, experimentos A/B y simulación).
Sin embargo, la relevancia social del problema emerge cuando se reconoce que estos sistemas no solo “asisten” decisiones: reconfiguran el marco cognitivo desde el cual las personas deciden. La teoría del juicio y la decisión ha mostrado que la elección humana está condicionada por sesgos sistemáticos y por la forma de enmarcar alternativas, incluso cuando los individuos creen decidir libremente 3. En contextos mediado-algorítmicos, el “marco” ya no es estable: es personalizable, adaptativo y opaco. Así, la subjetividad social -entendida como construcción de preferencias, valores, identidades y expectativas en interacción con el entorno- se ve atravesada por recomendaciones y rankings que actúan como filtros de realidad: determinan qué información se vuelve accesible y qué contenidos se vuelven “normales” o “deseables”. Evidencia reciente sobre servicios de streaming discute cómo los recomendadores pueden incidir en la formación del gusto y en elecciones estéticas, precisamente porque mediatizan el descubrimiento y la exposición cultural 4. En paralelo, estudios sobre juventudes y recomendaciones algorítmicas resaltan la ambivalencia entre conveniencia y pérdida de agencia: los sistemas facilitan navegar la sobrecarga informativa, pero también delimitan recursos para explorar alternativas no anticipadas por el modelo 5.
La noción de agencia humana adquiere aquí un rol central. En ámbitos laborales, por ejemplo, la “gestión algorítmica” (asignación de tareas, evaluación, planificación) ha motivado marcos conceptuales que analizan riesgos y oportunidades para la autonomía cuando decisiones relevantes pasan por modelos de predicción y optimización 6. Aunque el entorno laboral tiene especificidades, su lógica se asemeja a la vida cotidiana digital: el algoritmo no reemplaza necesariamente la voluntad individual, pero puede estrechar el espacio de deliberación al imponer métricas, prioridades y rutas de acción “eficientes”. En el consumo de contenidos, esto se observa con especial fuerza: un trabajo reciente sobre recomendaciones personalizadas en una gran plataforma de streaming propone un modelo de elección discreta para estimar efectos incrementales de la recomendación sobre el comportamiento de consumo y la diversidad, mostrando cómo el diseño del recomendador puede modificar patrones de elección y engagement7. Estos resultados, aun cuando se centran en métricas de plataforma, son cruciales para ciencias aplicadas porque evidencian que la recomendación no es un “detalle de interfaz”: es un mecanismo causal potencialmente medible que altera la conducta.
La expansión de la IA cotidiana también intensifica desafíos clásicos de equidad, sesgo y responsabilidad. Modelos entrenados con datos históricos pueden reproducir desigualdades preexistentes o amplificarlas, especialmente cuando se usan como apoyo o sustituto de decisiones humanas en ámbitos sensibles (crédito, seguros, empleo, visibilidad en mercados digitales). Un referente clave en este debate argumenta que el impacto discriminatorio puede emerger incluso sin variables sensibles explícitas, por correlaciones y por la lógica de optimización del sistema 8. Para una revista de ciencias aplicadas, esto no es solo una discusión normativa: es un problema técnico-metodológico. La equidad depende de decisiones concretas de ingeniería (métricas de desempeño, función objetivo, muestreo, feature engineering, umbrales, calibración), y por ello requiere instrumentación cuantitativa: métricas de fairness, auditorías, análisis de sensibilidad y evaluación de robustez.
En paralelo, la opacidad de los modelos modernos -desde ensamblajes hasta redes profundas- plantea un límite práctico para la confianza y el control social: si las personas no comprenden por qué una recomendación o clasificación aparece, se debilita la capacidad de cuestionar, corregir o resistir la influencia. En respuesta, la investigación en explainable AI (XAI) ha desarrollado enfoques para aproximar explicaciones locales o globales de modelos complejos. Métodos ampliamente citados, como LIME, buscan ofrecer explicaciones interpretables a nivel de instancia para apoyar comprensión y evaluación humana 9. A nivel de revisión, la literatura ha sistematizado taxonomías de explicabilidad y ha discutido tensiones entre fidelidad, interpretabilidad y utilidad en contextos reales 10. Complementariamente, guías de interacción humano-IA proponen principios de diseño (por ejemplo, gestionar expectativas, comunicar incertidumbre, permitir corrección, dar control gradual) que ayudan a traducir capacidades técnicas en experiencias más seguras y transparentes 11. En conjunto, estas líneas señalan que la “subjetividad algorítmica” no depende solo de que exista IA, sino de cómo se presenta, cómo se integra en el flujo de decisión y qué posibilidades brinda para supervisión y agencia.
En este escenario, surge una necesidad de investigación que sea simultáneamente socialmente sensible y técnicamente rigurosa: (i) conceptualizar la influencia algorítmica en decisiones diarias como un fenómeno socio-técnico medible; (ii) operacionalizar constructos de subjetividad (percepción de control, confianza, satisfacción, carga cognitiva, dependencia de recomendación, percepción de manipulación) mediante indicadores cuantitativos; y (iii) modelar, con herramientas de ciencias aplicadas, los mecanismos que conectan diseño algorítmico con cambios en conducta y experiencia. Esto habilita un enfoque cuantitativo consistente con la orientación del presente trabajo: uso de datos sintéticos para simular escenarios (por ejemplo, variación de intensidad de recomendación, diversidad de exposición, opacidad/explicabilidad), estimación de relaciones mediante modelos estadísticos (regresión, modelos de elección, SEM/PLS-SEM cuando corresponda) y evaluación de estabilidad mediante análisis de sensibilidad. Así, el artículo propone aportar evidencia y estructura analítica para comprender cómo la IA reconfigura decisiones humanas en la vida diaria sin reducir el problema a una dicotomía simplista entre “tecnología buena” o “tecnología mala”, sino tratándolo como un sistema optimizable donde las variables humanas importan tanto como las métricas de desempeño 12.
II. MARCO TEÓRICO
La inteligencia artificial contemporánea puede entenderse menos como una tecnología aislada y más como una infraestructura socio-técnica integrada en la vida diaria. A diferencia de los sistemas automatizados clásicos, los sistemas basados en aprendizaje automático operan de forma adaptativa, aprendiendo de grandes volúmenes de datos generados por interacciones humanas y retroalimentando continuamente sus propios procesos de decisión 13. Esta característica convierte a la IA en un actor estructural del entorno social, capaz de mediar prácticas cotidianas como el consumo de información, la toma de decisiones económicas, la planificación del tiempo y la interacción social.
Desde las ciencias aplicadas, esta infraestructura se materializa en algoritmos de recomendación, clasificación y predicción, diseñados para optimizar funciones objetivo concretas (engagement, eficiencia, reducción de riesgo, personalización) 14. No obstante, estas funciones técnicas no son neutrales: al definir qué se optimiza, los sistemas introducen criterios normativos implícitos que influyen en la experiencia humana. Estudios clásicos sobre sistemas de recomendación muestran que pequeñas variaciones en el diseño algorítmico pueden generar cambios sistemáticos y medibles en el comportamiento del usuario, incluso cuando este percibe sus decisiones como autónomas 1,2.
A. Algoritmos cotidianos y arquitectura de la decisión
El concepto de arquitectura de la decisión proporciona un puente teórico clave entre ingeniería y ciencias sociales. Originalmente desarrollado en el ámbito de la economía conductual, este enfoque sostiene que las decisiones humanas están profundamente influidas por la forma en que las opciones se presentan, ordenan y contextualizan 3. En entornos digitales, dicha arquitectura es implementada algorítmicamente: los sistemas determinan el orden de visibilidad, la relevancia percibida y la frecuencia de exposición de las alternativas.
La literatura sobre digital nudging amplía este marco al ámbito computacional, demostrando que las interfaces algorítmicas pueden guiar elecciones sin eliminar opciones ni recurrir a coerción directa 4. Desde un punto de vista aplicado, estos efectos son especialmente relevantes porque permiten ser modelados, simulados y cuantificados, utilizando herramientas como modelos de elección discreta, análisis causal y simulaciones Monte Carlo. Así, la influencia algorítmica se convierte en un fenómeno observable y reproducible, compatible con el enfoque cuantitativo del presente estudio 15,16.
B. Subjetividad social en entornos algorítmicos
La subjetividad social se refiere al proceso mediante el cual los individuos construyen percepciones, preferencias, identidades y expectativas en interacción con su entorno social y simbólico. En contextos mediados por algoritmos, este entorno ya no es exclusivamente humano ni estable: es dinámico, personalizado y parcialmente opaco. Los algoritmos actúan como filtros de realidad, determinando qué información se vuelve accesible y qué alternativas permanecen invisibles 16.
Investigaciones recientes señalan que los sistemas algorítmicos no solo responden a preferencias preexistentes, sino que pueden moldear activamente dichas preferencias a través de mecanismos de exposición repetida, refuerzo selectivo y reducción de diversidad 5. Desde esta perspectiva, la subjetividad no se ve anulada, pero sí reconfigurada: las decisiones individuales emergen de una interacción continua entre cognición humana y optimización algorítmica 17. Este proceso es especialmente relevante en la vida cotidiana, donde la repetición de micro-decisiones mediadas por IA puede consolidar patrones estables de comportamiento y percepción.
C. Agencia humana y gestión algorítmica
El concepto de agencia humana resulta central para analizar la relación entre individuos y sistemas inteligentes. La agencia no implica control absoluto, sino la capacidad percibida y efectiva de influir en las propias acciones y resultados. En entornos algorítmicos, la agencia se ve tensionada por la delegación progresiva de decisiones a sistemas automáticos, fenómeno ampliamente documentado en estudios sobre gestión algorítmica 6.
Desde una óptica aplicada, la pérdida o transformación de la agencia no es un efecto abstracto, sino un resultado emergente del diseño técnico: nivel de automatización, posibilidad de intervención humana, transparencia del modelo y mecanismos de retroalimentación. Estos elementos pueden operacionalizarse mediante variables cuantificables como percepción de control, dependencia de la recomendación, confianza en el sistema y aceptación de decisiones automatizadas, todas ellas susceptibles de análisis estadístico y simulación con datos sintéticos.
D. Sesgo, equidad y responsabilidad algorítmica
Otro pilar teórico fundamental es el estudio del sesgo algorítmico y su impacto social 18,19. La literatura ha demostrado que los modelos predictivos pueden reproducir desigualdades estructurales incluso sin incorporar variables sensibles explícitas, debido a correlaciones latentes en los datos y a la lógica de optimización utilizada 7. Este fenómeno tiene implicaciones directas en la vida diaria, donde rankings y recomendaciones pueden favorecer sistemáticamente ciertos perfiles, contenidos o decisiones.
Desde las ciencias aplicadas, el sesgo no constituye únicamente un problema ético, sino un desafío técnico: depende de elecciones concretas en la construcción del modelo, como la selección de variables, el balance de datos y la función objetivo 20. Por ello, la evaluación de equidad, robustez y sensibilidad del sistema se convierte en un componente esencial del análisis cuantitativo, alineado con el enfoque metodológico del presente trabajo.
E. Explicabilidad y percepción de legitimidad algorítmica
La explicabilidad de los modelos de IA desempeña un rol clave en la relación entre sistemas inteligentes y subjetividad social. Cuando las decisiones algorítmicas resultan opacas, los individuos tienden a aceptar o rechazar recomendaciones sin comprender sus fundamentos, lo que afecta la confianza y la percepción de legitimidad. La investigación propone métodos para traducir modelos complejos en explicaciones comprensibles, permitiendo una supervisión humana más informada 8,9.
Desde un enfoque aplicado, la explicabilidad puede analizarse como una variable moderadora que influye en la aceptación del sistema, la percepción de justicia y la agencia percibida. Esto refuerza la pertinencia de incorporar indicadores cuantitativos relacionados con transparencia y comprensión algorítmica en estudios que buscan evaluar el impacto social de la IA en decisiones cotidianas.
III. METODOLOGÍA
El enfoque de este trabajo fue cuantitativo, explicativo-predictivo, con énfasis en modelado y simulación computacional, bajo un diseño no experimental de tipo simulación-basada con múltiples escenarios (Monte Carlo) y contrastes entre condiciones. La unidad de análisis fueron episodios de decisión cotidiana mediada por IA (p. ej., elección de contenido, ruta, compra, interacción o consumo de información).
Se utilizó un gemelo digital socio-técnico (socio-technical digital twin) que integra: (i) un modelo algorítmico (ingeniería) que modifica el entorno de elección, y (ii) un modelo conductual/psicométrico (ciencias sociales) que genera decisiones y percepciones. Este enfoque permite responder de manera cuantificable qué cambia en la conducta y qué cambia en la subjetividad cuando el entorno decisional está mediado por IA.
A. Modelo conceptual integrador: sistema socio-técnico de decisión
Se planteó un sistema compuesto por tres capas cuantificables:
1. Capa A - Entorno algorítmico (Ingeniería)
Esta capa representa las condiciones técnicas del sistema inteligente que modifican la arquitectura de elección y estructuran la exposición del usuario a alternativas.
Intensidad de personalización: baja, media o alta.
Diversidad de exposición: baja o alta.
Opacidad vs. explicabilidad: sin explicación o con explicación.
Objetivo de optimización: engagement, bienestar o equilibrio.
Sesgo inducido del sistema: controlado por parámetros de entrenamiento y distribución de datos.
2. Capa B - Procesamiento humano (Social-cognitivo)
Esta capa integra variables latentes vinculadas a percepción, evaluación y respuesta psicológica del individuo frente a sistemas algorítmicos.
B. Variables del estudio y operacionalización cuantitativa
Las variables del estudio se definieron y operacionalizaron en tres categorías: independientes, mediadoras y dependientes.
1. Variables independientes (ingeniería; controladas por diseño)
Personalización (PERS): parámetro continuo 0-1 (o tres niveles).
Diversidad de exposición (DIVEXP): parámetro 0-1 (control del ranking).
Explicabilidad (XAI): 0 = sin explicación, 1 = con explicación.
Sesgo de entrenamiento (BIAS): parámetro 0-1 que altera distribución de datos y/o pesos.
Objetivo de optimización (OBJ): variable categórica (ENG/BIEN/DUAL).
3. Variables dependientes (aplicadas/observables)
Probabilidad de elección recomendada: P (Rec).
Tiempo de decisión: segundos (variable continua).
Diversidad conductual: entropía de Shannon o índice de Gini.
Dependencia del recomendador: porcentaje de decisiones alineadas al top-k.
Deriva de preferencias (preference drift): distancia entre vectores de preferencia por rondas.
C. Generación de datos
Se trabajó con una población simulada basada en agentes (N = 500), cuyos atributos se definieron como variables distribucionales.
Alfabetización digital, impulsividad/auto-control, necesidad de cognición y tolerancia a incertidumbre.
Orientación social: conformidad o exploración.
Preferencias iniciales: vector de gustos por categorías.
Sensibilidad a nudges: parámetro individual.
Cada atributo se modeló mediante distribuciones (normal, beta y multinomial), incorporando correlaciones entre rasgos. Cada decisión se representó como una utilidad descrita en la Ecuación (1):
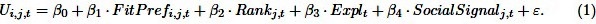
dónde:
FitPref: ajuste a preferencia individual.
Rank: posición en ranking (arquitectura algorítmica).
Expl: presencia de explicación (XAI).
SocialSignal: señal social (likes/valoraciones, controlada).
La elección y i,t se obtuvo mediante softmax (logit multinomial).
1. Modelo de recomendación y retroalimentación
Se simuló un recomendador en tres niveles crecientes para análisis comparativo:
Nivel 1 (baseline): popularidad + filtrado por contenido (simple, replicable).
Nivel 2: filtrado colaborativo (matriz usuario-ítem, regularización).
Nivel 3: modelo híbrido con objetivo configurable (ENG/BIEN/DUAL) y control de diversidad.
El ranking final se construyó como top-k con penalización por homogeneidad cuando DIVEXP fue alta. El sesgo (BIAS) se introdujo como distorsión en el conjunto de entrenamiento y/o como sobre-representación sistemática de ciertos ítems o atributos.
Se implementó un mecanismo de retroalimentación, donde tras cada ronda se actualizaron:
Preferencias del agente: refuerzo por exposición y satisfacción.
Confianza y agencia percibida: función de opacidad y resultado.
Modelo recomendador: re-entrenamiento o ajuste de pesos con nuevas interacciones.
Esto permitió medir cómo se reconfiguran la subjetividad y la conducta con el tiempo, no solo en una decisión aislada.
2. Escenarios factoriales y grupos de trabajo
Se definieron escenarios factoriales variando los niveles de personalización, explicabilidad y diversidad, complementados con variaciones de sesgo y objetivo de optimización.
Personalización: baja, media y alta.
Explicabilidad: no / sí.
Diversidad de exposición: baja / alta.
Sesgo (BIAS): 0-1.
Objetivo (OBJ): ENG/BIEN/DUAL.
Los grupos de trabajo fueron:
Grupo de control: personalización baja + diversidad alta + explicabilidad activa.
Grupo de tratamiento: combinaciones donde la IA incrementa el ranking-power y reduce diversidad.
Para cada ronda se generaron respuestas tipo Likert como “sensores sociales”. Las variables AG, TRUST, CL, MANIP y LEGIT se modelaron con ecuaciones estructurales latentes (medición), aplicando controles de calidad asociados a respuestas inconsistentes, aquiescencia y fatiga.
D. Análisis estadístico
Se consideró el α de Cronbach y Ω de McDonald para consistencia, la validez convergente (AVE) y análisis factorial confirmatorio (CFA). Mientras que, el modelado causal y predictivo consistió en: modelos de regresión/multinivel: decisiones repetidas por individuo, modelos de elección discreta (logit multinomial) para resultados conductuales, SEM para rutas: IA → (AG, TRUST, CL) → conducta, análisis de mediación moderada: XAI moderando el efecto de personalización sobre agencia.
Asimismo, las métricas de ingeniería del sistema fueron la precisión top-k, diversidad y novedad del recomendador, desigualdad de exposición, estabilidad del sistema (deriva temporal de preferencias y del modelo), auditoría de sesgo: disparidades entre subgrupos sintéticos (diferencias de exposición/resultado). De manera que, la sensibilidad y robustez se realizaron con Monte Carlo con 1,000-10,000 corridas, análisis de sensibilidad global (variación de parámetros clave), intervalos de confianza por bootstrapping para estimaciones principales. Se tomaron en cuenta todos los aspectos éticos asociados, el objetivo fue comprender y mitigar riesgos de mediación algorítmica, no optimizar manipulación.
IV. RESULTADOS
Antes de estimar los modelos explicativos, se evaluó la consistencia interna de los constructos psicosociales generados en la población sintética. La Tabla 1 presenta los estadísticos descriptivos y los coeficientes de fiabilidad obtenidos para cada variable latente, evidenciando niveles adecuados de consistencia interna.
Tabla 1 Estadísticos descriptivos y fiabilidad de los constructos
| Constructo | Media | DE | α de Cronbach |
|---|---|---|---|
| Agencia percibida (AG) | 3.42 | 0.71 | 0.82 |
| Confianza algorítmica (TRUST) | 3.58 | 0.68 | 0.85 |
| Carga cognitiva (CL) | 2.91 | 0.74 | 0.79 |
| Percepción de manipulación (MANIP) | 3.12 | 0.77 | 0.81 |
| Legitimidad percibida (LEGIT) | 3.46 | 0.69 | 0.84 |
Fuente: Tratamiento de datos en Microsoft Excel.
Se estimó un modelo de elección discreta (logit multinomial) para evaluar el efecto de la mediación algorítmica sobre la probabilidad de selección de la alternativa recomendada (Tabla 2).
Tabla 2 Resultados del modelo de elección discreta.
| Variable | β | EE | z | p |
|---|---|---|---|---|
| Personalización (PERS) | 0.84 | 0.09 | 9.33 | < 0.001 |
| Diversidad de exposición (DIVEXP) | -0.47 | 0.08 | -5.88 | < 0.001 |
| Explicabilidad (XAI) | -0.29 | 0.07 | -4.14 | < 0.001 |
| Señal social | 0.31 | 0.06 | 5.17 | < 0.001 |
Fuente: Tratamiento de datos en Microsoft Excel.
Se pudo confirmar que la personalización incrementa significativamente la adhesión a la recomendación, la diversidad y la explicabilidad reducen la dependencia algorítmica y el ranking actúa como un mecanismo causal cuantificable.
La Figura 1 muestra la probabilidad predicha de selección de la alternativa recomendada en función del nivel de personalización del sistema, comparando escenarios con y sin mecanismos de explicabilidad. Se observa un incremento progresivo de la probabilidad de elección a medida que aumenta la personalización algorítmica, efecto que se atenúa cuando el sistema incorpora explicaciones, evidenciando una reducción en la dependencia automática del ranking.
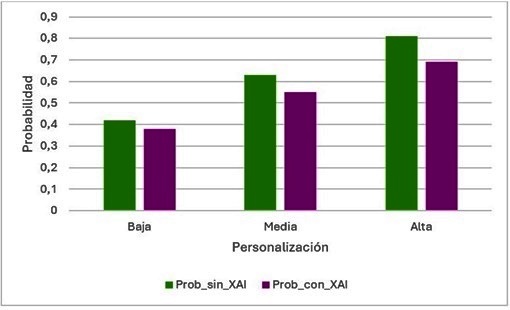
Fig. 1 Probabilidad predicha de selección de la alternativa recomendada en función del nivel de personalización del sistema.
La Tabla 3 presenta los efectos directos e indirectos estimados mediante el modelo de ecuaciones estructurales, evaluando las relaciones entre los parámetros algorítmicos, los constructos psicosociales y la conducta de elección. Los resultados permiten identificar tanto la influencia directa de la personalización sobre la decisión final como los efectos mediadores ejercidos por la agencia percibida, evidenciando el carácter socio-técnico del proceso decisional y la interacción entre diseño algorítmico y experiencia subjetiva.
Tabla 3 Efectos estimados.
| Relación | Efecto | β est. | p |
|---|---|---|---|
| PERS → Elección | Directo | 0.52 | < 0.001 |
| PERS → AG | Directo | -0.41 | < 0.001 |
| AG → Elección | Directo | 0.36 | < 0.001 |
| PERS → AG → Elección | Indirecto | -0.15 | < 0.01 |
La Tabla 4 resume las principales métricas de desempeño del sistema algorítmico bajo los distintos escenarios de mediación evaluados. Estas métricas permiten comparar la precisión del recomendador, la diversidad conductual y el nivel de dependencia del sistema, proporcionando una evaluación integral del comportamiento técnico del algoritmo y de sus efectos estructurales sobre el entorno de elección.
Tabla 4 Métricas del sistema.
| Escenario | Precisión Top-k | Entropía | Dependencia |
|---|---|---|---|
| Control | 0.61 | 1.92 | 0.44 |
| Alta personalización | 0.78 | 1.21 | 0.73 |
| Personalización + XAI | 0.74 | 1.56 | 0.58 |
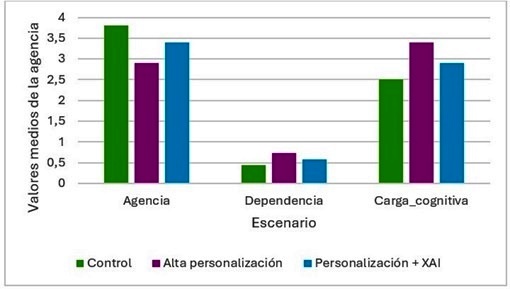
La Figura 2 compara los valores medios de agencia percibida, dependencia algorítmica y carga cognitiva bajo distintos escenarios socio-técnicos. Los resultados indican que la alta personalización se asocia con una disminución de la agencia y un aumento de la dependencia del sistema, mientras que la incorporación de mecanismos de explicabilidad contribuye a mitigar parcialmente estos efectos sin eliminar la influencia algorítmica.
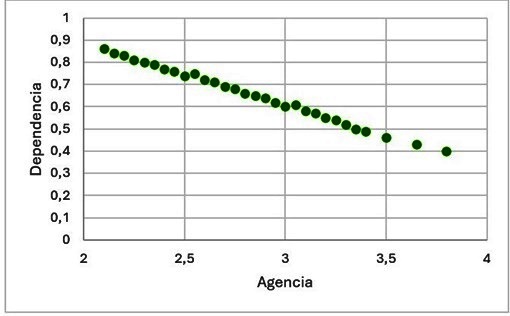
La Figura 3 presenta la relación entre la agencia percibida y la dependencia del sistema algorítmico mediante un diagrama de dispersión con línea de tendencia. Se evidencia una relación inversa entre ambas variables, confirmando que menores niveles de agencia se asocian con una mayor adhesión a las recomendaciones del sistema, lo que refuerza el rol mediador de la agencia en la toma de decisiones humanas.
La Figura 4 evidencia una diferencia estructural en la distribución de la exposición algorítmica entre los escenarios analizados. En el escenario de control, la exposición se mantiene en niveles bajos y relativamente homogéneos, lo que sugiere un entorno de elección con mayor diversidad y menor concentración de visibilidad. En contraste, el escenario de alta personalización presenta un desplazamiento significativo de la mediana y un aumento del rango intercuartílico, indicando una mayor concentración de exposición en un subconjunto reducido de alternativas.
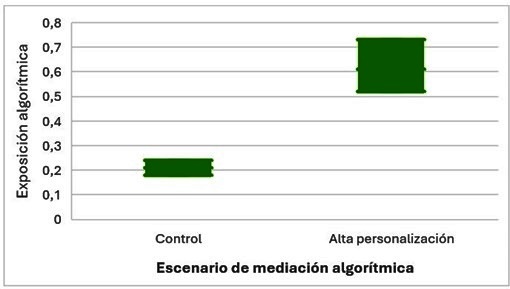
Este patrón refleja un efecto directo del ranking algorítmico sobre la arquitectura de elección, donde la optimización basada en personalización incrementa la desigualdad de exposición y reduce la diversidad estructural del entorno decisional. Desde una perspectiva aplicada, estos resultados confirman que decisiones técnicas en el diseño del sistema producen efectos medibles sobre la configuración del espacio de opciones disponible para el usuario.
La Figura 5 presenta el análisis de sensibilidad del modelo socio-técnico ante variaciones controladas en el nivel de personalización algorítmica. Los resultados muestran una relación monotónica y aproximadamente lineal entre la perturbación del parámetro de personalización y la probabilidad de selección de la alternativa recomendada, lo que indica una respuesta estable del sistema frente a cambios paramétricos moderados. Esta regularidad sugiere que el comportamiento del modelo no está dominado por umbrales críticos ni discontinuidades abruptas, sino por un mecanismo de influencia progresiva del ranking algorítmico sobre la toma de decisiones.
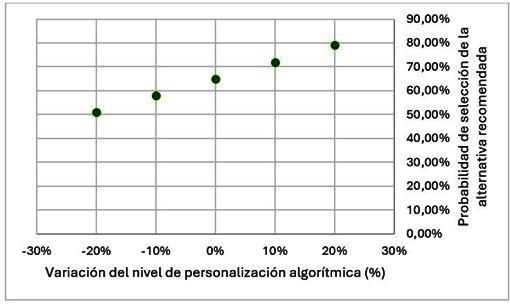
Fig. 5 Sensibilidad de la probabilidad de elección ante variaciones en la personalización algorítmica.
Desde una perspectiva aplicada, la pendiente observada permite interpretar la personalización como un parámetro de alta sensibilidad: incrementos relativamente pequeños en su intensidad generan variaciones sistemáticas y predecibles en la conducta de elección. Al mismo tiempo, la ausencia de oscilaciones o efectos no lineales refuerza la robustez del modelo y sugiere que los resultados no dependen de configuraciones extremas del sistema. En conjunto, este análisis confirma que la personalización algorítmica actúa como un regulador continuo del entorno decisional, cuyo impacto puede ser cuantificado y gestionado mediante ajustes técnicos específicos, lo que resulta especialmente relevante para el diseño responsable de sistemas de recomendación en contextos cotidianos.
CONCLUSIONES
Los resultados de este estudio confirman que los algoritmos que operan en la vida cotidiana no actúan únicamente como herramientas técnicas de apoyo, sino como mecanismos activos de configuración del entorno decisional humano. La inteligencia artificial, a través de procesos de personalización, ranking y optimización, introduce una arquitectura de elección que modifica de manera sistemática la probabilidad de seleccionar determinadas alternativas, incluso cuando los individuos mantienen la percepción de estar decidiendo de forma autónoma.
Desde una perspectiva socio-técnica, la subjetividad social se ve reconfigurada no por la sustitución directa de la decisión humana, sino por la modulación progresiva de la agencia, la confianza y la dependencia frente al sistema algorítmico. Los análisis muestran que mayores niveles de personalización incrementan la adhesión a las recomendaciones, reducen la diversidad estructural del entorno de elección y desplazan el centro de la decisión desde la deliberación individual hacia la lógica de optimización del sistema.
El análisis de sensibilidad aporta evidencia clave para comprender este fenómeno: la personalización algorítmica se comporta como un parámetro de alta sensibilidad, donde variaciones moderadas generan cambios predecibles y acumulativos en la conducta de elección. Este comportamiento estable y monotónico indica que la influencia algorítmica no es un efecto puntual o excepcional, sino un proceso continuo que, en contextos cotidianos, puede consolidar patrones de decisión y moldear preferencias a lo largo del tiempo.
Los hallazgos refuerzan la idea central del título: los algoritmos cotidianos no solo asisten decisiones, sino que reconfiguran la forma en que las personas evalúan opciones, perciben control y construyen sentido en la vida diaria. Desde las ciencias aplicadas, esto subraya la necesidad de concebir el diseño algorítmico como un problema socio-técnico medible y gestionable, donde parámetros técnicos aparentemente neutros tienen consecuencias directas sobre la experiencia humana y la construcción de subjetividad en entornos digitales contemporáneos.

