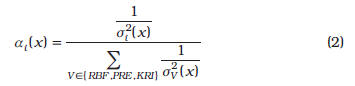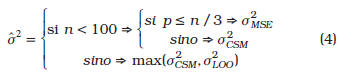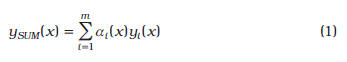
<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0254-0770</journal-id>
<journal-title><![CDATA[Revista Técnica de la Facultad de Ingeniería Universidad del Zulia]]></journal-title>
<abbrev-journal-title><![CDATA[Rev. Téc. Ing. Univ. Zulia]]></abbrev-journal-title>
<issn>0254-0770</issn>
<publisher>
<publisher-name><![CDATA[Facultad de Ingeniería, Universidad del Zulia]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0254-07702012000100008</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Adaptive ensemble of metamodels for the solution of modelling and global optimization problems]]></article-title>
<article-title xml:lang="en"><![CDATA[Ensamble adaptativo de metamodelos para la solución de problemas de modelado y optimización global]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Finol]]></surname>
<given-names><![CDATA[Daniel E]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[Néstor V]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad del Zulia Facultad de Ingeniería Instituto de Cálculo Aplicado]]></institution>
<addr-line><![CDATA[Maracaibo ]]></addr-line>
<country>Venezuela</country>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>04</month>
<year>2012</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>04</month>
<year>2012</year>
</pub-date>
<volume>35</volume>
<numero>1</numero>
<fpage>061</fpage>
<lpage>070</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_arttext&amp;pid=S0254-07702012000100008&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_abstract&amp;pid=S0254-07702012000100008&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_pdf&amp;pid=S0254-07702012000100008&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="en"><p><![CDATA[The metamodeling approach is increasingly popular and has been shown to be useful in the analysis and optimization of computationally expensive simulation-based models in, for example, the aerospace, automotive and oil industries. Nevertheless, the problem of finding a metamodel that approximates a function (the original numeric model) from a sample of points (data), is inverse and nonlinear so that there are frequently multiple models that offer a reasonable fit to the data. This work proposes a method of modeling and global optimization with restrictions using an adaptive ensemble of metamodels (i.e., Radial Basis Functions, Kriging and Polynomial Regression), and its effectiveness is assessed comparing its performance (on 6 recognized test functions and an industrial application) with the individual use of the members of the ensemble. The performance of the proposed ensemble was robust: i) the average R2 per sample size is one of the two highest with one of the two smallest variances (modeling) and ii) in most case studies the metamodel exhibited one of the two best results (modeling and optimization).]]></p></abstract>
<abstract abstract-type="short" xml:lang="es"><p><![CDATA[El enfoque de metamodelos es cada vez más popular y ha mostrado ser útil en el análisis y optimización de modelos computacionalmente costosos basados en simulaciones en, por ejemplo, las industrias petrolera, aeroespacial y automotriz. Sin embargo, el problema de encontrar un metamodelo que aproxime una función (el modelo numérico original) a partir de una muestra de puntos (datos), es inverso y no lineal de manera que con frecuencia existen múltiples metamodelos que ofrecen un razonable ajuste de los datos. Este trabajo ofrece una metodología para realizar modelado y optimización global con restricciones, usando un ensamble adaptativo de metamodelos (i.e., Funciones de Base Radial, Kriging y Regresión Polinómica), y su efectividad es evaluada comparando su desempeño (sobre 6 reconocidas funciones de prueba y una aplicación industrial) con el del uso aislado de los miembros del ensamble. El desempeño del enfoque de ensamble propuesto fue robusto: i) el promedio de R2 calculado por tamaño de muestra es uno de los dos mayores con una de las dos menores varianzas (modelado) y ii) es el único de los metamodelos que, en general, presenta uno de los dos mejores resultados en cada uno de los casos de estudio (modelado y optimización).]]></p></abstract>
<kwd-group>
<kwd lng="en"><![CDATA[optimization]]></kwd>
<kwd lng="en"><![CDATA[ensemble of metamodels]]></kwd>
<kwd lng="en"><![CDATA[radial basis functions]]></kwd>
<kwd lng="en"><![CDATA[kriging]]></kwd>
<kwd lng="en"><![CDATA[polynomial regression]]></kwd>
<kwd lng="es"><![CDATA[optimización]]></kwd>
<kwd lng="es"><![CDATA[ensamble de metamodelos]]></kwd>
<kwd lng="es"><![CDATA[funciones de base radial]]></kwd>
<kwd lng="es"><![CDATA[kriging]]></kwd>
<kwd lng="es"><![CDATA[regresión polinómica]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[ <p align="center"><font face="Verdana"><b>  Adaptive ensemble of metamodels for the solution  of modelling and global optimization problems</b></font></p>     <p align="center"><font face="Verdana" size="2"><b>  Ensamble adaptativo de metamodelos  para la solución de problemas de modelado  y optimización global</b></font></p>     <p align="center"><font face="Verdana" size="2">  Daniel E. Finol, Néstor V. Queipo</font></p>     <p align="center"><font face="Verdana" size="2">  Instituto de Cálculo Aplicado, Facultad de Ingeniería, Universidad del Zulia,  Apartado 526.  Maracaibo 4011-A, Venezuela. Telex LUZ-R-VE-64287. Tlf. (0261)7598701  Fax(0261)7512214. dfinol, <a href="mailto:nqueipo@ica.luz.ve">nqueipo@ica.luz.ve</a></font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Abstract</b></font></p>     <p align="justify"><font face="Verdana" size="2">  The metamodeling approach is increasingly popular and has been shown to be  useful in the analysis  and optimization of computationally expensive simulation-based models in, for  example, the aerospace,  automotive and oil industries. Nevertheless, the problem of finding a metamodel  that approximates a  function (the original numeric model) from a sample of points (data), is inverse  and nonlinear so that there  are frequently multiple models that offer a reasonable fit to the data. This  work proposes a method of  modeling and global optimization with restrictions using an adaptive ensemble of  metamodels (i.e., Radial  Basis Functions, Kriging and Polynomial Regression), and its effectiveness is  assessed comparing its  performance (on 6 recognized test functions and an industrial application) with  the individual use of the  members of the ensemble. The performance of the proposed ensemble was robust: i)  the average R2 per  sample size is one of the two highest with one of the two smallest variances (modeling)  and ii) in most case  studies the metamodel exhibited one of the two best results (modeling and  optimization).</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Keywords: </b>optimization, ensemble of metamodels, radial basis functions,  kriging, polynomial  regression.</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Resumen</b></font></p>     <p align="justify"><font face="Verdana" size="2">  El enfoque de metamodelos es cada vez más popular y ha mostrado ser útil en el  análisis y optimización  de modelos computacionalmente costosos basados en simulaciones en, por ejemplo,  las industrias  petrolera, aeroespacial y automotriz. Sin embargo, el problema de encontrar un  metamodelo que aproxime  una función (el modelo numérico original) a partir de una muestra de puntos  (datos), es inverso y no lineal  de manera que con frecuencia existen múltiples metamodelos que ofrecen un  razonable ajuste de los  datos. Este trabajo ofrece una metodología para realizar modelado y optimización  global con restricciones,  usando un ensamble adaptativo de metamodelos (i.e., Funciones de Base Radial,  Kriging y Regresión Polinómica),  y su efectividad es evaluada comparando su desempeño (sobre 6 reconocidas  funciones de prueba  y una aplicación industrial) con el del uso aislado de los miembros del  ensamble. El desempeño del enfoque  de ensamble propuesto fue robusto: i) el promedio de R2 calculado por tamaño de  muestra es uno de  los dos mayores con una de las dos menores varianzas (modelado) y ii) es el  único de los metamodelos que,  en general, presenta uno de los dos mejores resultados en cada uno de los casos  de estudio (modelado y  optimización).</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Palabras clave: </b>optimización, ensamble de metamodelos, funciones de base  radial, kriging,  regresión polinómica.</font></p>     ]]></body>
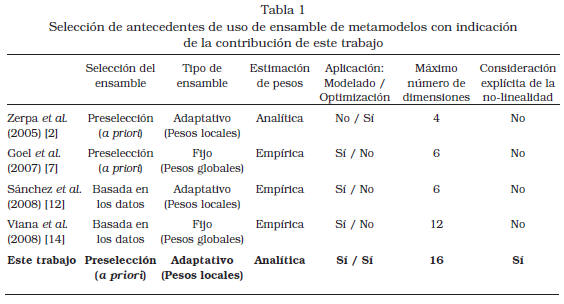
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">    <b>Introducción</b></font></p>     <p align="justify"><font face="Verdana" size="2">  El enfoque de metamodelos es cada vez más  popular y ha mostrado ser útil en el análisis y optimización  de modelos computacionalmente costosos  basados en simulaciones en, por ejemplo,  las industrias petrolera [1, 2, 3, 4], aeroespacial  [5] y automotriz [6]. Un metamodelo hace referencia  a la idea de construir un modelo alternativo  rápido (sustituto) a partir de datos de simulaciones  numéricas. Sin embargo, el problema de encontrar  un metamodelo que aproxime una función  (el modelo numérico original) a partir de una  muestra de puntos (datos), es inverso y no lineal  de manera que con frecuencia existen múltiples  metamodelos que ofrecen un razonable ajuste de  los datos. El diseñador entonces enfrenta el problema  de seleccionar un metamodelo pues, dependiendo  del problema, un esquema particular  de modelado (e.g. Regresión Polinómica, Splines,  Funciones de Base Radial, o Kriging) puede ser  mejor que los otros y, en general, no se sabe a  priori cuál debe ser seleccionado [7, 8].  Dos estrategias han sido utilizadas en la selección  de metamodelos: (1) seleccionar un metamodelo  particular de un conjunto de candidatos  [9, 10, 11] o (2) construir un ensamble de los metamodelos  disponibles (promedio ponderado) con  pesos calculados en base a medidas de desempeño  globales [7] o locales [2, 12].</font></p>     <p align="justify"><font face="Verdana" size="2">  El enfoque de ensamble de metamodelos es  una valiosa alternativa para resolver el problema  de la selección del metamodelo, y hay evidencia  de que puede proveer mejor capacidad promedio  de predicción que usar un metamodelo aislado  (e.g., [13]); en particular, es atractiva la variante  que pondera (pesos) los metamodelos usando  medidas de desempeño locales (varianza del  error) considerando que el mejor desempeño en  regiones del espacio de entrada puede ser exhibido  por distintos metamodelos. Zerpa et al. [2]  usaron una estimación analítica de la varianza  del error como medida local de desempeño en la  solución de un problema de optimización, mientras  que Sánchez et al. [12] calcularon la varianza  del error de forma empírica, en el contexto de problemas  de modelado. Ambos se limitaron a casos  de estudio de dimensiones cuatro [2] y seis [12] y  no tomaron en consideración de manera explícita  el grado de no-linealidad de los mismos.</font></p>     <p align="justify"><font face="Verdana" size="2">  Por otra parte, en el área de optimización no  se ha establecido suficientemente si los resultados  del enfoque basado en ensamble de metamodelos  son mejores a los obtenidos usando metamodelos  de manera aislada [2]. Nótese que Zerpa  et al. [2] usaron un ensamble adaptativo de metamodelos  pero la evaluación estuvo limitada a un  solo caso de estudio de baja dimensionalidad. Una  evaluación más completa permitiría establecer el  potencial del enfoque de ensamble adaptativo de  metamodelos para la solución de problemas complejos  de modelado y optimización en ingeniería.</font></p>     <p align="justify"><font face="Verdana" size="2">  Este trabajo ofrece una metodología para  realizar modelado y optimización global con restricciones  usando un ensamble adaptativo de  metamodelos, considerando reconocidas funciones  de prueba de hasta dimensión 16 y de manera  explícita su nivel de no-linealidad (<a href="#t1">Tabla 1</a>).</font></p>     <p align="justify"><font face="Verdana" size="2">  Además, en contraste con Zerpa et al. [2] se evaluó  empíricamente la confiabilidad de las estimaciones  analíticas de la varianza del error de los  metamodelos considerados, cuyos valores pueden  estar significativamente sesgados y afectar la  calidad del ensamble.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>  Ensamble adaptativo  de metamodelos</b></font></p>     <p align="justify"><font face="Verdana" size="2">  El ensamble adaptativo de interés en este  trabajo puede formularse mediante la expresión:</font></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.1.jpg" width="347" height="62"></font></p>     
<p align="justify"><font face="Verdana" size="2">  donde<img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.2.gif" width="34" height="23"> representa el  peso del i-ésimo metamodelo  en el punto x, <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.3.gif" width="36" height="21"> es la  predicción del  i-ésimo metamodelo en el punto x, y m es el número  de metamodelos. Específicamente los metamodelos  considerados en este trabajo son:</font></p>     
]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">  Funciones de Base Radial (RBF), Regresión Polinómica  (PRE) y Kriging (KRI) y los pesos se calculan  de la siguiente manera:</font></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.4.jpg" width="355" height="86"></font></p>     
<p align="justify"><font face="Verdana" size="2">  donde <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.5.gif" width="39" height="27"> es la estimación  de la varianza del  error del metamodelo “i” en el punto x. Nótese que  el peso de la predicción de cada metamodelo en el  ensamble difiere según el punto de pronóstico  considerado (adaptativo) y es inversamente proporcional  a la varianza (estimada) de su error.  A continuación se describen aspectos fundamentales  de cada uno de los metamodelos utilizados,  consideraciones sobre la estimación de  la varianza del error de los metamodelos y detalles  de la implementación de enfoque de ensamble  de metamodelos propuesto.</font></p>     
<p align="justify"><font face="Verdana" size="2">  <b>Metamodelos</b></font></p>     <p align="justify"><font face="Verdana" size="2">  Cada uno de los metamodelos usados es un  caso especial de la siguiente expresión:  <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.6.jpg" width="342" height="54"></font></p>     
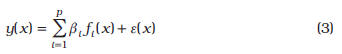
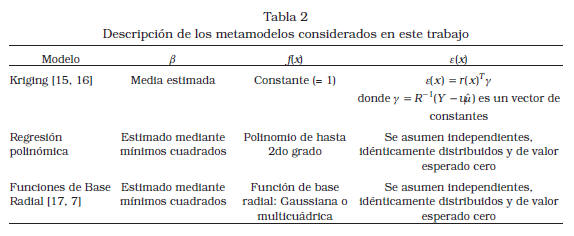
<p align="justify"><font face="Verdana" size="2">  La <a href="#t2">Tabla 2</a> muestra las características de  cada uno de los metamodelos usados.  En la expresión para <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.7.gif" width="30" height="18">  de Kriging, R es la  matriz de correlaciones entre los puntos de la  muestra, Y el vector de los valores de la función  en la muestra, u es un vector de unos, <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.8.gif" width="14" height="21">  es la estimación  de máxima verosimilitud de la media y  r(x) es el vector de correlaciones entre x y cada  punto de la muestra. La correlación es modelada  con una de distintas funciones parametrizadas  (i.e., modelo Gaussiano, exponencial, exponencial  generalizado, spline o esférico).</font></p>     
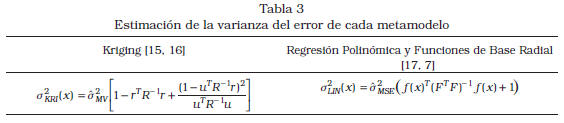
<p align="justify"><font face="Verdana" size="2"><b>  Estimación de la varianza del error  de los metamodelos</b></font></p>     <p align="justify"><font face="Verdana" size="2">  La <a href="#t3">Tabla 3</a> especifica la función que proporciona  la varianza estimada del error de cada metamodelo  en cada punto del espacio.</font></p>     <p align="justify"><font face="Verdana" size="2">  En la expresión del estimador de la varianza  de Kriging, <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.9.gif" width="32" height="26">es el  estimador de máxima verosimilitud  de la varianza del error (global). En la expresión  para PRE y RBF, f (x) es el vector donde  cada uno de sus elementos es una función de regresión  evaluada en x; F es la matriz de diseño  cuyos elementos son las funciones de regresión  evaluadas en los puntos de la muestra; y <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.10.gif" width="36" height="24"> es  el estimador estándar de la varianza del error  (usualmente conocido como Mean Square Error o,  también, “Estimador Insesgado de la Varianza”).  Para metamodelos lineales el estimador <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.11.gif" width="36" height="24"> viene  dado por SSE / (n – p); donde SSE es la suma  del cuadrado de los errores, n el tamaño de la  muestra y p el número de parámetros libres del  metamodelo.</font></p>     
<p align="justify"><a name="t1"></a></p>     ]]></body>
<body><![CDATA[<p align="center"><font face="Verdana" size="2">  <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.12.jpg" width="564" height="304"></font></p>     
<p align="justify"><a name="t2"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.13.jpg"></p>     
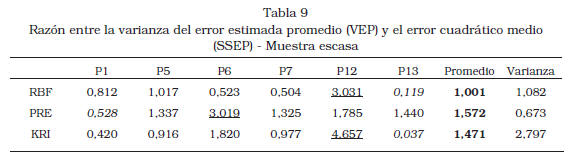
<p align="justify"><font face="Verdana" size="2">  Para evaluar la confiabilidad de los estimadores  de la varianza del error, se comparó el promedio  de las estimaciones de las varianzas con el  promedio del cuadrado de los errores sobre un  conjunto de prueba suficientemente amplio. Diferencias  significativas en los promedios citados  implican estimadores poco confiables, lo que  puede resultar en asignaciones inadecuadas de   los pesos en el ensamble de metamodelos; esto  ocurrió particularmente con el estimador de la  varianza del error de los metamodelos RBF.  Específicamente, se observó que la estimación de  RBF de la varianza puntual del error presentaba,  en general, valores significativamente por debajo  del error cuadrático correspondiente (sesgo).  Este sesgo era mayor que los observados para los  otros métodos, lo que resultaría en una asignación  inadecuada de los pesos. Para resolver este  problema se experimentó con otros estimadores  de la varianza global <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.14.gif" width="23" height="20">  hasta encontrar uno  apropiado, el cual se describe a continuación:</font></p>     
<p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.15.jpg" width="341" height="82"></font></p>     
<p align="justify"><font face="Verdana" size="2">  donde n es el tamaño de la muestra, p la dimensionalidad,  <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.16.gif" width="36" height="24">es el estimador de  validacióncruzada  tipo Dejar-Uno-Afuera (Leave-One-Out)  para metamodelos lineales y <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.17.gif" width="37" height="22">representa el  estimador usado en los criterios de selección del  modelo conocidos como Criterio de Información  Bayesiana y Validación Cruzada Generalizada  [17].</font></p>     
<p align="justify">&nbsp;</p>     <p align="justify"><a name="t3"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.18.jpg" width="564" height="123"></p>     
<p align="justify"><font face="Verdana" size="2">  <b>Implementación</b></font></p>     ]]></body>
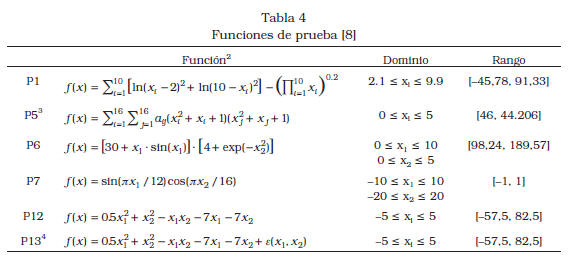
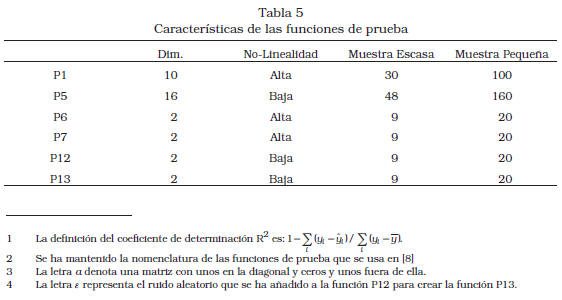
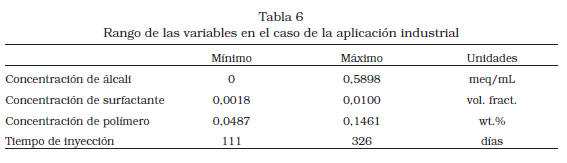
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">  El enfoque propuesto de ensamble adaptativo  de metamodelos fue codificado en el ambiente  de programación MATLAB [18]. Específicamente,  los metamodelos utilizados correspondientes  a Regresión Polinómica fueron los provistos  por MATLAB; mientras que en el caso de Kriging  y Funciones de Base Radial se usaron las herramientas  DACE [16] y RBF2-Toolbox [17], respectivamente.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>  Casos de estudio</b></font></p>     <p align="justify"><font face="Verdana" size="2">  Se seleccionaron seis reconocidas funciones  de prueba (<a href="#t4">Tabla 4</a>) y una aplicación industrial  que difieren en cuanto a su dimensionalidad  y grado de no-linealidad. En la <a href="#t5">Tabla 5</a> se especifica  la dimensión, grado de no-linealidad (alta y  baja) y los tamaños de muestra usados (escasa y  pequeña), para cada problema; las funciones de  prueba fueron etiquetadas como de alta o baja  no-linealidad, según que el R2 (coeficiente de determinación)1 de una regresión polinómica de  primer o segundo grado fuera menor (alta) o mayor  (baja) a 0,99 [8].</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Aplicación industrial:</b> Optimización de  proceso de inyección de ASP (álcali-surfactante-  polímero) [2, 12, 19].</font></p>     <p align="justify"><font face="Verdana" size="2">  La recuperación mejorada de petróleo utilizando  ASP es uno de los métodos más promisorios  para enfrentar uno de los retos más importantes  de la industria petrolera: luego de métodos  convencionales de recuperación por inyección de  agua, el petróleo atrapado en el yacimiento puede  ser hasta el 70% del petróleo originalmente en el  yacimiento (POES). Este problema considera un  proyecto a escala de campo (13 pozos, 9 productores  y 4 inyectores; POES estimado en 395.427  barriles) con las siguientes variables de diseño: la  concentración de cada uno de los compuestos  químicos: álcali, surfactante y polímero; y el  tiempo de inyección [2]; los rangos de estas variables  son descritos en la <a href="#t6">Tabla 6</a>.</font></p>     <p align="center"><a name="t4"></a></p>     <p align="center"><font face="Verdana" size="2"><b>  <img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.19.jpg" width="568" height="262"></b></font></p>     
<p align="center"><a name="t5"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.20.jpg"></p>     
<p align="center"><a name="t6"></a></p>     ]]></body>
<body><![CDATA[<p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.21.jpg"></p>     
<p align="justify"><font face="Verdana" size="2">  La función objetivo es la producción acumulada  de petróleo para un horizonte de 487 días  medida como porcentaje del POES y es evaluada  utilizando el simulador UTCHEM de la Universidad  de Texas [20]. Detalles adicionales de este  caso de estudio se encuentran en [2].</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Metodología de evaluación  y medidas de desempeño</b></font></p>     <p align="justify"><font face="Verdana" size="2">  La evaluación fue realizada mediante los siguientes  pasos:</font></p>     <p align="justify"><font face="Verdana" size="2"><b>  1. Diseño del experimento y muestreo.</b> Obtener  el conjunto de puntos iniciales (muestra)  para cada problema y tamaño de muestra,  mediante el método conocido como hipercubo  latino [21] y evaluarlos en el modelo  original. Para cada función de prueba se  escogieron dos muestras: Escasa y Pequeña,  tal como se describe en la <a href="#t5">Tabla 5</a>.</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>2. Construcción de metamodelos.</b> Se construye  cada metamodelo estimando sus parámetros  a partir de la muestra. El ensamble  de metamodelos, como se describió en la  sección Ensamble adaptativo de metamodelos,  es evaluado a partir de los metamodelos  individuales y sus estimaciones de la  varianza del error.</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>3. Optimización basada en metamodelos.</b>  El algoritmo de optimización utilizado es de  naturaleza global denominado DIRECT  (DIviding RECTangles) [22]. Nótese que el  número de evaluaciones de la función objetivo  no es un aspecto computacionalmente  crítico en virtud de que la optimización está  basada en el uso de metamodelos. Los métodos  basados en gradiente (como el de  Newton, etc.), aunque más eficientes, sólo  encuentran óptimos locales.</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>4. Cálculo de medidas de desempeño.</b> Para  evaluar el enfoque propuesto en términos  de modelado se utilizó el coeficiente de determinación  R2 sobre conjuntos de prueba  suficientemente amplios (entre 1600 y  2000 puntos) y en términos de optimización  se calculó la diferencia entre el valor del óptimo  encontrado utilizando el metamodelo  y su verdadero valor. Nótese que mayores  valores de R2 y menores diferencias con el  óptimo indican mejor desempeño.</font></p>     <p align="justify"><font face="Verdana" size="2">  <b>Análisis y discusión  de resultados</b></font></p>     <p align="justify"><font face="Verdana" size="2">  Los resultados obtenidos se discuten en  términos del desempeño en materia de modelado  y optimización del ensamble de metamodelos sobre  los casos de estudio.</font></p>     ]]></body>
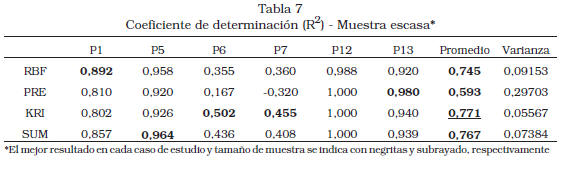
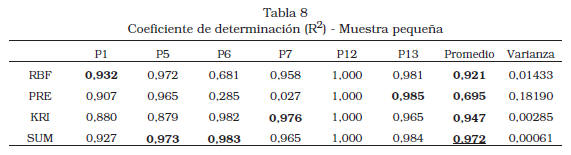
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">  <b>Modelado</b></font></p>     <p align="justify"><font face="Verdana" size="2">  El ensamble (SUM) obtiene uno de los dos  mejores resultados en todos los casos de estudio  (<a href="#t7">Tabla 7</a> y la <a href="#t8">Tabla 8</a>) excepto el correspondiente a  P13-‘muestra escasa’; este último caso coincide  con el de mayor desequilibrio (diferencia de VEP/SSEP5 entre metamodelos) entre las estimaciones  de la varianza del error de los metamometamodelos (RBF, PRE, KRI y SUM) es el  mejor  en alguno de los problemas (RBF: P1; PRE: P13;  KRI: P6-‘muestra escasa’ y P7; SUM: P5 y  P6-‘muestra pequeña’), y el mayor R2 promedio lo  obtienen, en el caso de muestra escasa, Kriging y,  en el caso de la muestra pequeña, el ensamble. El  ensamble de metamodelos ofreció un valor de R2  30,2% mayor que el promedio de los metamodelos  individuales en la muestra escasa, y 17,6%  mayor en la muestra pequeña. Además, la varianza  de R2 para SUM fue la segunda menor en  el caso de la muestra escasa (0,07384) y la menor  con la muestra pequeña (0,00061).</font></p>     <p align="justify"><a name="t7"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.22.jpg" width="564" height="170"></p>     
<p align="center"><a name="t8"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.23.jpg" width="571" height="155"></p>     
<p align="center"><a name="t9"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.24.jpg" width="569" height="160"></p>     
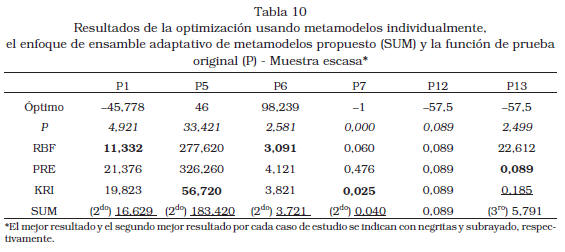
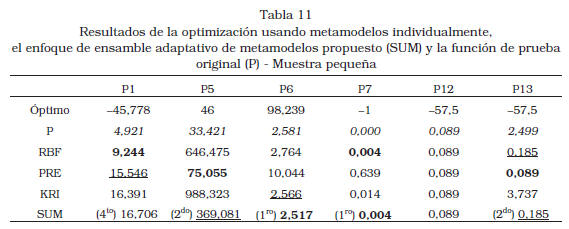
<p align="justify"><font face="Verdana" size="2">  <b>Optimización</b></font></p>     <p align="justify"><font face="Verdana" size="2">  Distintos metamodelos ofrecen los mejores  resultados dependiendo del problema considerado;  sin embargo, el ensamble de metamodelos  (SUM) presenta uno de los dos mejores resultados  de optimización en la mayoría los casos (10  de 12). La <a href="#t10">Tabla 10</a> y la <a href="#t11">Tabla 11</a> muestran el óptimo  de cada función, y su diferencia con el óptimo  obtenido utilizando el algoritmo DIRECT y cada  uno de los metamodelos (RBF, KRI, PRE y SUM).</font></p>     ]]></body>
<body><![CDATA[<p align="justify"><a name="t10"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.25.jpg"></p>     
<p align="justify"><a name="t11"></a></p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.26.jpg"></p>     
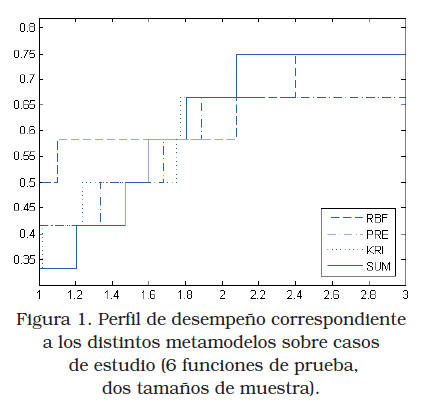
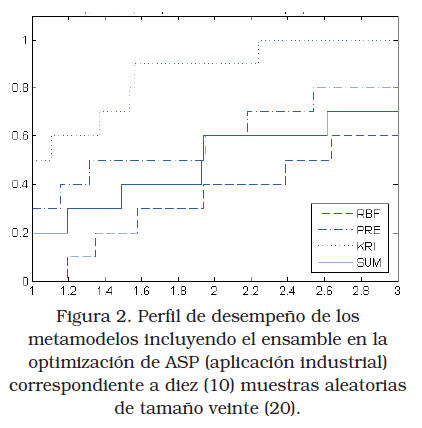
<p align="justify"><font face="Verdana" size="2">  Además, se incluye el óptimo obtenido utilizando  la función original (denotado P en la tabla).  A manera de resumen la <a href="#f1">Figura 1</a> ilustra el  desempeño relativo de los distintos metamodelos  utilizando la metodología conocida como perfil de  desempeño (performance profile) reportada en  [23] y [24]. El citado perfil reporta para cada metamodelo  la fracción (ordenada) del total de casos  de estudio (12; 6 funciones de prueba con 2 tamaños  de muestra) donde el error (diferencia entre  el verdadero óptimo y el obtenido) estuvo dentro de una tolerancia dada  (abscisa); esta tolerancia  representa un múltiplo del mínimo error obtenido  en cada caso. Dependiendo de la tolerancia  distintos metamodelos exhiben un mejor desempeño;  sin embargo, el ensamble presenta un perfil  de desempeño robusto, vale decir, a partir de  una tolerancia de 1,8 ningún otro metamodelo lo  supera en número de casos de estudio exitosos.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>  Aplicación industrial</b></font></p>     <p align="justify"><font face="Verdana" size="2">  Para el caso ASP se realizaron optimizaciones  basadas en metamodelos (KRI, PRE, RBF y  SUM) para diez (10) muestras aleatorias de tamaño  veinte (20), y se calcularon los errores con respecto  al óptimo verdadero, i.e., porcentaje del  POES = 39,81%, con cada punto porcentual representando 3.954 barriles de  petróleo; el perfil  de desempeño de los metamodelos se muestra en  la <a href="#f2">Figura 2</a>. El desempeño del ensamble exhibe  las siguientes características: i) estuvo entre los  dos mejores en tres de las diez muestras y en ningún  caso ofreció el peor resultado y ii) ofreció el  valor óptimo más cercano al verdadero (38,7%)  con el peor resultado asociado con el metamodelo  RBF (23,66%). Puede observarse que el uso de  ensamble para obtener un desempeño robusto  en la optimización basada en metamodelos puede  fortalecerse, con mínimo costo computacional,  incorporando la evaluación de los óptimos de  los metamodelos individuales.</font></p>     <p align="justify"><font face="Verdana" size="2"><b><a name="f1"></a></b></font> </p>     <p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.27.jpg" width="422" height="403"></p>     
<p align="center"><a name="f2"></a></p>     ]]></body>
<body><![CDATA[<p align="center"><img border="0" src="/img/fbpe/rtfiuz/v35n1/art08.28.jpg"></p>     
<p align="justify"><font face="Verdana" size="2">  <b>Conclusiones</b></font></p>     <p align="justify"><font face="Verdana" size="2">  La conclusión general de este trabajo es que  el uso de un ensamble de metamodelos puede ser  un mecanismo efectivo y robusto para el modelado  y optimización de procesos complejos y representa  una alternativa valiosa al uso de metamodelos  de manera aislada. Específicamente, el desempeño  del enfoque de ensamble propuesto  (SUM) fue robusto: i) el promedio de R2 calculado  por tamaño de muestra es uno de los dos mayores  exhibiendo una de las dos menores varianzas  (modelado), ii) es el único de los metamodelos  que, en general, en cada caso de estudio, presenta  uno de los dos mejores resultados y no ofrece el  peor de los resultados (modelado y optimización)  y iii) excepto en casos extremos, no se vio significativamente  afectado por desequilibrios de las  estimaciones de la varianza del error de los metamodelos.</font></p>     <p align="justify"><font face="Verdana" size="2">  Algunos aspectos a considerar en futuros  trabajos en esta área son: a) establecer un mecanismo  para el cálculo de los pesos que tome en  cuenta la correlación entre los metamodelos (la  expresión utilizada es óptima sólo si los metamodelos  no están correlacionados), b) desarrollar  estimaciones de la varianza del error de los metamodelos  más ajustadas a la realidad, y c) evaluar  más ampliamente el enfoque propuesto utilizando,  otros metamodelos (e.g., máquinas de vectores  de soporte) en el ensamble y otras aplicaciones  industriales.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>  Referencias bibliográficas</b></font></p>     <p align="justify"><font face="Verdana" size="2">  &nbsp;1. Queipo N., Goicochea J., y  Pintos S.: “Surrogate  modeling-based optimization of SAGD  processes”, Journal of Petroleum Science  and Engineering, Vol. 35, No. 1-2, Julio  (2002) 83-93.  &nbsp;</font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">2. Zerpa L., Queipo N., Pintos  S., Salager J.: “An  optimization methodology of alkalinesurfactant-  polymer flooding processes using  field scale numerical simulation and multiple  surrogates”, Journal of Petroleum Science  and Engineering 47 (2005) 197-208.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2382595&pid=S0254-0770201200010000800002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref -->  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">3. Queipo N., Verde A., Canelón  J., y Pintos S.:  “Efficient Global Optimization of Hydraulic  Fracturing Designs”, Journal of Petroleum  Science and Engineering Vol. 35 No. 3-4  (2002) 151-166.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">4. Queipo N., Pintos S., Rincón  N., Contreras N.  y Colmenares J.: “Surrogate modeling-based  optimization for the integration of static and  dynamic data into a reservoir description”,  Journal of Petroleum Science and Engineering,  Vol. 35 No. 3-4 (2002) 167-181.  &nbsp;</font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">5. Queipo N., Haftka R., Shyy  W., Goel T.,  Vaidyanathan R., Tucker P.: “Surrogatebased  analysis and optimization”, Progress  in Aerospace Sciences, Vol. 41, No. 1. (January  2005), 1-28.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">6. Craig KJ., Stander N., Dooge  DA., Varadappa  S.: “MDO of automotive vehicles for crashworthiness  using response surface methods”,  9th AIAA/ISSMO symposium on  multidisciplinary analysis and optimization,  Atlanta, GA, AIAA Paper 2002-5607.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">7. Goel T., Haftka R., Shyy W.,  Queipo.; “Ensemble  of Surrogates”. Structural and  Multidisciplinary Optimization. Vol. 33, No.  3 (2007) 199-216.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">8. Jin R., Chen W., Simpson T.:  “Comparative  Studies of Metamodeling Techniques Under  Multiple Modeling Criteria”, Journal of  Structural Optimization, Vol. 23, No. 1  (2000) 1-13.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">9. Buckland ST., Burnham KP.,  Augustin NH.:  “Model selection: an integral part of inference”,  Biometrics 53 (1997): 275-290.  &nbsp;</font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">10. Hoeting J., Madigan D.,  Raftery A., Volinsky  C.T.: “Bayesian model averaging: a tutorial”,  Statistical Science 14 (4) (1999):382-417.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2382604&pid=S0254-0770201200010000800008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref -->  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">11. Kass R.E., Raftery A.E.:  “Bayes factors”,  Journal of the American Statistical Association  90 (1995):773-795 Chapman &amp; Hall, FL,  (1993) pp. 126-142.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">12. Sánchez E., Pintos S.,  Queipo N.: “Toward an  optimal ensemble of kernel based approximations  with engineering applications”,  Structural and Multidisciplinary Optimization  36(3), (2008) pp. 247-267.  &nbsp;</font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">13. Madigan D., Raftery A.:  “Model selection and  accounting for model uncertainty in graphic  models using Occam’s window”, Journal of  the American Statistical Association 89  (1994):1535-1546.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2382608&pid=S0254-0770201200010000800011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref -->  &nbsp;</font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">14. Viana F., Haftka R.,  Steffen V., Butkewitsch  S., Leal M.: “Ensemble of Surrogates: a  Framework based on Minimization of the  Mean Integrated Square Error”, Structures  Structural Dynamics and Materials. (2008)  AIAA 2008-1885.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2382610&pid=S0254-0770201200010000800012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref -->  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">15. Sacks, J., Welch, W.,  Mitchell, T., Wynn, H.,  “Design and Analysis of Computer Experiments”,  Statistical Science, Vol. 4, No. 4  (1989) 409-435.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">16. Lophaven, S., Nielsen H.,  Sondergaard, J.,  “DACE A Matlab Kriging Toolbox Version  2.0”, Technical Report IMM-TR-2002-12,  Technical University of Denmark (2002).  &nbsp;</font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">17. Orr, J., &quot;Introduction to  Radial Basis Function  Networks&quot;. Technical Report, Center for  Cognitive Science, University of Edinburgh.  (1996). <a href="http://anc.ed.ac.uk/rbf/rbf.html"> http://anc.ed.ac.uk/rbf/rbf.html</a>  &nbsp;    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2382614&pid=S0254-0770201200010000800014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --></font></p>     <p align="justify"><font face="Verdana" size="2">18. MATLAB® The language of  technical computing,  Versión 7.5, The MathWorks Inc.,  2007.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">19. Nava E., Pintos S., y  Queipo N. “A  geostatistical perspective for the surrogate-  based integration of variable fidelity  models”. Journal of Petroleum Science and  Engineering, (2010) 71: 56-66.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">20. UTCHEM-9.0 (2000) Utchem-9.0  a three-dimensional  chemical flood simulator http://  www.cpge.utexas.edu/utchem/ (Jul)  &nbsp;</font></p>     ]]></body>
<body><![CDATA[<!-- ref --><p align="justify"><font face="Verdana" size="2">21. McKay M.D., Beckman R.J.,  Conover W.J.:  “A Comparison of Three Methods for Selecting  Values of Input Variables in the Analysis  of Output from a Computer Code”,  Technometrics (American Statistical Association)  21 (2) (1979): 239-245.    &nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2382619&pid=S0254-0770201200010000800016&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref -->  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">22. Jones D., Perttunen C.,  Stuckman B.:  “Lipschitzian optimization without the  lipschitz constant”, Journal of Optimization  Theory and Application, 79 (1993), pp.  157-181.</font></p>     <p align="justify"><font face="Verdana" size="2">  23. Dolan E., More J.J. “Benchmarking optimization  software with performance profile.  Mathematical Programing”, Mathematical  Programing 91: 201213 (2002).  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">24. Higham D.J., Higham N.J.  MATLAB Guide.  SIAM, Philadelphia, 2005. Second Edition.  &nbsp;</font></p>     <p align="justify"><font face="Verdana" size="2">Recibido el 8 de Enero de 2010  En forma revisada el 17 de Octubre de 2011  &nbsp;</font></p>       ]]></body>
<back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Goicochea]]></surname>
<given-names><![CDATA[J.]]></given-names>
</name>
<name>
<surname><![CDATA[Pintos]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Surrogate modeling-based optimization of SAGD processes]]></article-title>
<source><![CDATA[Journal of Petroleum Science and Engineering]]></source>
<year>Juli</year>
<month>o </month>
<day>20</day>
<volume>35</volume>
<numero>1-2</numero>
<issue>1-2</issue>
<page-range>83-93</page-range></nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Zerpa]]></surname>
<given-names><![CDATA[L.]]></given-names>
</name>
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Pintos]]></surname>
<given-names><![CDATA[S.]]></given-names>
</name>
<name>
<surname><![CDATA[Salager]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[An optimization methodology of alkalinesurfactant-polymer flooding processes using field scale numerical simulation and multiple surrogates]]></article-title>
<source><![CDATA[Journal of Petroleum Science and]]></source>
<year>2005</year>
<volume>Engineering</volume>
<numero>47</numero>
<issue>47</issue>
<page-range>197-208</page-range></nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Verde]]></surname>
<given-names><![CDATA[A.]]></given-names>
</name>
<name>
<surname><![CDATA[Canelón]]></surname>
<given-names><![CDATA[J.]]></given-names>
</name>
<name>
<surname><![CDATA[Pintos]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Efficient Global Optimization of Hydraulic Fracturing Designs]]></article-title>
<source><![CDATA[Journal of Petroleum Science and Engineering]]></source>
<year>2002</year>
<volume>35</volume>
<numero>3-4</numero>
<issue>3-4</issue>
<page-range>151-166</page-range></nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Pintos]]></surname>
<given-names><![CDATA[S.]]></given-names>
</name>
<name>
<surname><![CDATA[Rincón]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Contreras]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Colmenares]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Surrogate modeling-based optimization for the integration of static and dynamic data into a reservoir description]]></article-title>
<source><![CDATA[Journal of Petroleum Science and Engineering]]></source>
<year>2002</year>
<volume>35</volume>
<numero>3-4</numero>
<issue>3-4</issue>
<page-range>167-181</page-range></nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N.]]></given-names>
</name>
<name>
<surname><![CDATA[Haftka]]></surname>
<given-names><![CDATA[R.]]></given-names>
</name>
<name>
<surname><![CDATA[Shyy]]></surname>
<given-names><![CDATA[W.]]></given-names>
</name>
<name>
<surname><![CDATA[Goel]]></surname>
<given-names><![CDATA[T.]]></given-names>
</name>
<name>
<surname><![CDATA[Vaidyanathan]]></surname>
<given-names><![CDATA[R.]]></given-names>
</name>
<name>
<surname><![CDATA[Tucker]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Surrogatebased analysis and optimization]]></article-title>
<source><![CDATA[Progress in Aerospace Sciences]]></source>
<year>Janu</year>
<month>ar</month>
<day>y </day>
<volume>41</volume>
<numero>1</numero>
<issue>1</issue>
<page-range>1-28</page-range></nlm-citation>
</ref>
<ref id="B6">
<label>7</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Goel]]></surname>
<given-names><![CDATA[T.]]></given-names>
</name>
<name>
<surname><![CDATA[Haftka]]></surname>
<given-names><![CDATA[R.]]></given-names>
</name>
<name>
<surname><![CDATA[Shyy]]></surname>
<given-names><![CDATA[W., Queipo]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Ensemble of Surrogates]]></article-title>
<source><![CDATA[Structural and Multidisciplinary Optimization]]></source>
<year>2007</year>
<volume>33</volume>
<numero>3</numero>
<issue>3</issue>
<page-range>199-216</page-range></nlm-citation>
</ref>
<ref id="B7">
<label>8</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Jin]]></surname>
<given-names><![CDATA[R.]]></given-names>
</name>
<name>
<surname><![CDATA[Chen]]></surname>
<given-names><![CDATA[W.]]></given-names>
</name>
<name>
<surname><![CDATA[Simpson]]></surname>
<given-names><![CDATA[T]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Comparative Studies of Metamodeling Techniques Under Multiple Modeling Criteria]]></article-title>
<source><![CDATA[Journal of Structural Optimization]]></source>
<year>2000</year>
<volume>23</volume>
<numero>1</numero>
<issue>1</issue>
<page-range>1-13</page-range></nlm-citation>
</ref>
<ref id="B8">
<label>10</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hoeting]]></surname>
<given-names><![CDATA[J.]]></given-names>
</name>
<name>
<surname><![CDATA[Madigan]]></surname>
<given-names><![CDATA[D.]]></given-names>
</name>
<name>
<surname><![CDATA[Raftery]]></surname>
<given-names><![CDATA[A.]]></given-names>
</name>
<name>
<surname><![CDATA[Volinsky]]></surname>
<given-names><![CDATA[C.T]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bayesian model averaging: a tutorial]]></article-title>
<source><![CDATA[Statistical Science]]></source>
<year>1999</year>
<volume>14</volume>
<numero>4</numero>
<issue>4</issue>
<page-range>382-417</page-range></nlm-citation>
</ref>
<ref id="B9">
<label>11</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Kass]]></surname>
<given-names><![CDATA[R.E.]]></given-names>
</name>
<name>
<surname><![CDATA[Raftery]]></surname>
<given-names><![CDATA[A.E]]></given-names>
</name>
</person-group>
<source><![CDATA[Bayes factors Journal of the American Statistical Association]]></source>
<year>1995</year>
<publisher-name><![CDATA[90, 773-795]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B10">
<label>12</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Sánchez]]></surname>
<given-names><![CDATA[E.]]></given-names>
</name>
<name>
<surname><![CDATA[Pintos]]></surname>
<given-names><![CDATA[S.]]></given-names>
</name>
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Toward an optimal ensemble of kernel based approximations with engineering applications]]></article-title>
<source><![CDATA[Structural and Multidisciplinary Optimization]]></source>
<year>2008</year>
<volume>36</volume>
<numero>3</numero>
<issue>3</issue>
<page-range>247-267</page-range></nlm-citation>
</ref>
<ref id="B11">
<label>13</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Madigan]]></surname>
<given-names><![CDATA[D.]]></given-names>
</name>
<name>
<surname><![CDATA[Raftery]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Model selection and accounting for model uncertainty in graphic models using Occam’s window]]></article-title>
<source><![CDATA[Journal of the American Statistical]]></source>
<year>1994</year>
<volume>Association</volume>
<numero>89</numero>
<issue>89</issue>
<page-range>1535-1546</page-range></nlm-citation>
</ref>
<ref id="B12">
<label>14</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Viana]]></surname>
<given-names><![CDATA[F.]]></given-names>
</name>
<name>
<surname><![CDATA[Haftka]]></surname>
<given-names><![CDATA[R.]]></given-names>
</name>
<name>
<surname><![CDATA[Steffen]]></surname>
<given-names><![CDATA[V.]]></given-names>
</name>
<name>
<surname><![CDATA[Butkewitsch]]></surname>
<given-names><![CDATA[S.]]></given-names>
</name>
<name>
<surname><![CDATA[Leal]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Ensemble of Surrogates: a Framework based on Minimization of the Mean Integrated Square Error]]></article-title>
<source><![CDATA[Structures Structural Dynamics and]]></source>
<year>2008</year>
<volume>Materials</volume>
<numero>2008AIAA</numero>
<issue>2008AIAA</issue>
<page-range>1885</page-range></nlm-citation>
</ref>
<ref id="B13">
<label>15</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Sacks,]]></surname>
<given-names><![CDATA[J.]]></given-names>
</name>
<name>
<surname><![CDATA[Welch,]]></surname>
<given-names><![CDATA[W.]]></given-names>
</name>
<name>
<surname><![CDATA[Mitchell,]]></surname>
<given-names><![CDATA[T.]]></given-names>
</name>
<name>
<surname><![CDATA[Wynn,]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Design and Analysis of Computer Experiments]]></article-title>
<source><![CDATA[Statistical Science]]></source>
<year>1989</year>
<volume>4</volume>
<numero>4</numero>
<issue>4</issue>
<page-range>409-435</page-range></nlm-citation>
</ref>
<ref id="B14">
<label>17</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Orr,]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<source><![CDATA[Introduction to Radial Basis Function Networks]]></source>
<year>1996</year>
<publisher-name><![CDATA[Technical Report, Center for Cognitive Science, University of Edinburgh]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B15">
<label>19</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Nava]]></surname>
<given-names><![CDATA[E.]]></given-names>
</name>
<name>
<surname><![CDATA[Pintos]]></surname>
<given-names><![CDATA[S.]]></given-names>
</name>
<name>
<surname><![CDATA[Queipo]]></surname>
<given-names><![CDATA[N]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A geostatistical perspective for the surrogate- based integration of variable fidelity models]]></article-title>
<source><![CDATA[Journal of Petroleum Science and Engineering]]></source>
<year>2010</year>
<volume>71</volume>
<page-range>56-66</page-range></nlm-citation>
</ref>
<ref id="B16">
<label>21</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[McKay]]></surname>
<given-names><![CDATA[M.D.]]></given-names>
</name>
<name>
<surname><![CDATA[Beckman]]></surname>
<given-names><![CDATA[R.J.]]></given-names>
</name>
<name>
<surname><![CDATA[Conover]]></surname>
<given-names><![CDATA[W.J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A Comparison of Three Methods for Selecting Values of Input Variables in the Analysis of Output from a Computer Code]]></article-title>
<source><![CDATA[Technometrics (American Statistical Association)]]></source>
<year>1979</year>
<volume>21</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>239-245</page-range></nlm-citation>
</ref>
<ref id="B17">
<label>22</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Jones]]></surname>
<given-names><![CDATA[D.]]></given-names>
</name>
<name>
<surname><![CDATA[Perttunen]]></surname>
<given-names><![CDATA[C.]]></given-names>
</name>
<name>
<surname><![CDATA[Stuckman]]></surname>
<given-names><![CDATA[B]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Lipschitzian optimization without the lipschitz constant]]></article-title>
<source><![CDATA[Journal of Optimization Theory and]]></source>
<year>1993</year>
<volume>Application</volume>
<numero>79</numero>
<issue>79</issue>
<page-range>157-181</page-range></nlm-citation>
</ref>
<ref id="B18">
<label>23</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Dolan]]></surname>
<given-names><![CDATA[E.]]></given-names>
</name>
<name>
<surname><![CDATA[More]]></surname>
<given-names><![CDATA[J.J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Benchmarking optimization software with performance profile]]></article-title>
<source><![CDATA[Mathematical Programing. Mathematical]]></source>
<year>2002</year>
<volume>Programing</volume>
<numero>91</numero>
<issue>91</issue>
<page-range>201-213</page-range></nlm-citation>
</ref>
<ref id="B19">
<label>24</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Higham]]></surname>
<given-names><![CDATA[D.J.]]></given-names>
</name>
<name>
<surname><![CDATA[Higham]]></surname>
<given-names><![CDATA[N.J]]></given-names>
</name>
</person-group>
<source><![CDATA[MATLAB Guide]]></source>
<year>2005</year>
<publisher-name><![CDATA[SIAM, Philadelphia, Second Edition]]></publisher-name>
</nlm-citation>
</ref>
</ref-list>
</back>
</article>