<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0378-1844</journal-id>
<journal-title><![CDATA[Interciencia]]></journal-title>
<abbrev-journal-title><![CDATA[INCI]]></abbrev-journal-title>
<issn>0378-1844</issn>
<publisher>
<publisher-name><![CDATA[ASOCIACIÓN INTERCIENCIA]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0378-18442006000800008</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Biodiversidad: Inferencia basada en el índice de Shannon y la riqueza]]></article-title>
<article-title xml:lang="en"><![CDATA[Biodiversity: Inference about richness and Shannon index]]></article-title>
<article-title xml:lang="pt"><![CDATA[Biodiversidade: Inferência baseada no índice de Shannon e a riqueza]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[Laura]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad Nacional Experimental Francisco de Miranda  ]]></institution>
<addr-line><![CDATA[Coro ]]></addr-line>
<country>Venezuela</country>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>08</month>
<year>2006</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>08</month>
<year>2006</year>
</pub-date>
<volume>31</volume>
<numero>8</numero>
<fpage>583</fpage>
<lpage>590</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_arttext&amp;pid=S0378-18442006000800008&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_abstract&amp;pid=S0378-18442006000800008&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_pdf&amp;pid=S0378-18442006000800008&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[Se describen los estimadores puntuales y por intervalos de confianza (IC) de la riqueza y del índice de Shannon; se aplican a un ejemplo con datos de vegetación y a otro con conteo de aves, y se comparan los resultados obtenidos sobre la base de simulaciones originales y de consideraciones teóricas. Se ofrecen recomendaciones para la aplicación de la técnica de remuestreo adecuada, con énfasis en casos de muestras pequeñas o sin repeticiones. Se orienta también en el uso del software disponible.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[Point estimators and confidence intervals for richness and Shannon index are described and applied to a vegetation example and a bird inventory survey. Results of various techniques are compared based on original simulation performance and theoretical formulation conditions. A guide to proceed with emphasis on small real data set and bootstrap estimation is provided, including available software use orientation.]]></p></abstract>
<abstract abstract-type="short" xml:lang="pt"><p><![CDATA[Descrevem-se os estimadores pontuais e por intervalos de confiança (IC) da riqueza e do índice de Shannon; se aplicam a um exemplo com dados de vegetação e a outro com contagem de aves, e se comparam aos resultados obtidos sobre a base de simulações originais e de considerações teóricas. Oferecem-se recomendações para a aplicação da técnica de reamostragem adequada, com ênfase em casos de amostras pequenas ou sem repetições. Orienta-se também no uso do software disponível.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[Bootstrap]]></kwd>
<kwd lng="es"><![CDATA[Diversidad Biológica]]></kwd>
<kwd lng="es"><![CDATA[Intervalo de Confianza]]></kwd>
<kwd lng="es"><![CDATA[Remuestreo]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[   <B>    <P align="center"><font face="Verdana" size="3">BIODIVERSIDAD: INFERENCIA BASADA EN EL &Iacute;NDICE DE SHANNON Y LA RIQUEZA</font></P>     <P align="center"><font face="Verdana" size="2">Laura Pla</font></P> </B>     <P align="justify"><font face="Verdana" size="2">Laura Pla.</font><B> <font face="Verdana" size="2"> Magister Scientiarum en Estad&iacute;stica y Doctora en Ciencias Agr&iacute;colas, Universidad Central de Venezuela. Profesora, Universidad Nacional Experimental Francisco de Miranda, Venezuela. Direcci&oacute;n:  Apartado 7434, Coro 4101, Venezuela. e-mail: laura@reacciun.ve.</font> </P>  </B>    <P align="justify"><font face="Verdana" size="2"><b>RESUMEN</b></font></P>      <P align="justify"><font face="Verdana" size="2">Se describen los estimadores puntuales y por intervalos de confianza (IC) de la riqueza y del &iacute;ndice de Shannon; se aplican a un ejemplo con datos de vegetaci&oacute;n y a otro con conteo de aves, y se comparan los resultados obtenidos sobre la base de simulaciones originales y de consideraciones te&oacute;ricas. Se ofrecen recomendaciones para la aplicaci&oacute;n de la t&eacute;cnica de remuestreo adecuada, con &eacute;nfasis en casos de muestras peque&ntilde;as o sin repeticiones. Se orienta tambi&eacute;n en el uso del software disponible.</font></P>  <B>    <P align="center"><font face="Verdana" size="2">B<span style="text-transform: uppercase">iodiversity: Inference about richness and Shannon index</span></font></P> </B>     <P align="justify"><font face="Verdana" size="2"><b>SUMMARY</b></font></P>      <P align="justify"><font face="Verdana" size="2">Point estimators and confidence intervals for richness and Shannon index are described and applied to a vegetation example and a bird inventory survey. Results of various techniques are compared based on original simulation performance and theoretical formulation conditions. A guide to proceed with emphasis on small real data set and bootstrap estimation is provided, including available software use orientation.</font></P>  <B>    <P align="center"><font face="Verdana" size="2">B<span style="text-transform: uppercase">iodiversidade: Infer<span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">ê</span>ncia baseada no &iacute;ndice de Shannon e a riqueza</span></font></P> </B>     ]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2"><b>RESUMO</b></font></P>      <P align="justify"><font face="Verdana" size="2">Descrevem-se os estimadores pontuais e por intervalos de confian&ccedil;a (IC) da riqueza e do &iacute;ndice de Shannon; se aplicam a um exemplo com dados de vegeta&ccedil;&atilde;o e a outro com contagem de aves, e se comparam aos resultados obtidos sobre a base de simula&ccedil;&otilde;es originais e de considera&ccedil;&otilde;es te&oacute;ricas. Oferecem-se recomenda&ccedil;&otilde;es para a aplica&ccedil;&atilde;o da t&eacute;cnica de reamostragem adequada, com &ecirc;nfase em casos de amostras pequenas ou sem repeti&ccedil;&otilde;es. Orienta-se tamb&eacute;m no uso do software dispon&iacute;vel.</font></P>  <B>    <P align="justify"><font face="Verdana" size="2">PALABRAS CLAVE / Bootstrap / Diversidad Biol&oacute;gica / Intervalo de Confianza / Remuestreo /</font></P> </B><FONT SIZE=2>    <P align="justify"><font face="Verdana" size="2">Recibido: 28/10/2005. Modificado: 14/07/2006. Aceptado: 18/07/2006.</font></P> </FONT><B>    <P align="justify"><font face="Verdana" size="2">Introducci&oacute;n</font></P> </B>     <P align="justify"><font face="Verdana" size="2">En estudios de biodiversidad, a partir del muestreo de comunidades, el tama&ntilde;o de la muestra o n&uacute;mero de unidades de observaci&oacute;n puede ser peque&ntilde;o, para realizar inferencia param&eacute;trica sobre la diversidad existente. No obstante, es deseable lograr estimaciones con niveles de confianza conocidos. Una alternativa a la estimaci&oacute;n param&eacute;trica para los &iacute;ndices de diversidad es la construcci&oacute;n de intervalos de confianza (IC) mediante t&eacute;cnicas de computaci&oacute;n intensiva tales como remuestreo (Pla y Matteucci, 2001), que no se basan en supuestos distribucionales.</font></P>     <P align="justify"><font face="Verdana" size="2">Este trabajo aborda el problema con un enfoque aplicado. Se describen los m&eacute;todos de estimaci&oacute;n de la biodiversidad expresada mediante la riqueza y el &iacute;ndice de Shannon, se propone un m&eacute;todo de remuestreo para la inferencia, y se discuten los resultados de dos ejemplos, orientando tambi&eacute;n en el uso del software disponible.</font></P>     <P align="justify"><font face="Verdana" size="2">En una comunidad con un n&uacute;mero total S de clases (t&iacute;picamente especies en estudios de biodiversidad) no superpuestas, identificadas por i=1, 2, ..., S, designaremos con </font><font size="2" face="Symbol">p</font><font face="Verdana" size="2"><sub>i</sub> la proporci&oacute;n de i-&eacute;sima clase. Estas clases son excluyentes, es decir que un mismo elemento o individuo no puede pertenecer a m&aacute;s de una clase, y por lo tanto los </font><font size="2" face="Symbol">p</font><font face="Verdana" size="2"><sub>i</sub> est&aacute;n sujetos a la restricci&oacute;n que</font>  <font face="Verdana" size="2"><img border="0" src="/img/fbpe/inci/v31n8/art08eca.gif" width="54" height="41">&nbsp;</font> <font face="Verdana" size="2">Si se toma una muestra aleatoria de esta comunidad, llamaremos n<sub>i</sub> al n&uacute;mero de individuos o abundancia de la clase i; si n<sub>i</sub>=0, entonces la i-&eacute;sima especie no se ha observado en la muestra. Al n&uacute;mero total de especies observadas en la muestra la llamamos r, que nunca podr&aacute; ser mayor que S.</font></P>     
<P align="justify"><font face="Verdana" size="2">Denominaremos f<sub>k</sub> al n&uacute;mero de clases con frecuencia o abundancia k y as&iacute;, el n&uacute;mero total de individuos o abundancia total (N) en la muestra puede calcularse como</font></P>     <P align="justify"><img border="0" src="/img/fbpe/inci/v31n8/art08ecb.jpg" width="94" height="55"></P>     
]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">que puede ser expresado en funci&oacute;n de los f<sub>k</sub> como</font></P>     <P align="justify"><img border="0" src="/img/fbpe/inci/v31n8/art08ecc.jpg" width="99" height="46"></P>     
<P align="justify"><font face="Verdana" size="2">recordando que el s&iacute;mbolo <span style="mso-char-type: symbol; mso-symbol-font-family: Symbol; font-size: 10.0pt; font-family: Symbol; mso-ascii-font-family: Verdana; mso-fareast-font-family: Times New Roman; mso-hansi-font-family: Verdana; mso-bidi-font-family: Times New Roman; mso-ansi-language: ES; mso-fareast-language: ES; mso-bidi-language: AR-SA">&quot; </span>indica ‘para todos los posibles valores de k’.</font></P>     <P align="justify"><font face="Verdana" size="2">Asimismo, la estimaci&oacute;n de los </font><font size="2" face="Symbol">p</font><font face="Verdana" size="2"><sub>i</sub> en una muestra aleatoria puede hacerse a partir de las frecuencias relativas como</font></P>     <P align="justify"><font face="Verdana" size="2"><a name="ec1"><img border="0" src="/img/fbpe/inci/v31n8/art08ec1.jpg" width="104" height="51"></a>&nbsp;       &nbsp;(1)</font></P>     
<P align="justify"><font face="Verdana" size="2">Los estimadores de la riqueza se basan en las frecuencias (los f<sub>k</sub>) y en el n&uacute;mero de clases o especies efectivamente observadas (r). Los estimadores de los &iacute;ndices de biodiversidad se basan directamente en las p<sub>i</sub> o frecuencias relativas de cada especie, e indirectamente en la riqueza.</font></P>  <I>    <P align="justify"><font face="Verdana" size="2">&Iacute;ndice de Shannon</font></P> </I>     <P align="justify"><font face="Verdana" size="2">Uno de los &iacute;ndices m&aacute;s utilizados para cuantificar la biodiversidad espec&iacute;fica es el de Shannon, tambi&eacute;n conocido como Shannon-Weaver (Shannon y Weaver, 1949), derivado de la teor&iacute;a de informaci&oacute;n como una medida de la entrop&iacute;a. El &iacute;ndice refleja la heterogeneidad de una comunidad sobre la base de dos factores: el n&uacute;mero de especies presentes y su abundancia relativa. Conceptualmente es una medida del grado de incertidumbre asociada a la selecci&oacute;n aleatoria de un individuo en la comunidad. Esto es, si una comunidad de S especies es muy homog&eacute;nea, por ejemplo porque existe una especie claramente dominante y las restantes S-1 especies apenas presentes, el grado de incertidumbre ser&aacute; m&aacute;s bajo que si todas las S especies fueran igualmente abundantes. O sea, al tomar al azar un individuo, en el primer caso tendremos un grado de certeza mayor (menos incertidumbre, producto de una menor entrop&iacute;a) que en el segundo; porque mientras en el primer caso la probabilidad de que pertenezca a la especie dominante ser&aacute; cercana a 1, mayor que para cualquier otra especie, en el segundo la probabilidad ser&aacute; la misma para cualquier especie.</font></P>     <P align="justify"><font face="Verdana" size="2">El &iacute;ndice de Shannon (Shannon y Weaver, 1949) se define como&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;</font></P>     <P align="justify"><font face="Verdana" size="2"><a name="ec2"><img border="0" src="/img/fbpe/inci/v31n8/art08ec2.jpg" width="133" height="55"></a>&nbsp;       (2)</font></P>      
]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">La diversidad m&aacute;xima (H<sub>max</sub>= lnS) se alcanza cuando todas las especies est&aacute;n igualmente presentes. Un &iacute;ndice de homogeneidad asociado a esta medida de diversidad puede calcularse como el cociente H/H<sub>max</sub>=H/lnS, que ser&aacute; uno si todas las especies que componen la comunidad tienen igual probabilidad (</font><font size="2" face="Symbol">p</font><font face="Verdana" size="2"><sub>i </sub>= 1/S).</font> </P>     <P align="justify"><font face="Verdana" size="2">El antilogaritmo de H (e<sup>H</sup>) cuantifica el n&uacute;mero de especies, igualmente abundantes, suficiente para producir el mismo grado de incertidumbre, o sea el mismo valor de H. Cuanto mayor sea la diferencia entre e<sup>H</sup> y S, el total de especies, menos diversa ser&aacute; la comunidad. Esta cuantificaci&oacute;n puede ser &uacute;til al comparar gr&aacute;ficos de dispersi&oacute;n del &iacute;ndice de Shannon en funci&oacute;n de la riqueza en varias comunidades. Con datos muestrales, H<sub>max</sub>=ln(r) indica qu&eacute; &iacute;ndice de diversidad de Shannon podr&iacute;a haberse alcanzado con las especies presentes, mientras S<sub>H</sub>=e<sup>H</sup> indica cu&aacute;ntas especies equiabundantes ser&iacute;an necesarias para obtener ese &iacute;ndice observado. Diferencias promedio entre estos valores potenciales y los observados pueden contribuir a la comparaci&oacute;n entre comunidades (<a href="#fig1">Figura 1</a>).</font></P>      <P align="center"><a name="fig1"><img border="0" src="/img/fbpe/inci/v31n8/art08img01.gif" width="555" height="372"></a></P>      
<P align="justify"><font face="Verdana" size="2">El uso de datos muestrales aplicando la <a href="#ec2"> Ec. 2</a> produce estimadores sesgados que subestiman siempre el valor del &iacute;ndice en la poblaci&oacute;n, especialmente cuando se trata de muestras relativamente peque&ntilde;as donde es poco probable que est&eacute;n incluidas todas las especies presentes en la comunidad. Dado que esta es la situaci&oacute;n m&aacute;s frecuente en los estudios ecol&oacute;gicos y ambientales, es necesario encontrar un procedimiento que corrija el sesgo y asocie al &iacute;ndice un nivel de incertidumbre que permita separar las fluctuaciones aleatorias no atribuibles a causas identificables, de aquellas que poseen un patr&oacute;n de comportamiento peculiar. La correcci&oacute;n del sesgo puede hacerse si se dispone de una buena (en el sentido de que se acerca al verdadero valor en la poblaci&oacute;n) estimaci&oacute;n de la riqueza.</font></P>     <P align="justify"><font face="Verdana" size="2">Generalizando, se trata de construir un intervalo de confianza con probabilidad conocida (1-</font><font size="2" face="Symbol">a</font><font face="Verdana" size="2">) para un par&aacute;metro de inter&eacute;s q, en este caso el &iacute;ndice de Shannon, del que existe un estimador calculado a partir de una muestra aleatoria x<sub>1</sub>, x<sub>2</sub>, ..., x<sub>n</sub>, tomada de la poblaci&oacute;n de inter&eacute;s, con una distribuci&oacute;n de probabilidad F desconocida, y generalmente a partir de una muestra relativamente peque&ntilde;a. Esta estimaci&oacute;n puede ser puntual cuando solo se estima un valor del &iacute;ndice o por intervalo cuando se estiman los l&iacute;mites inferior y superior con probabilidad fijada de antemano. El segundo procedimiento, m&aacute;s informativo y que permite comparaciones estad&iacute;sticamente v&aacute;lidas entre comunidades requiere la estimaci&oacute;n del &iacute;ndice y de una medida de variabilidad.</font></P>  <I>    <P align="justify"><font face="Verdana" size="2">Estimadores de la riqueza</font></P> </I>     <P align="justify"><font face="Verdana" size="2">A continuaci&oacute;n se detallan procedimientos de estimaci&oacute;n puntual de la riqueza. No se considerar&aacute;n aqu&iacute; las estimaciones asint&oacute;ticas y las basadas en curvas de rarefacci&oacute;n (Gotelli y Colwell, 2001).</font></P>     <P align="justify"><font face="Verdana" size="2">Cuando se cuantifica la riqueza observada en la muestra (r), como el n&uacute;mero total de especies presentes en ella, se obtiene siempre un l&iacute;mite inferior para la riqueza de la comunidad. Una propuesta para corregir el sesgo de esta estimaci&oacute;n se basa en el concepto de ‘cobertura muestral’ que corresponde a la proporci&oacute;n que representa la abundancia total de las especies presentes en una muestra, con relaci&oacute;n a la abundancia total de la comunidad (Good, 1953). En las dos &uacute;ltimas d&eacute;cadas se han propuesto varios estimadores de la riqueza, muchos de ellos derivados de los m&eacute;todos de estimaci&oacute;n de totales poblacionales en animales con m&eacute;todos de captura-recaptura.</font></P>      <P align="justify"><font face="Verdana" size="2">a) ACE (<I>abundance coverage estimator</I>). Chao y colaboradores (Chao y Lee, 1992; Chao <I>et al</I>., 2000) dividen las especies presentes en una muestra en abundantes (r<sub>abun</sub>: cuando tienen m&aacute;s de k individuos en la muestra) y raras (r<sub>rara</sub>: aquellas con k o menos individuos). La estimaci&oacute;n del n&uacute;mero de especies ausentes, utilizado para corregir el sesgo, se basa enteramente en las especies consideradas raras, ya que las abundantes ser&aacute;n observadas en toda muestra (Chao y Shen, 2003). El estimador propuesto es</font></P>     <P align="justify"><font face="Verdana" size="2"><a name="ec3"><img border="0" src="/img/fbpe/inci/v31n8/art08ec3.jpg" width="362" height="300"></a>&nbsp;      &nbsp;</font></P>      
]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">el coeficiente de variaci&oacute;n de la abundancia de las especies. Este estimador requiere la selecci&oacute;n <I>a priori</I> de k, y no est&aacute; definido para aquellos casos en que todas las especies raras tienen un solo individuo. Chao y Shen (2003) han sugerido fijar k=10 sobre base emp&iacute;rica.</font></P>      <P align="justify"><font face="Verdana" size="2">b) r<sub>pot</sub> (de potencia ponderada). Pla <I>et al</I>. (2004) han propuesto un estimador de naturaleza no-param&eacute;trica, que no requiere especificar par&aacute;metros de distribuci&oacute;n de las abundancias por especie, y ajusta la riqueza observada r por adici&oacute;n de la suma de las frecuencias de especies, inversamente ponderada por la potencia de su abundancia muestral,</font> </P>     <P align="justify"><font face="Verdana" size="2"><a name="ec4"><img border="0" src="/img/fbpe/inci/v31n8/art08ec4.jpg" width="160" height="65"></a>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;(4)</font></P>      
<P align="justify"><font face="Verdana" size="2">donde </font><font size="2" face="Symbol">r</font><font face="Verdana" size="2">=1/2 es un coeficiente seleccionado sobre evidencia emp&iacute;rica, f<sub>k</sub> es el n&uacute;mero de especies con k individuos en la muestra, con k=1,…, max<sub>k</sub> (abundancia m&aacute;xima observada). El t&eacute;rmino que se adiciona es la parte entera de la sumatoria. Supone que las especies de las que no se encontraron individuos en la muestra son m&aacute;s similares a aquellas con menor abundancia y no requiere fijar un valor de abundancia para separar especies raras de abundantes.</font></P>  <I>    <P align="justify"><font face="Verdana" size="2">Estimadores puntuales del &iacute;ndice de Shannon</font> </P> </I>     <P align="justify"><font face="Verdana" size="2">a) M&aacute;ximo veros&iacute;mil (MV). El estimador m&aacute;ximo veros&iacute;mil a partir de datos de la abundancia de cada especie es</font></P>      <P align="justify"><font face="Verdana" size="2"><a name="ec5"><img border="0" src="/img/fbpe/inci/v31n8/art08ec5.jpg" width="112" height="55"></a>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;(5)</font></P>      
<P align="justify"><font face="Verdana" size="2">siendo p<sub>i</sub>, el definido en la <a href="#ec1"> Ec. 1</a>. Este m&eacute;todo produce un estimador sesgado (Hutcheson, 1970), con esperanza</font></P>      <P align="justify"><font face="Verdana" size="2"><a name="ec6"><img border="0" src="/img/fbpe/inci/v31n8/art08ec6.jpg" width="182" height="53"></a>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;(6)</font></P>      
<P align="justify"><font face="Verdana" size="2">y cuando no se conoce el total de especies en la poblaci&oacute;n (S), que es el caso m&aacute;s frecuente en la pr&aacute;ctica, no es posible corregir el sesgo sin estimar a su vez el n&uacute;mero de especies presentes en la poblaci&oacute;n (Peet, 1974).</font></P>      ]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">b) M&aacute;ximo veros&iacute;mil corregido por sesgo (MVr, MV<sub>ACE</sub> y MVr<sub>pot</sub>). Se trata de ajustar el estimador puntual de la <a href="#ec5"> Ec. 5</a> sum&aacute;ndole el sesgo estimado por la <a href="#ec6"> Ec. 6</a> sustituyendo S, que es desconocida, por su estimador: la riqueza observada (r), el estimador ACE, o r<sub>pot</sub>.</font></P>      <P align="justify"><font face="Verdana" size="2">c) Basado en Horvitz-Thompson (HT). Chao y Shen (2003) combinaron la propuesta de Horvitz y Thompson (1952) para estimar el total de una poblaci&oacute;n bajo un dise&ntilde;o de muestreo no equiprobable con el concepto de ‘cobertura muestral’ para ajustar el sesgo producido por las especies no observadas. El estimador resultante puede calcularse como</font></P>      <P align="justify"><a name="ec7"><img border="0" src="/img/fbpe/inci/v31n8/art08ec7.gif" width="265" height="55"></a></P>      
<P align="justify"><font face="Verdana" size="2">siendo <img border="0" src="/img/fbpe/inci/v31n8/art08ec7a.gif" width="65" height="43"> el estimador de la ‘cobertura muestral’ basado en todas las especies. As&iacute;, si todas las especies est&aacute;n presentes con dos o m&aacute;s individuos en la muestra, &eacute;sta puede considerarse ‘completa’ en el sentido de que todas las especies est&aacute;n representadas y la estimaci&oacute;n de la cobertura muestral ser&aacute; 1 y no afectar&aacute; la estimaci&oacute;n. La diferencia con el estimador m&aacute;ximo veros&iacute;mil (<a href="#ec5">Ec. 5</a>) reside en el denominador que corresponde al ajuste basado en Horvitz-Thompson.</font></P>      
<P align="justify"><font face="Verdana" size="2">d) Ajustado emp&iacute;ricamente (HA). Propuesto por Pla (2004) para muestras con frecuencias o abundancias totales </font><font size="2" face="Symbol">£</font><font face="Verdana" size="2">2000, se basa en la estimaci&oacute;n del sesgo por <I>bootstrap</I> y su uso para corregir el sesgo del estimador m&aacute;ximo veros&iacute;mil como</font></P>      <P align="justify"><font face="Verdana" size="2"><span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA"><a name="ec8"></a>&#292;<sub>HA</sub> = 2,73&#292; - 1,75</span><span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;* + 0,0003r&nbsp;&nbsp;&nbsp; </span>(8)</font></P>      <P align="justify"><font face="Verdana" size="2">siendo <span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span> el &iacute;ndice calculado con la <a href="#ec5"> Ec. 5</a>, <span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>* la media <I>bootstrap </I>del &iacute;ndice y r la riqueza observada.</font></P>  <I>    <P align="justify"><font face="Verdana" size="2">Estimaci&oacute;n del intervalo de confianza del &iacute;ndice de Shannon</font></P> </I>     <P align="justify"><font face="Verdana" size="2">Como se ha se&ntilde;alado arriba, la definici&oacute;n de los l&iacute;mites del intervalo de confianza requiere una estimaci&oacute;n de la variabilidad aleatoria asociada a la estimaci&oacute;n. En el caso del estimador m&aacute;ximo veros&iacute;mil, la varianza puede calcularse como (Hutcheson, 1970)</font></P>      <P align="justify"><font face="Verdana" size="2"><img border="0" src="/img/fbpe/inci/v31n8/art08ec9.jpg" width="313" height="61">&nbsp;   &nbsp;(9)</font></P>      
]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">y la riqueza (S) deber&aacute; ser sustituida por su estimaci&oacute;n. Surgir&aacute;n as&iacute; tres variantes del intervalo de confianza m&aacute;ximo veros&iacute;mil seg&uacute;n se utilice r, ACE o r<sub>pot</sub>.</font></P>     <P align="justify"><font face="Verdana" size="2">Con la correcci&oacute;n por ACE, Chao (1987) ha sugerido el uso de una transformaci&oacute;n logar&iacute;tmica para ajustar los l&iacute;mites del intervalo que garantiza la obtenci&oacute;n de un l&iacute;mite inferior &gt;0. Se considera que la variable aleatoria l&nbsp;n(MV<sub>ACE</sub>-<span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>) tiene una distribuci&oacute;n que se aproxima a la normal y el l&iacute;mite inferior del IC puede calcularse como Ll=<span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>+D/L, mientras que el l&iacute;mite superior ser&aacute; LS=<span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>+D * L, siendo D=(MV<sub>ACE</sub>-<span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>) y</font> </P>      <P align="justify"><font face="Verdana" size="2"><img border="0" src="/img/fbpe/inci/v31n8/art08ec10.jpg" width="288" height="84">&nbsp;      &nbsp;(10)</font></P>      
<P align="justify"><font face="Verdana" size="2">En la discusi&oacute;n de los ejemplos podremos ver la diferencia entre estas aproximaciones.</font></P>     <P align="justify"><font face="Verdana" size="2">La estimaci&oacute;n del &iacute;ndice por Horvitz-Thompson permite el c&aacute;lculo de la varianza por aproximaci&oacute;n asint&oacute;tica como (Chao y Shen, 2003)</font></P>      <P align="justify"><img border="0" src="/img/fbpe/inci/v31n8/art08ec10a.jpg" width="317" height="62"></P>     
<P align="justify"><font face="Verdana" size="2">siendo c&ocirc;v(f<sub>i</sub>,f<sub>j</sub>)=f<sub>i</sub>(1-f<sub>i</sub>/ACE) cuando i=j, y c&ocirc;v(f<sub>i</sub>,f<sub>j</sub>)=f<sub>i</sub>f<sub>j</sub>/ACE cuando i</font><font size="2" face="Symbol">¹</font><font face="Verdana" size="2">j. Esta ecuaci&oacute;n requiere la evaluaci&oacute;n de las derivadas para cada par de individuos. Una alternativa es el uso de la estimaci&oacute;n <I>bootstrap</I> de la varianza. Comparando resultados entre ambos procedimientos no se encontraron diferencias significativas, y en este trabajo se aplic&oacute; la segunda opci&oacute;n.</font></P>     <P align="justify"><font face="Verdana" size="2">En el caso del ajuste emp&iacute;rico propuesto por Pla (2004), la construcci&oacute;n de los IC se basa en la desviaci&oacute;n est&aacute;ndar <I>bootstrap</I> y sus l&iacute;mites se calculan como <span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span><sub>HA</sub> ± z</font><font size="2"><sub><font face="Symbol">a</font><font face="Verdana">/2</font></sub></font><font face="Verdana" size="2"> sd*<sub><span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>*</sub> siendo sd*<sub><span style="font-size:10.0pt;font-family:Verdana; mso-fareast-font-family:&quot;Times New Roman&quot;;mso-bidi-font-family:&quot;Times New Roman&quot;; mso-ansi-language:ES;mso-fareast-language:ES;mso-bidi-language:AR-SA">&#292;</span>*</sub> la desviaci&oacute;n est&aacute;ndar <I>bootstrap</I> del &iacute;ndice. Para muestras con frecuencias o abundancias totales &gt;2000 se recomienda el m&eacute;todo de remuestreo corregido por el sesgo y por la aceleraci&oacute;n: BCA, por sus siglas en ingl&eacute;s (<I>bias-corrected and accelerated</I>). Mientras que con presencia de varias muestras por unidad de an&aacute;lisis o estructuras jer&aacute;rquicas de clasificaci&oacute;n se recomienda el uso del IC por BCA para el promedio (Pla y Matteucci, 2001).</font></P>  <B>    <P align="justify"><font face="Verdana" size="2">Materiales y M&eacute;todos</font></P> </B>     <P align="justify"><font face="Verdana" size="2">Se comparan los estimadores de riqueza (<a href="#ec3">Ec. 3</a> y <a href="#ec4">4</a>) y del &iacute;ndice de Shannon (<a href="#ec5">Ec. 5</a>, <a href="#ec6">6</a>, <a href="#ec7"> 7</a> y <a href="#ec8">8</a>) a trav&eacute;s de su aplicaci&oacute;n a dos conjuntos de datos, uno de vegetaci&oacute;n y otro de aves. Se presentan los dos conjuntos de datos usados y el m&eacute;todo de estimaci&oacute;n de la variabilidad por remuestreo.</font></P>  <I>    ]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">Bases de datos utilizadas</font></P>      <P align="justify"><font face="Verdana" size="2">Vegetaci&oacute;n de Falc&oacute;n</font></I><font face="Verdana" size="2">. Es una base amplia de datos de vegetaci&oacute;n y ambiente georeferenciada del estado Falc&oacute;n, Venezuela (Matteucci <I>et al</I>., 2001). Se tomaron cuatro formaciones de Beard (Matteucci, 1987): cardonales (C), cardonales secundarios (CS), espinares (E) y espinares deciduos (ED). La sub-base posee datos de abundancia de 151 especies en 37 sitios de muestreo. Las cuatro formaciones corresponden a bosques secos tropicales que han sido estudiados en su relaci&oacute;n con el ambiente en otros trabajos (Matteucci <I>et al</I>., 1999a, b).</font></P> <I>    <P align="justify"><font face="Verdana" size="2">Aves de Misiones.</font></I> <font face="Verdana" size="2"> Es una base de datos resultante del muestreo de aves en la selva atl&aacute;ntica de la Provincia de Misiones, Argentina (Giraudo <I>et al</I>., 2005). Se realizaron campa&ntilde;as en los meses de octubre, diciembre 2004 y abril 2005 en 94 unidades de observaci&oacute;n divididas en fragmentos grandes (n=53) y fragmentos peque&ntilde;os (n=41). Del total de 155 especies detectadas para toda la selva (26 generalistas y 129 exclusivas del bosque), 86 est&aacute;n tanto en los fragmentos grandes como en los peque&ntilde;os (de esas, 76 son exclusivas del bosque y 10 son generalistas). De las especies que faltan en los fragmentos grandes, 11 son generalistas y 8 exclusivas del bosque; mientras que de las especies que faltan en los fragmentos peque&ntilde;os y s&iacute; fueron detectadas en los grandes, 5 son generalistas y 45 exclusivas del bosque. La probabilidad de que en los fragmentos peque&ntilde;os falte una especie de bosque tiene un riesgo 4.55 veces mayor a que falte una especie generalista.</font></P>     <P align="justify"><font face="Verdana" size="2">Para comparar los subgrupos se aplic&oacute; la prueba no param&eacute;trica de Wilcoxon para muestras independientes, a no ser que se indique lo contrario.</font></P>  <I>    <P align="justify"><font face="Verdana" size="2">Estimaci&oacute;n por remuestreo</font></P> </I>     <P align="justify"><font face="Verdana" size="2">No es razonable suponer una distribuci&oacute;n normal y tampoco conocida para el &iacute;ndice de Shannon, por lo que no es posible aplicar m&eacute;todos param&eacute;tricos de estimaci&oacute;n por intervalos. La estimaci&oacute;n por remuestreo del &iacute;ndice de Shannon se basa en la abundancia de las especies observadas en una muestra y el &uacute;nico supuesto que debe cumplirse es que la poblaci&oacute;n de la cual provenga la muestra sea homog&eacute;nea a la escala de an&aacute;lisis seleccionada. Para aplicar m&eacute;todos de remuestreo se puede entonces asumir que la abundancia total puede subdividirse en ‘porciones unitarias’ cada una tan grande como el m&iacute;nimo tama&ntilde;o identificable (Pla, 2004), expresado en las unidades de abundancia utilizadas (&aacute;rea basal, cobertura, biomasa, frecuencia).</font></P>     <P align="justify"><font face="Verdana" size="2">As&iacute;, la abundancia de cada especie se subdivide en ni porciones unitarias que pueden ser remuestreadas. Como la abundancia se expresa en la misma escala para todas las especies, tanto en la poblaci&oacute;n como en la muestra (y en las remuestras) podemos hacer una selecci&oacute;n aleatoria de ‘porciones unitarias’ caracterizadas por la especie que se registra en ella. Estos son N objetos virtuales, que se suponen mutuamente independientes y que tienen la misma distribuci&oacute;n (no conocida) de probabilidad. Este valor de N es el que se toma en estos casos como ‘tama&ntilde;o de la muestra’. El caso m&aacute;s simple es aquel d&oacute;nde cada ‘porci&oacute;n unitaria’ corresponde a un individuo que pertenece a la especie ‘i’, el cu&aacute;l puede o no ser incluido en la muestra seg&uacute;n el resultado del remuestreo aleatorio.</font></P>     <P align="justify"><font face="Verdana" size="2">En este trabajo se us&oacute; el intervalo est&aacute;ndar por aproximaci&oacute;n normal. Esta t&eacute;cnica se basa en suponer que existe una transformaci&oacute;n monot&oacute;nica del estimador que llamaremos gen&eacute;ricamente I con una distribuci&oacute;n aproximadamente normal con media </font><font size="2" face="Symbol">m</font><font face="Verdana" size="2"> y desviaci&oacute;n est&aacute;ndar </font><font size="2" face="Symbol">s</font><font face="Verdana" size="2">; y que por lo tanto hay una probabilidad de (1-</font><font size="2" face="Symbol">a</font><font face="Verdana" size="2">) que</font></P>      <P align="justify"><font face="Verdana" size="2">I + z</font><font size="2"><sub><font face="Symbol">a</font><font face="Verdana">/2</font></sub></font><font size="2" face="Symbol">s</font><font face="Verdana" size="2"><sub>I</sub> &lt; I* &lt; I + z</font><font size="2"><sub><font face="Verdana">I-</font><font face="Symbol">a</font><font face="Verdana">/2</font></sub></font><font size="2" face="Symbol">s</font><font face="Verdana" size="2"><sub>I</sub></font> </P>     <P align="justify"><font face="Verdana" size="2">para toda muestra aleatoria usada en la estimaci&oacute;n I* (Efron 1979).</font></P>     ]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">Sobre esta base es posible estimar los l&iacute;mites del intervalo de confianza usando la estimaci&oacute;n <I>bootstrap</I> de la desviaci&oacute;n est&aacute;ndar como</font></P>     <P align="justify"><font face="Verdana" size="2">&#298;* ± z</font><font size="2"><sub><font face="Symbol">a</font><font face="Verdana">/2</font></sub></font><font size="2" face="Symbol">s</font><font face="Verdana" size="2"><sub>1</sub>*</font></P>     <P align="justify"><font face="Verdana" size="2">siendo &#298;* la media del estimador <I>bootstrap</I> del &iacute;ndice, </font><font size="2" face="Symbol">s</font><font face="Verdana" size="2"><sub>1</sub>*</font><font face="Verdana" size="2"> el estimador <I>bootstrap</I> de la desviaci&oacute;n est&aacute;ndar y z</font><font size="2"><sub><font face="Symbol">a</font><font face="Verdana">/2 </font></sub></font><font face="Verdana" size="2">el correspondiente valor de la distribuci&oacute;n normal est&aacute;ndar.</font></P>     <P align="justify"><font face="Verdana" size="2">Detalles de &eacute;ste y otros m&eacute;todos de estimaci&oacute;n de intervalos de confianza pueden encontrarse por ejemplo en Efron y Tibshirani (1998). Para el c&aacute;lculo de los &iacute;ndices y sus IC existe software espec&iacute;fico de acceso libre como por ejemplo EstimateS (Colwell, 2005) o SPADE (Chao y Shen, 2003-2005). En el programa InfoStat se ha desarrollado un m&oacute;dulo de aplicaci&oacute;n que calcula &eacute;stos y otros &iacute;ndices de biodiversidad y sus IC (InfoStat, 2004). Los c&aacute;lculos en este trabajo se hicieron con InfoStat y las simulaciones utilizando ResamplingStats (Simon, 2003) con rutinas desarrolladas especialmente que pueden ser solicitadas a la autora.</font></P>  <B>    <P align="justify"><font face="Verdana" size="2">Resultados</font></P> </B> <I>    <P align="justify"><font face="Verdana" size="2">Biodiversidad en la Base de Vegetaci&oacute;n</font></P> </I>     <P align="justify"><font face="Verdana" size="2">Las estimaciones aplicadas al ‘espinar’ se presentan en la <a href="#tab1"> Tabla I</a>. La variabilidad entre muestras de una misma formaci&oacute;n influye en el tama&ntilde;o o amplitud (diferencia entre los l&iacute;mites) del intervalo de confianza para toda la formaci&oacute;n. Se ha evitado expresamente el t&eacute;rmino &quot;promedio&quot; al final de la <a href="#tab1"> Tabla I</a>, ya que en este caso no se trata de un promedio de los &iacute;ndices a nivel de la formaci&oacute;n, sino del valor obtenido con el amalgamiento de la informaci&oacute;n de todas las muestras. La diferencia entre uno y otro procedimiento al calcular un indicador y su intervalo de confianza, depender&aacute; del plan de muestreo utilizado para relevar la informaci&oacute;n a campo.</font> </P>      <P align="center"><a name="tab1"><img border="0" src="/img/fbpe/inci/v31n8/art08tab1.jpg" width="577" height="606"></a></P>      
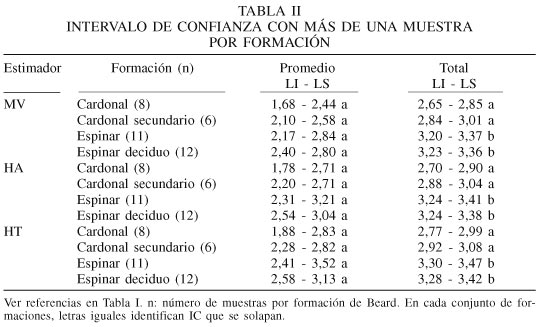
<P align="justify"><font face="Verdana" size="2">Los intervalos utilizando el estimador m&aacute;ximo veros&iacute;mil sin corregir o corregido por r o r<sub>pot</sub> son comparativamente menores que aquellos corregidos por ACE. La amplitud del ajuste emp&iacute;rico propuesta por Pla (2004) resulta en IC menos amplios que la estimaci&oacute;n de Horvitz-Thompson propuesta por Chao y Shen (2003). Los valores excesivamente altos que se registran para los intervalos corregidos por ACE est&aacute;n asociados directamente a una estimaci&oacute;n de la riqueza que discrepa altamente de la observada. Estos casos se presentan cuando predominan especies con muy baja abundancia, como por ejemplo en el espinar identificado como e4, con 36 especies, donde la estimaci&oacute;n de la riqueza por ACE fue de 739. El efecto en la correcci&oacute;n del estimador m&aacute;ximo veros&iacute;mil produce un aumento excesivo del l&iacute;mite superior, tornando no informativo al IC. Los resultados obtenidos para otras tres formaciones (resultados no mostrados) permiten generalizar estas conclusiones en relaci&oacute;n al comportamiento de los estimadores.</font></P>     <P align="justify"><font face="Verdana" size="2">Los intervalos de confianza estimados para el promedio de los censos de cada formaci&oacute;n y para el total amalgamado de la formaci&oacute;n utilizando el estimador m&aacute;ximo veros&iacute;mil sin correcci&oacute;n, el propuesto por Pla (2004) y el propuesto por Chao y Shen (2003), se presentan en la <a href="#tab2"> Tabla II</a>. Mientras que al utilizar el promedio por formaci&oacute;n no se detectan diferencias significativas entre cardonales y espinares; al amalgamar las muestras &eacute;stas se ponen de manifiesto. Sin embargo, siguen siendo no significativas las diferencias entre las formaciones secundarias y aquellas que les dieron origen.</font></P>      ]]></body>
<body><![CDATA[<P align="center"><a name="tab2"><img border="0" src="/img/fbpe/inci/v31n8/art08tab2.jpg" width="540" height="327"></a></P>      
<P align="justify"><font face="Verdana" size="2">La amplitud de los IC construidos a partir del promedio de los &iacute;ndices por muestra es entre 3 y 4 veces mayor que la de aquellos calculados amalgamando la informaci&oacute;n de todas las muestras. La amplitud del intervalo por aproximaci&oacute;n normal refleja la variabilidad aleatoria entre las muestras y la variabilidad dentro de muestras (la debida a la necesidad de estimar la abundancia relativa de cada especie). En el caso de las muestras amalgamadas no existe variabilidad entre muestras, y toda la variabilidad aleatoria est&aacute; asociada a la estimaci&oacute;n de la abundancia relativa de las especies. El n&uacute;mero de individuos incluidos en la muestra amalgamada es siempre mayor que el de cada muestra individual, permitiendo que la estimaci&oacute;n de la proporci&oacute;n por especie se base en una muestra m&aacute;s grande (y por lo tanto m&aacute;s eficiente) de la misma comunidad. No debe sorprender al investigador obtener esta diferencia de amplitudes.</font></P>     <P align="justify"><font face="Verdana" size="2">Muestras independientes que constituyan repeticiones al azar pueden ser tratadas en cualquiera de las dos formas, mientras que muestras sistem&aacute;ticas o provenientes de un plan de muestreo no aleatorio deber&iacute;an ser amalgamadas a fin de aprovechar la variabilidad observada en campo para mejorar la estimaci&oacute;n de la abundancia relativa de cada especie, en lugar de considerar un promedio. El uso del error est&aacute;ndar (desv&iacute;o del promedio: <img border="0" src="/img/fbpe/inci/v31n8/art08ec10b.gif" width="62" height="22"> que podr&iacute;a tender a declarar significativas diferencias atribuibles al azar, en realidad produce IC m&aacute;s amplios por la falta de ‘cobertura muestral’. Por este motivo la correcta construcci&oacute;n de los intervalos de confianza contribuir&aacute; a que el investigador efectivamente identifique aquellas diferencias de inter&eacute;s, y sobre ellas concentre su atenci&oacute;n.</font></P>     
<P align="justify"><font face="Verdana" size="2">Estudios por simulaci&oacute;n de poblaciones con patrones de abundancia de especies similares a los del ejemplo indican que la cobertura (probabilidad de que el intervalo calculado con 95% de confiabilidad efectivamente cubra el par&aacute;metro) depende no solo del tama&ntilde;o de cada muestra y del n&uacute;mero de muestras que se promedien, sino tambi&eacute;n del m&eacute;todo de estimaci&oacute;n utilizado. Acorde a lo esperado, el estimador m&aacute;ximo veros&iacute;mil y el ajustado de Pla mejoran su estimaci&oacute;n tanto al aumentar el n&uacute;mero de individuos por muestra, como el n&uacute;mero de muestras tomadas en cada caso (<a href="#fig2">Figura 2</a>). Al contrario, el estimador de Horvitz-Thompson si bien mejora la estimaci&oacute;n cuando se utiliza el promedio de varias muestras a medida que su n&uacute;mero aumenta, cuando las muestras se amalgaman las estimaciones son menos confiables a medida que aumenta el n&uacute;mero de individuos muestreados. Para cualquier situaci&oacute;n la estimaci&oacute;n m&aacute;ximo veros&iacute;mil no es confiable, cuando se trata de muestras amalgamadas la estimaci&oacute;n ajustada de Pla ofrece los intervalos m&aacute;s informativos (menor amplitud) y cuando se trata de promedios de varias muestras la mejor opci&oacute;n se logra al utilizar el m&eacute;todo Horvitz-Thompson, que ofrece intervalos m&aacute;s amplios pero con una cobertura &oacute;ptima.</font></P>      <P align="center"><a name="fig2"><img border="0" src="/img/fbpe/inci/v31n8/art08img02.gif" width="576" height="614"></a></P>      
<P align="justify"><font face="Verdana" size="2">El comportamiento observado es esperable ya que la propuesta de Chao y Shen (2003) est&aacute; definida para situaciones donde el n&uacute;mero de individuos es bajo y la capacidad de una sola muestra de incluir una buena proporci&oacute;n de las especies es tambi&eacute;n baja. As&iacute;, al amalgamar muestras disminuye su efectividad. En el caso de la estimaci&oacute;n ajustada por Pla (2004) la amplitud del intervalo se mantiene reducida; la estimaci&oacute;n puntual (centro del intervalo) corresponde al ajuste por el n&uacute;mero de especies presentes y la estimaci&oacute;n <I>bootstrap</I> del &iacute;ndice que reproduce la diferencia entre poblaci&oacute;n y muestra se utiliza para corregir el sesgo de la estimaci&oacute;n puntual.</font></P>     <P align="justify"><font face="Verdana" size="2">Cuando se poseen muestras independientes, la diferencia entre los procedimientos de amalgamiento y por promedio, tambi&eacute;n pueden ser aprovechados por el investigador. Mientras que al utilizar el amalgamiento se obtiene informaci&oacute;n de la diversidad alfa (de un solo sistema considerado homog&eacute;neo a la escala de an&aacute;lisis), el uso del promedio de las muestras permite cambiar la escala de observaci&oacute;n al considerar la variaci&oacute;n dentro del sistema (diversidad beta) y asociar la biodiversidad con alg&uacute;n patr&oacute;n del ambiente, ya que se dispondr&iacute;a de una estimaci&oacute;n para cada muestra y una para el promedio. En la <a href="#fig2"> Figura 2</a> puede observarse, en especial para las muestras de hasta 60 individuos, que el &iacute;ndice estimado por promedios es menor que el estimado con la muestra amalgamada. Si el objetivo es estimar la diversidad alfa, el segundo procedimiento corrige con mayor eficiencia el sesgo negativo de la estimaci&oacute;n aunque siempre se subestima el &iacute;ndice poblacional.</font></P>  <I>    <P align="justify"><font face="Verdana" size="2">Biodiversidad en la Base de Aves</font></P> </I>     <P align="justify"><font face="Verdana" size="2">Dado que el objetivo de los investigadores es detectar posibles diferencias entre la riqueza y la abundancia de fragmentos grandes y peque&ntilde;os con fines de manejo del ecosistema, una primera aproximaci&oacute;n es comparar los promedios de riqueza y de abundancia suponiendo que las variables fueran aproximadamente normales o que el n&uacute;mero de muestras fuese suficientemente grande para justificar la aplicaci&oacute;n del teorema central del l&iacute;mite. En este caso las pruebas de falta de bondad de ajuste a la normal para la riqueza observada fueron no significativas (p=0,4932 y p=0,7353) y para la abundancia tambi&eacute;n (p=0,5608 y p=0,8192) en ambos tipos de fragmentos. Las pruebas t de Student permiten concluir que no existieron diferencias significativas del n&uacute;mero de aves observadas por muestra entre los fragmentos grandes y los peque&ntilde;os (p=0,2431), pero que los primeros tienen significativamente mayor n&uacute;mero de especies (p=0,0017). El &iacute;ndice de Shannon se estim&oacute; usando Horvitz-Thompson ya que el n&uacute;mero m&aacute;ximo de aves fue 55 en los fragmentos grandes y 46 en los peque&ntilde;os. Si se amalgaman las muestras debe usarse HA.</font></P>     <P align="justify"><font face="Verdana" size="2">Los fragmentos peque&ntilde;os (con una superficie promedio de 67,36ha) que var&iacute;an entre 3,45 y 129,67ha no presentan diferencias de biodiversidad asociadas a su superficie (p=0,3279), como tampoco difieren en su abundancia (p=0,1291). Los fragmentos grandes tienen s&oacute;lo dos tama&ntilde;os (24060ha y 21879ha) y su riqueza promedio no difiere significativamente (p=0,4696) como tampoco difiere la abundancia promedio (p=0,6452). Asimismo, la diferencia entre la abundancia promedio de los fragmentos grandes (30) y los peque&ntilde;os (27) no es estad&iacute;sticamente significativa (p=0,2431), todo lo cu&aacute;l permite comparar la biodiversidad sobre la base de los &iacute;ndices (riqueza e &iacute;ndice de Shannon) en muestras que pueden considerarse de tama&ntilde;o homog&eacute;neo. La pregunta que resta es si el tama&ntilde;o fue suficiente para ambos tipos de fragmentos, solo para uno, o bien para ninguno.</font></P>     ]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">Una opci&oacute;n para encontrar esta respuesta podemos obtenerla si amalgamamos las muestras que provienen del mismo fragmento y el mismo d&iacute;a, y comparamos los resultados. En 8 sitios de muestreo provenientes de un mismo fragmento peque&ntilde;o de 129,67ha se calcul&oacute; un promedio de 18 especies y se estim&oacute; la riqueza con ACE en 28 y con r<sub>pot</sub> en 24. Sin embargo, si se amalgaman esas mismas muestras se encuentran 55 especies presentes con un valor estimado para ACE de 63 y para r<sub>pot</sub> de 65. El promedio de las abundancias fue 34 individuos, mientras que en la muestra amalgamada se totalizaron 271 individuos. Si se expresa la riqueza en forma relativa al n&uacute;mero de ejemplares (por ejemplo, expresada como n&uacute;mero de especies por cada 10 aves avistadas), se obtiene un valor de 5,3 para el promedio y de 2,0 para la muestra amalgamada.</font></P>     <P align="justify"><font face="Verdana" size="2">Esta discrepancia es el resultado de c&oacute;mo se proces&oacute; la informaci&oacute;n del muestreo para estimar tanto la riqueza como el &iacute;ndice de Shannon. En el presente ejemplo se requieren en cada muestra aproximadamente 2 individuos para detectar una nueva especie, mientras que en el total amalgamado se requieren 5; es decir que se debe tener al menos 2,5 muestras (5/2) para amalgamar, a fin de obtener la misma efectividad. Pero cualquier incremento en el n&uacute;mero de muestras amalgamadas resultar&aacute; en una ganancia en la capacidad de detectar especies raras (o poco frecuentes). Si disponemos de 8 muestras la ganancia deber&iacute;a ser significativa, como efectivamente se observa al comparar la potencia de ambos procedimientos. En la <a href="#fig3"> Figura 3</a> se muestra la capacidad de detectar cierto porcentaje de las especies (abscisas) en funci&oacute;n de la potencia (proporci&oacute;n de veces en que se alcanza dicho porcentaje). La muestra amalgamada es capaz de detectar con certeza (potencia 1) el 80% de las especies, mientras que para el promedio este porcentaje baja al 50%. Si bien el amalgamiento no garantiza una estimaci&oacute;n no sesgada de riqueza, mejora considerablemente la inferencia utilizando los estimadores ACE o r<sub>pot</sub> al disminuir el n&uacute;mero de especies no incluidas en la muestra.</font></P>      <P align="center"><a name="fig3"><img border="0" src="/img/fbpe/inci/v31n8/art08img03.gif" width="534" height="381"></a></P>      
<P align="justify"><font face="Verdana" size="2">As&iacute;, al amalgamar todas las muestras seg&uacute;n el tipo de fragmento del que provengan se obtienen los resultados que se muestran en la <a href="#tab3"> Tabla III</a>. Los intervalos de confianza de ACE no se solapan, lo que mantiene la conclusi&oacute;n inicial de que los fragmentos grandes tienen comparativamente mayor n&uacute;mero de especies que los peque&ntilde;os y poseen una diversidad estimada por el &iacute;ndice de Shannon significativamente mayor.</font></P>      <P align="center"><a name="tab3"><img border="0" src="/img/fbpe/inci/v31n8/art08tab3.jpg" width="541" height="157"></a></P>  <B>    
<P align="justify"><font face="Verdana" size="2">Conclusiones</font></P> </B>     <P align="justify"><font face="Verdana" size="2">El uso generalizado del &iacute;ndice de Shannon como una expresi&oacute;n sint&eacute;tica de la biodiversidad ha estimulado la aparici&oacute;n de estimadores que corrigen el sesgo y mejoran la cuantificaci&oacute;n de la variabilidad aleatoria para permitir la construcci&oacute;n de intervalos de confianza. Hasta la d&eacute;cada pasada el estimador m&aacute;ximo veros&iacute;mil constituy&oacute; la &uacute;nica opci&oacute;n y su uso generalizado produjo con toda seguridad subestimaciones de los valores reportados en la literatura. La aparici&oacute;n de alternativas que mejoran la estimaci&oacute;n puntual porque corrigen el sesgo negativo, como la de Chao y Shen (2003) o de Pla (2004), revitalizan la utilidad de este &iacute;ndice.</font></P>     <P align="justify"><font face="Verdana" size="2">El estimador m&aacute;ximo veros&iacute;mil, aun corrigiendo con una estimaci&oacute;n mejorada de la riqueza, resulta en valores puntuales e IC m&aacute;s bajos que cualquiera de las otras propuestas. La revisi&oacute;n de la literatura y los resultados de nuestra simulaci&oacute;n nos hacen descartar su aplicaci&oacute;n. Esta recomendaci&oacute;n, sin embargo, conlleva una dificultad para comparar resultados anteriores ya publicados con nuevas estimaciones, salvo que se disponga de los datos originales. En estos casos siempre podr&aacute;n considerarse las dos opciones y utilizar la m&aacute;xima veros&iacute;mil para comparaciones cualitativas.</font></P>     <P align="justify"><font face="Verdana" size="2">Cuando el estimador m&aacute;ximo veros&iacute;mil del &iacute;ndice de Shannon se corrige usando ACE para estimar la riqueza el l&iacute;mite inferior del IC puede ser negativo y el superior excesivamente alto. Como alternativa, se sugiere el uso de una transformaci&oacute;n logar&iacute;tmica que resuelve la negatividad del l&iacute;mite inferior, pero mantiene la amplitud del IC muy alta. Se pueden obtener estimaciones de la riqueza que discrepan en m&aacute;s de un 2000% de la observada, en particular cuando se trata de muestras con muchas especies muy poco abundantes.</font></P>     <P align="justify"><font face="Verdana" size="2">La propuesta de Pla (2004) permite la estimaci&oacute;n por IC con l&iacute;mites ajustados y ofrece comportamiento &oacute;ptimo cuando se trata de muestras con d»2000 individuos, independientemente de la abundancia de las especies, mejorando la confiabilidad a medida que aumenta el n&uacute;mero de individuos en la muestra. Por ello es la opci&oacute;n recomendada cuando se pueden amalgamar muestras.</font></P>     ]]></body>
<body><![CDATA[<P align="justify"><font face="Verdana" size="2">La propuesta de Chao y Shen (2003) ofrece IC m&aacute;s amplios pero su cobertura es &oacute;ptima. Se lo recomienda para casos donde abundan las especies raras, ya sea para una muestra &uacute;nica como para el promedio de varias muestras. La desventaja de este estimador reside en que a medida que aumenta el n&uacute;mero de individuos en la muestra, desmejora la correcci&oacute;n por sesgo y, al contrario de lo esperado, aumenta la amplitud del intervalo.</font></P>     <P align="justify"><font face="Verdana" size="2">La cuantificaci&oacute;n de la biodiversidad ser&aacute; apreciada en tanto pueda utilizarse con fines comparativos y por ello el &eacute;nfasis est&aacute; en la construcci&oacute;n de intervalos de confianza. La investigaci&oacute;n metodol&oacute;gica est&aacute; en desarrollo y los estudios que comparan estimadores en diversas condiciones por m&eacute;todos de simulaci&oacute;n Monte Carlo se han generalizado. La dependencia del desempe&ntilde;o de los estimadores del patr&oacute;n de distribuci&oacute;n de la abundancia de las especies, hoy ampliamente aceptada, es un obst&aacute;culo para la generalizaci&oacute;n descontextuada.</font></P>     <P align="justify"><font face="Verdana" size="2">Por ello, una vez m&aacute;s es posible afirmar que la colaboraci&oacute;n entre bi&oacute;logos, ec&oacute;logos y bi&oacute;metras permitir&aacute; definir la mejor estrategia de an&aacute;lisis para casos particulares y aumentar&aacute; el conocimiento sobre la biodiversidad para manejar adecuada y sosteniblemente el ecosistema.</font></P>  <B>    <P align="justify"><font face="Verdana" size="2">AGRADECIMIENTOS</font></P> </B>     <P align="justify"><font face="Verdana" size="2">La autora agradece a Alejandro Giraudo por facilitar la base de datos de aves.</font></P>  <B>    <P align="justify"><font face="Verdana" size="2">REFERENCIAS</font></P> </B>     <!-- ref --><p align="justify"><font face="Verdana" size="2">1. Chao A (1987) Estimation the population size for capture-recapture data with unequal catchability. <I>Biometrics 43</I>: 783-791</font><I><font face="Verdana" size="2">.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030261&pid=S0378-1844200600080000800001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">2. Chao A, Lee S-M (1992) Estimating the number of classes via sample coverage. <I>J. Am. Stat. Assoc. 87</I>: 210-217.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030262&pid=S0378-1844200600080000800002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">3. Chao A, Shen T-J (2003) Nonparametric estimation of Shannon’s index of diversity when there are unseen species in sample. <I>Env. Ecol. Stat. 10</I>: 429-443.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030263&pid=S0378-1844200600080000800003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">4. Chao A, Shen TJ (2003-2005) <I>Program SPADE (Species Prediction And Diversity Estimation)</I>. Program and User’s Guide. http://chao.stat.nthu.edu.tw.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030264&pid=S0378-1844200600080000800004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">5. Chao A, Hwang W-H, Chen Y-C, Kuo C-Y (2000) Estimating the number of shared species in two communities. <I>Stat. Sinica 10</I>: 227-246.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030265&pid=S0378-1844200600080000800005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">6. Colwell RK (2005) <I>EstimateS: Statistical estimation of species richness and shared species from samples Version 7.5.</I> User’s Guide and application. http://purl.oclc.org/estimates.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030266&pid=S0378-1844200600080000800006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">7. Efron B (1979) Bootstrap methods: An other look to the Jacknife. <I>Ann. Stat. 7</I>: 1-26.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030267&pid=S0378-1844200600080000800007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">8. Efron B, Tibshirani RJ (1998) <I>An introduction to the bootstrap</I>. 1<sup>a</sup> reimpresi&oacute;n. CRC. Boca Rat&oacute;n, FL, EEUU. 436 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030268&pid=S0378-1844200600080000800008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">9. Giraudo AR, Matteucci SD, Morello J, Alonso J, Herrera J, Abramson RR (2005) Efectos de la fragmentaci&oacute;n sobre la riqueza y abundancia de aves en la Selva Atl&aacute;ntica de Argentina. Un an&aacute;lisis preliminar en parches grandes y peque&ntilde;os. <I>XI Reuni&oacute;n Argentina de Ornitolog&iacute;a</I>. Buenos Aires, Argentina. www.avesargentinas.org.ar/rao/resumenes.htm</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030269&pid=S0378-1844200600080000800009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">10. Good IJ (1953) The population frequencies of species and the estimation of population parameters. <I>Biometrika 40</I>: 237-264.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030270&pid=S0378-1844200600080000800010&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">11. Gotelli NJ, Colwell RK (2001) Quantifying biodiversity: procedures and pitfalls in the measurement and comparison of species richness. <I>Ecol. Lett. 4</I>: 379-391.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030271&pid=S0378-1844200600080000800011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">12. Horvitz DG, Thompson DJ (1952) A generalization of sampling without replacement from a finite universe. <I>J. Am. Stat. Assoc. 47</I>: 1475-87.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030272&pid=S0378-1844200600080000800012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">13. Hutcheson K (1970) A test for comparing diversities based on Shannon formula. <I>J. Theor. Biol. 29</I>: 151–154.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030273&pid=S0378-1844200600080000800013&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">14. InfoStat (2004) <I>InfoStat versi&oacute;n 1.5. </I>Grupo InfoStat, FCA, Universidad Nacional de C&oacute;rdoba, Argentina. www.infostat.com.ar</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030274&pid=S0378-1844200600080000800014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">15. Matteucci SD (1987) The vegetation of Falc&oacute;n State, Venezuela.<I> Vegetatio 70</I>: 67-91.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030275&pid=S0378-1844200600080000800015&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">16. Matteucci SD, Colma A, Pla L (1999a) Biodiversidad vegetal en el &aacute;rido falconiano (Venezuela). <I>Interciencia 24</I>: 300-307.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030276&pid=S0378-1844200600080000800016&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">17. Matteucci SD, Colma A, Pla L (1999b) Bosques secos tropicales del estado Falc&oacute;n, Venezuela. En Matteucci SD, Solbrig OT, Morello J, Halffter G (Eds.) <I>Biodiversidad y Uso de la Tierra. Conceptos y ejemplos de Latinoam&eacute;rica.</I> Colecci&oacute;n CEA-UBA Vol. 23. EUDEBA. Buenos Aires, Argentina. pp. 399-420.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030277&pid=S0378-1844200600080000800017&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">18. Matteucci SD, Colma A, Pla L (2001) <I>Falc&oacute;n y sus recursos naturales: base electr&oacute;nica de informaci&oacute;n biof&iacute;sica.</I> UNEFM-CONICIT. Coro, Venezuela. ISBN: 980-858-7</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030278&pid=S0378-1844200600080000800018&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">19. Peet RK (1974) The measurement of species diversity. <I>Ann. Rev. Ecol. Sistem. 5</I>: 285-307.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030279&pid=S0378-1844200600080000800019&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">20. Pla L (2004) Bootstrap Confidence Intervals for the Shannon Biodiversity Index: A Simulation Study. <I>J. Agric. Biol. Env. Stat. 9</I>: 42–56.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030280&pid=S0378-1844200600080000800020&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">21. Pla L, Matteucci SD (2001) Intervalos de confianza bootstrap del &iacute;ndice de biodiversidad de Shannon. <I>Rev. Fac. Agron. (LUZ) 18</I>: 222-234.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030281&pid=S0378-1844200600080000800021&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">22. Pla L, Balzarini M, DiRienzo JA (2004) The Assessment of Biodiversity: Inference about richness. <I>XXII International Biometric Conference,</I> Cairns, Australia. pp. 134.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030282&pid=S0378-1844200600080000800022&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">23. Shannon CE, Weaver W (1949) <I>The mathematical theory of communication</I>. University of Illinois Press. Urbana, IL, EEUU. 144 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030283&pid=S0378-1844200600080000800023&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">24. Simon JL (2003) <I>Resampling Stats, version 5.02</I>. www.resample.com.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1030284&pid=S0378-1844200600080000800024&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body>
<back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chao]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Estimation the population size for capture-recapture data with unequal catchability]]></article-title>
<source><![CDATA[Biometrics]]></source>
<year>1987</year>
<volume>43</volume>
<page-range>783-791</page-range></nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chao]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Lee]]></surname>
<given-names><![CDATA[S-M]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Estimating the number of classes via sample coverage]]></article-title>
<source><![CDATA[J. Am. Stat. Assoc.]]></source>
<year>1992</year>
<volume>87</volume>
<page-range>210-217</page-range></nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chao]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Shen]]></surname>
<given-names><![CDATA[T-J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Nonparametric estimation of Shannon’s index of diversity when there are unseen species in sample]]></article-title>
<source><![CDATA[Env. Ecol. Stat.]]></source>
<year>2003</year>
<volume>10</volume>
<page-range>429-443</page-range></nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chao]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Shen]]></surname>
<given-names><![CDATA[TJ]]></given-names>
</name>
</person-group>
<source><![CDATA[Program SPADE (Species Prediction And Diversity Estimation): Program and User’s Guide]]></source>
<year></year>
</nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chao]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Hwang]]></surname>
<given-names><![CDATA[W-H]]></given-names>
</name>
<name>
<surname><![CDATA[Chen]]></surname>
<given-names><![CDATA[Y-C]]></given-names>
</name>
<name>
<surname><![CDATA[Kuo]]></surname>
<given-names><![CDATA[C-Y]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Estimating the number of shared species in two communities]]></article-title>
<source><![CDATA[Stat. Sinica]]></source>
<year>2000</year>
<volume>10</volume>
<page-range>227-246</page-range></nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Colwell]]></surname>
<given-names><![CDATA[RK]]></given-names>
</name>
</person-group>
<source><![CDATA[EstimateS: Statistical estimation of species richness and shared species from samples Version 7.5: User’s Guide and application]]></source>
<year>2005</year>
</nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Efron]]></surname>
<given-names><![CDATA[B]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bootstrap methods: An other look to the Jacknife]]></article-title>
<source><![CDATA[Ann. Stat.]]></source>
<year>1979</year>
<volume>7</volume>
<page-range>1-26</page-range></nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Efron]]></surname>
<given-names><![CDATA[B]]></given-names>
</name>
<name>
<surname><![CDATA[Tibshirani]]></surname>
<given-names><![CDATA[RJ]]></given-names>
</name>
</person-group>
<source><![CDATA[An introduction to the bootstrap]]></source>
<year>1998</year>
<page-range>436</page-range><publisher-loc><![CDATA[Boca Ratón^eFL FL]]></publisher-loc>
<publisher-name><![CDATA[CRC]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="confpro">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Giraudo]]></surname>
<given-names><![CDATA[AR]]></given-names>
</name>
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
<name>
<surname><![CDATA[Morello]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Alonso]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Herrera]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Abramson]]></surname>
<given-names><![CDATA[RR]]></given-names>
</name>
</person-group>
<source><![CDATA[Efectos de la fragmentación sobre la riqueza y abundancia de aves en la Selva Atlántica de Argentina: Un análisis preliminar en parches grandes y pequeños]]></source>
<year>2005</year>
<conf-name><![CDATA[XI Reunión Argentina de Ornitología]]></conf-name>
<conf-loc>Buenos Aires </conf-loc>
</nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Good]]></surname>
<given-names><![CDATA[IJ]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The population frequencies of species and the estimation of population parameters]]></article-title>
<source><![CDATA[Biometrika]]></source>
<year>1953</year>
<volume>40</volume>
<page-range>237-264</page-range></nlm-citation>
</ref>
<ref id="B11">
<label>11</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Gotelli]]></surname>
<given-names><![CDATA[NJ]]></given-names>
</name>
<name>
<surname><![CDATA[Colwell]]></surname>
<given-names><![CDATA[RK]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Quantifying biodiversity: procedures and pitfalls in the measurement and comparison of species richness]]></article-title>
<source><![CDATA[Ecol. Lett.]]></source>
<year>2001</year>
<volume>4</volume>
<page-range>379-391</page-range></nlm-citation>
</ref>
<ref id="B12">
<label>12</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Horvitz]]></surname>
<given-names><![CDATA[DG]]></given-names>
</name>
<name>
<surname><![CDATA[Thompson]]></surname>
<given-names><![CDATA[DJ]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A generalization of sampling without replacement from a finite universe]]></article-title>
<source><![CDATA[J. Am. Stat. Assoc.]]></source>
<year>1952</year>
<volume>47</volume>
<page-range>1475-87</page-range></nlm-citation>
</ref>
<ref id="B13">
<label>13</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hutcheson]]></surname>
<given-names><![CDATA[K]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A test for comparing diversities based on Shannon formula]]></article-title>
<source><![CDATA[J. Theor. Biol.]]></source>
<year>1970</year>
<volume>29</volume>
<page-range>151-154</page-range></nlm-citation>
</ref>
<ref id="B14">
<label>14</label><nlm-citation citation-type="book">
<collab>InfoStat</collab>
<source><![CDATA[InfoStat versión 1.5]]></source>
<year>2004</year>
<publisher-name><![CDATA[Grupo InfoStat, FCA, Universidad Nacional de Córdoba]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B15">
<label>15</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The vegetation of Falcón State, Venezuela]]></article-title>
<source><![CDATA[Vegetatio]]></source>
<year>1987</year>
<volume>70</volume>
<page-range>67-91</page-range></nlm-citation>
</ref>
<ref id="B16">
<label>16</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
<name>
<surname><![CDATA[Colma]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Biodiversidad vegetal en el árido falconiano (Venezuela)]]></article-title>
<source><![CDATA[Interciencia]]></source>
<year>1999</year>
<month>a</month>
<volume>24</volume>
<page-range>300-307</page-range></nlm-citation>
</ref>
<ref id="B17">
<label>17</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
<name>
<surname><![CDATA[Colma]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Bosques secos tropicales del estado Falcón, Venezuela]]></article-title>
<person-group person-group-type="editor">
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
<name>
<surname><![CDATA[Solbrig]]></surname>
<given-names><![CDATA[OT]]></given-names>
</name>
<name>
<surname><![CDATA[Morello]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Halffter]]></surname>
<given-names><![CDATA[G]]></given-names>
</name>
</person-group>
<source><![CDATA[Biodiversidad y Uso de la Tierra: Conceptos y ejemplos de Latinoamérica]]></source>
<year>1999</year>
<month>b</month>
<volume>23</volume>
<page-range>399-420</page-range><publisher-loc><![CDATA[Buenos Aires ]]></publisher-loc>
<publisher-name><![CDATA[EUDEBA]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B18">
<label>18</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
<name>
<surname><![CDATA[Colma]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
</person-group>
<source><![CDATA[Falcón y sus recursos naturales: base electrónica de información biofísica]]></source>
<year>2001</year>
<publisher-loc><![CDATA[Coro ]]></publisher-loc>
<publisher-name><![CDATA[UNEFM-CONICIT]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B19">
<label>19</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Peet]]></surname>
<given-names><![CDATA[RK]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The measurement of species diversity]]></article-title>
<source><![CDATA[Ann. Rev. Ecol. Sistem.]]></source>
<year>1974</year>
<volume>5</volume>
<page-range>285-307</page-range></nlm-citation>
</ref>
<ref id="B20">
<label>20</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bootstrap Confidence Intervals for the Shannon Biodiversity Index: A Simulation Study]]></article-title>
<source><![CDATA[J. Agric. Biol. Env. Stat.]]></source>
<year>2004</year>
<volume>9</volume>
<page-range>42-56</page-range></nlm-citation>
</ref>
<ref id="B21">
<label>21</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
<name>
<surname><![CDATA[Matteucci]]></surname>
<given-names><![CDATA[SD]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Intervalos de confianza bootstrap del índice de biodiversidad de Shannon]]></article-title>
<source><![CDATA[Rev. Fac. Agron. (LUZ)]]></source>
<year>2001</year>
<volume>18</volume>
<page-range>222-234</page-range></nlm-citation>
</ref>
<ref id="B22">
<label>22</label><nlm-citation citation-type="confpro">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Pla]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
<name>
<surname><![CDATA[Balzarini]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[DiRienzo]]></surname>
<given-names><![CDATA[JA]]></given-names>
</name>
</person-group>
<source><![CDATA[The Assessment of Biodiversity: Inference about richness]]></source>
<year>2004</year>
<conf-name><![CDATA[XXII International Biometric Conference]]></conf-name>
<conf-loc>Cairns </conf-loc>
<page-range>134</page-range></nlm-citation>
</ref>
<ref id="B23">
<label>23</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Shannon]]></surname>
<given-names><![CDATA[CE]]></given-names>
</name>
<name>
<surname><![CDATA[Weaver]]></surname>
<given-names><![CDATA[W]]></given-names>
</name>
</person-group>
<source><![CDATA[The mathematical theory of communication]]></source>
<year>1949</year>
<page-range>144</page-range><publisher-loc><![CDATA[Urbana^eIL IL]]></publisher-loc>
<publisher-name><![CDATA[University of Illinois Press]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B24">
<label>24</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Simon]]></surname>
<given-names><![CDATA[JL]]></given-names>
</name>
</person-group>
<source><![CDATA[Resampling Stats, version 5.02]]></source>
<year>2003</year>
</nlm-citation>
</ref>
</ref-list>
</back>
</article>