<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0378-1844</journal-id>
<journal-title><![CDATA[Interciencia]]></journal-title>
<abbrev-journal-title><![CDATA[INCI]]></abbrev-journal-title>
<issn>0378-1844</issn>
<publisher>
<publisher-name><![CDATA[ASOCIACIÓN INTERCIENCIA]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0378-18442006001100006</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Estimación de la variabilidad interna de muestras poblacionales, mediante análisis de componentes principales]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Núñez-Colín]]></surname>
<given-names><![CDATA[Carlos A]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Barrientos-Priego]]></surname>
<given-names><![CDATA[Alejandro F]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad Autonoma Chapingo  ]]></institution>
<addr-line><![CDATA[ Edo. de México]]></addr-line>
<country>México</country>
</aff>
<aff id="A02">
<institution><![CDATA[,UACh  ]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>11</month>
<year>2006</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>11</month>
<year>2006</year>
</pub-date>
<volume>31</volume>
<numero>11</numero>
<fpage>817</fpage>
<lpage>821</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_arttext&amp;pid=S0378-18442006001100006&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_abstract&amp;pid=S0378-18442006001100006&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_pdf&amp;pid=S0378-18442006001100006&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[Se propone una nueva fórmula para describir la variación interna de grupos o poblaciones utilizando m variables con un solo dato. Esta fórmula esta basada en el análisis de componentes principales (ACP), ya que este análisis permite reducir la dimensionalidad con mínima pérdida de información, y en la idea empírica de la varianza, la dispersión de los individuos con respecto a su media. A partir de la proyección de individuos en un ACP se observa la dispersión de individuos en planos con dimensionalidad reducida, los componentes principales (CP) necesarios para explicar ~50% de la varianza total. Una variable categórica es usada para dividir a todos los individuos en k grupos de n individuos cada uno dentro de un mismo ACP, teniendo para cada uno de los k grupos un valor que se puede comparar con los otros para determinar la homogeneidad de cada grupo. Además, es posible detectar, mediante el cálculo adicional del error estándar de esta fórmula, si se presentan individuos atípicos dentro de cada uno de estos grupos.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[A new formula is proposed in order to describe the internal variability of groups or populations using m variables with only one value. This formula is based on principal component analysis (PCA), as this analysis reduces the dimensionality with a minimal loss of information, and on the empirical idea of variance, the dispersion of the individuals around their average. From the projection of individuals in a PCA, their dispersion in planes with reduced dimensionality can be observed, as well as the principal components (PC) needed to explain ~50% of the total variance. A categorical variable can be used to divide all the individuals in k groups of n individuals, each one inside of the same PCA and having a value for each one of the k groups that can be compared with the other groups to determine the homogeneity of each of them. Also, through the additional calculation of the standard error of this formula, it is possible to detect the presence of atypical individuals in each of these groups.]]></p></abstract>
<abstract abstract-type="short" xml:lang="pt"><p><![CDATA[Propõe-se uma nova fórmula para descrever a variação interna de grupos ou populações utilizando m variáveis com um só dado. Esta fórmula esta baseada na análise de componentes principais (ACP), já que esta análise permite reduzir a dimensionalidade com mínima perda de informação, e na idéia empírica da variança, a dispersão dos indivíduos em relação a sua média. A partir da projeção de indivíduos em um ACP se observa a dispersão de indivíduos em planos com dimensionalidade reduzida, os componentes principais (CP) necessários para explicar ~50% da variança total. Uma variável categórica é usada para dividir a todos os indivíduos em k grupos de n indivíduos cada um dentro de um mesmo ACP, tendo para cada um dos k grupos um valor que se pode comparar com os outros para determinar a homogeneidade de cada grupo. Além disso, é possível detectar, mediante o cálculo adicional do erro padrão de esta fórmula, si se apresentam indivíduos atípicos dentro de cada um destes grupos.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[Análisis de Homogeneidad de Grupos]]></kwd>
<kwd lng="es"><![CDATA[Análisis Multivariable]]></kwd>
<kwd lng="es"><![CDATA[Varianza Multivariable]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[   <B>    <P align="center"><font face="Verdana" size="3">ESTIMACI&Oacute;N DE LA VARIABILIDAD INTERNA DE MUESTRAS POBLACIONALES, MEDIANTE AN&Aacute;LISIS DE COMPONENTES PRINCIPALES</font></P> </B>     <P align="center"><font size="2" face="Verdana"><sup>1</sup>Carlos A. N&uacute;&ntilde;ez-Col&iacute;n y <sup>2</sup>Alejandro F. Barrientos-Priego</font></P>     <P align="justify"><font size="2" face="Verdana">1. ngeniero Agr&oacute;nomo, Maestro en Ciencias y estudiante de Doctorado en Ciencias en Horticultura, Universidad Aut&oacute;noma Chapingo (UACh), M&eacute;xico. Direcci&oacute;n: Km. 38.5 carretera M&eacute;xico–Texcoco, Chapingo, Edo. de M&eacute;xico, M&eacute;xico 56230. e-mail:<SUP> </SUP>lit007a@gmail.com </font> </P>     <P align="justify"><font size="2" face="Verdana">2.</font> <font size="2" face="Verdana"> Ingeniero Agr&oacute;nomo, UACh, M&eacute;xico. Maestro en Ciencias y Doctor en Ciencias, Colegio de Postgraduados, M&eacute;xico. Profesor-Investigador, UACh, M&eacute;xico. e-mail: abarrien@correo.chapingo.mx</font></P>      <P align="justify"><font size="2" face="Verdana">RESUMEN</font></P>      <P align="justify"><font size="2" face="Verdana">Se propone una nueva f&oacute;rmula para describir la variaci&oacute;n interna de grupos o poblaciones utilizando m variables con un solo dato. Esta f&oacute;rmula esta basada en el an&aacute;lisis de componentes principales (ACP), ya que este an&aacute;lisis permite reducir la dimensionalidad con m&iacute;nima p&eacute;rdida de informaci&oacute;n, y en la idea emp&iacute;rica de la varianza, la dispersi&oacute;n de los individuos con respecto a su media. A partir de la proyecci&oacute;n de individuos en un ACP se observa la dispersi&oacute;n de individuos en planos con dimensionalidad reducida, los componentes principales (CP) necesarios para explicar ~50% de la varianza total. Una variable categ&oacute;rica es usada para dividir a todos los individuos en k grupos de n individuos cada uno dentro de un mismo ACP, teniendo para cada uno de los k grupos un valor que se puede comparar con los otros para determinar la homogeneidad de cada grupo. Adem&aacute;s, es posible detectar, mediante el c&aacute;lculo adicional del error est&aacute;ndar de esta f&oacute;rmula, si se presentan individuos at&iacute;picos dentro de cada uno de estos grupos.</font></P>  <B>    <P align="justify"><font size="2" face="Verdana">ESTIMATE OF INTERNAL VARIABILITY OF POPULATION SAMPLES BY MEANS OF PRINCIPAL COMPONENT ANALYSIS</font></P> </B>     <P align="justify"><font size="2" face="Verdana">SUMMARY</font></P>      <P align="justify"><font size="2" face="Verdana">A new formula is proposed in order to describe the internal variability of groups or populations using m variables with only one value. This formula is based on principal component analysis (PCA), as this analysis reduces the dimensionality with a minimal loss of information, and on the empirical idea of variance, the dispersion of the individuals around their average. From the projection of individuals in a PCA, their dispersion in planes with reduced dimensionality can be observed, as well as the principal components (PC) needed to explain ~50% of the total variance. A categorical variable can be used to divide all the individuals in k groups of n individuals, each one inside of the same PCA and having a value for each one of the k groups that can be compared with the other groups to determine the homogeneity of each of them. Also, through the additional calculation of the standard error of this formula, it is possible to detect the presence of atypical individuals in each of these groups.</font></P>  <B>    ]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">ESTIMA&Ccedil;&Atilde;O DA VARIABILIDADE INTERNA DE AMOSTRAS POPULACIONAIS, MEDIANTE AN&Aacute;LISE DE COMPONENTES PRINCIPAIS</font></P> </B>     <P align="justify"><font size="2" face="Verdana">RESUMO</font></P>      <P align="justify"><font size="2" face="Verdana">Prop&otilde;e-se uma nova f&oacute;rmula para descrever a varia&ccedil;&atilde;o interna de grupos ou popula&ccedil;&otilde;es utilizando m vari&aacute;veis com um s&oacute; dado. Esta f&oacute;rmula esta baseada na an&aacute;lise de componentes principais (ACP), j&aacute; que esta an&aacute;lise permite reduzir a dimensionalidade com m&iacute;nima perda de informa&ccedil;&atilde;o, e na id&eacute;ia emp&iacute;rica da varian&ccedil;a, a dispers&atilde;o dos indiv&iacute;duos em rela&ccedil;&atilde;o a sua m&eacute;dia. A partir da proje&ccedil;&atilde;o de indiv&iacute;duos em um ACP se observa a dispers&atilde;o de indiv&iacute;duos em planos com dimensionalidade reduzida, os componentes principais (CP) necess&aacute;rios para explicar ~50% da varian&ccedil;a total. Uma vari&aacute;vel categ&oacute;rica &eacute; usada para dividir a todos os indiv&iacute;duos em k grupos de n indiv&iacute;duos cada um dentro de um mesmo ACP, tendo para cada um dos k grupos um valor que se pode comparar com os outros para determinar a homogeneidade de cada grupo. Al&eacute;m disso, &eacute; poss&iacute;vel detectar, mediante o c&aacute;lculo adicional do erro padr&atilde;o de esta f&oacute;rmula, si se apresentam indiv&iacute;duos at&iacute;picos dentro de cada um destes grupos.</font></P>  <B>    <P align="justify"><font size="2" face="Verdana">PALABRAS CLAVE / An&aacute;lisis de Homogeneidad de Grupos / An&aacute;lisis Multivariable / Varianza Multivariable /</font></P> </B><FONT SIZE=2>    <P align="justify"><font face="Verdana">Recibido: 16/02/2006. Modificado: 10/10/2006. Aceptado: 13/10/2006.</font></P> </FONT>    <P align="justify"><font size="2" face="Verdana">El estudio de los recursos fitogen&eacute;ticos, incluyendo los cultivos hortofrut&iacute;colas, se ha convertido en una prioridad, sobre todo en aquellos con potencial comercial y escasos estudios. Esto da importancia al an&aacute;lisis de la diversidad mediante m&eacute;todos cuantitativos que ayuden a agrupar poblaciones de un mismo g&eacute;nero o especie a partir de similitudes de caracteres hom&oacute;logos. Para ello se hace referencia al concepto de unidad taxon&oacute;mica operativa (operational taxonomic unit; OTU), definida como aquellos individuos o poblaciones que son el objeto del estudio y pueden ser representados en una clasificaci&oacute;n (Gonz&aacute;lez-Andr&eacute;s, 2001).</font></P>     <P align="justify"><font size="2" face="Verdana">Uno de los an&aacute;lisis m&aacute;s utilizados en los estudios de variabilidad es el an&aacute;lisis en componentes principales (ACP), el cual se utiliza para observar la dispersi&oacute;n, en un espacio bi o tridimensional, de los individuos en los dos o tres primeros componentes principales de variaci&oacute;n (Johnson, 1998). Con este an&aacute;lisis se representa en forma gr&aacute;fica la variaci&oacute;n existente entre los diferentes individuos en m dimensiones (hay m variables evaluadas), reduciendo la dimensionalidad al agrupar a todas las variables en unas dos o tres combinaciones lineales (componentes principales; CP) con caracter&iacute;sticas &oacute;ptimas para la representaci&oacute;n de la variabilidad subyacente. De esta manera es posible observar la similitud entre los individuos de acuerdo a su cercan&iacute;a en el plano conformado por las CP (Dur&aacute;n y Sahag&uacute;n, 1992).</font></P>     <P align="justify"><font size="2" face="Verdana">Los datos obtenidos en un estudio de caracterizaci&oacute;n forman una matriz rectangular de n OTU por m descriptores. En estas matrices generalmente se utilizan las medias de cada descriptor o variable, si en la poblaci&oacute;n no se presenta una gran variaci&oacute;n para tales caracter&iacute;sticas. Por esta raz&oacute;n, es recomendable encontrar la forma m&aacute;s eficaz de evaluar si las OTU de una poblaci&oacute;n son homog&eacute;neas.</font></P>     <P align="justify"><font size="2" face="Verdana">El presente estudio propone una prueba para determinar la variabilidad interna, tanto dentro de una OTU como de las OTU que comparten un origen, a partir de la representaci&oacute;n m (el n&uacute;mero necesario de dimensiones que acumulen el ~50% de la varianza) dimensional de las OTU en un ACP. Se ilustra el procedimiento utilizando ejemplos que involucran variables anat&oacute;micas de durazno (Prunus persica (L.) Batsch.), frijol (Phaseolus vulgaris L.) y aguacate (Persea americana Mill.), y variables morfol&oacute;gicas de las OTU de tejocote (Crataegus spp.) que comparten un origen com&uacute;n.</font></P>  <B>    <P align="justify"><font size="2" face="Verdana">Marco te&oacute;rico</font></P> </B>    ]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">Medidas de dispersi&oacute;n</font></P>     <P align="justify"><font size="2" face="Verdana">Las medidas de dispersi&oacute;n son utilizadas para medir la variabilidad de una variable respuesta dentro de una muestra o poblaci&oacute;n. La m&aacute;s utilizada es la varianza, definida desde el punto de vista estad&iacute;stico como el momento de segundo orden de una variable con respecto a su media; es decir, es la dispersi&oacute;n promedio que presenta cada dato evaluado con respecto a su valor medio (Infante y Z&aacute;rate, 2000).</font></P>     <P align="justify"><font size="2" face="Verdana">Existen otras medidas de dispersi&oacute;n, como la desviaci&oacute;n est&aacute;ndar, que es la ra&iacute;z cuadrada de la varianza, o el coeficiente de variaci&oacute;n, que es el cociente entre la desviaci&oacute;n est&aacute;ndar y la media, y que permite comparar la dispersi&oacute;n de variables sin importar la escala de medici&oacute;n en las que originalmente fueron tomados los datos (Sahag&uacute;n, 1994, <a href="#t1"> Tabla I</a>).</font></P>      <P align="center"><a name="t1"> <img border="0" src="/img/fbpe/inci/v31n11/Image449.jpg"></a></P>      
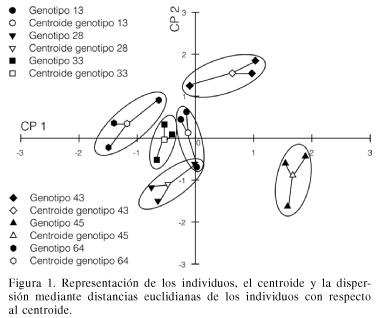
<P align="justify"><font size="2" face="Verdana">An&aacute;lisis de componentes principales (ACP)</font></P>     <P align="justify"><font size="2" face="Verdana">El ACP es un an&aacute;lisis multivariable del tipo de los an&aacute;lisis factoriales y que es utilizado para condensar o reducir informaci&oacute;n, contenida en una serie de variables originales, en otra serie m&aacute;s peque&ntilde;a de dimensiones compuestas o valores te&oacute;ricos (factores) nuevos con una m&iacute;nima p&eacute;rdida de informaci&oacute;n (Hair et al., 2001).</font></P>     <P align="justify"><font size="2" face="Verdana">El ACP comprende un procedimiento matem&aacute;tico que transforma un conjunto de variables respuesta correlacionadas en un conjunto menor de variables no correlacionadas llamadas componentes principales (CP), a partir de la matriz de correlaci&oacute;n de las variables originales, o en su defecto a partir de la matriz de varianzas-covarianzas. Los CP a construir son tantos como variables originales existan y acumulan una parte de la varianza total. Entre mayor sea su valor propio m&aacute;s varianza total explica, siendo denotado como primer componente aquel componente con mayor varianza, seguido del componente con la siguiente varianza como segundo componente, y as&iacute; subsecuentemente (Johnson, 1998)</font></P>     <P align="justify"><font size="2" face="Verdana">Con este an&aacute;lisis se hace posible representar gr&aacute;ficamente la variaci&oacute;n existente, acumulando la m&aacute;xima varianza en el menor n&uacute;mero de componentes principales, para lograr una verdadera reducci&oacute;n de la dimensionalidad. A partir de estos CP se puede realizar proyecciones de las OTU, lo que permite representar cada una de &eacute;stas en un espacio bi o tridimensional, explicando su distribuci&oacute;n con m&iacute;nima p&eacute;rdida de informaci&oacute;n (Gonz&aacute;lez-Andr&eacute;s, 2001).</font></P>      <P align="justify"><font size="2" face="Verdana">M&eacute;todo de la varianza interna (varianza multivariable)</font></P>     <P align="justify"><font size="2" face="Verdana">A partir del concepto emp&iacute;rico de la varianza, que es la dispersi&oacute;n de los individuos con respecto a su media, se desarroll&oacute; este concepto de varianza interna, que representa la dispersi&oacute;n entre los individuos de un grupo con su centroide y es calculado a partir de las medias de los valores de proyecci&oacute;n de los individuos en un ACP (<a href="#f1">Figura 1</a>). A partir de una serie de datos para estudios de caracterizaci&oacute;n, donde existe una variable categ&oacute;rica o clasificatoria para la formaci&oacute;n de grupos, se realiza un ACP y se toman en cuenta los primeros CP. Se obtiene la proyecci&oacute;n de las OTU en estos CP, que representan un cierto porcentaje de la variabilidad, tomando en cuenta a todas las variables evaluadas, aunque no todas representadas en la misma proporci&oacute;n en cada eje.</font></P>      ]]></body>
<body><![CDATA[<P align="center"><a name="f1"><img border="0" src="/img/fbpe/inci/v31n11/Image450.jpg"></a></P>      
<P align="justify"><font size="2" face="Verdana">El ACP no minimiza la variabilidad intra-grupo como lo hace el an&aacute;lisis discriminante can&oacute;nico (Johnson, 1998), ya que cada punto es asumido como diferente, sin importar a que clasificaci&oacute;n pertenece.</font></P>     <P align="justify"><font size="2" face="Verdana">A partir de esta proyecci&oacute;n se definen el n&uacute;mero de CP que son necesarios para tener una prueba representativa, aproximadamente el 50% de la varianza total. Se supone que este porcentaje de varianza se acumula con 2 o 3 CP. N&uacute;&ntilde;ez-Col&iacute;n y Barrientos-Priego (2004) hicieron una aproximaci&oacute;n de la f&oacute;rmula, pero sin la consideraci&oacute;n del aporte de varianza de cada componente, mediante la expresi&oacute;n</font></P>     <P align="justify"><img border="0" src="/img/fbpe/inci/v31n11/Image451.jpg"></P>      
<P align="justify"><font size="2" face="Verdana">donde <img border="0" src="/img/fbpe/inci/v31n11/Image452.jpg" width="18" height="23"> : distancia euclidiana promedio de los individuos del grupo k con respecto a su centroide, CP<SUB>ij</SUB>: valor de la proyecci&oacute;n del individuo i para el componente principal j, <img border="0" src="/img/fbpe/inci/v31n11/Image453.jpg" width="34" height="24">: valor promedio de los individuos del grupo k para el componente principal j, m: n&uacute;mero de componentes principales usados, y n: n&uacute;mero de individuos del grupo k.</font></P>     
<P align="justify"><font size="2" face="Verdana">Utilizando esa expresi&oacute;n se podr&iacute;an cometer algunos errores, ya que se considera que una cierta diferencia en el primer CP pondera de la misma manera que la misma diferencia para cualquier otro CP, sin contemplar el porcentaje de varianza que explica cada componente.</font></P>     <P align="justify"><font size="2" face="Verdana">Bajo estas consideraciones se propone una nueva medida de la variabilidad intra-grupo, que se basa en el valor medio de cada grupo en cada CP, valor que tambi&eacute;n puede ser representado en el espacio bi o tridimensional.</font></P>     <P align="justify"><font size="2" face="Verdana">Una vez calculado este valor dentro de cada grupo en cada CP, se obtiene la diferencia de la proyecci&oacute;n de cada individuo menos este valor medio, se eleva al cuadrado y se multiplica por el porcentaje de la varianza que aporta cada componente (como ponderaci&oacute;n). Sumando todos los CP y luego todos los individuos, y promediando, se obtiene la medida de inter&eacute;s. La expresi&oacute;n de la medida de variabilidad intra-grupo para el grupo k es</font></P>     <P align="justify"><img border="0" src="/img/fbpe/inci/v31n11/Image454.jpg" width="291" height="49"></P>      
<P align="justify"><font size="2" face="Verdana">donde <img border="0" src="/img/fbpe/inci/v31n11/Image455.jpg" width="14" height="19">: distancia euclidiana promedio ponderada de los individuos del grupo k con respecto a su centroide, CP<SUB>ij</SUB>: valor de la proyecci&oacute;n del individuo i para el componente principal j, <img border="0" src="/img/fbpe/inci/v31n11/Image453.jpg" width="34" height="24">: valor promedio de los individuos del grupo k para el componente principal j, %Var(CP<SUB>j</SUB>): porcentaje de varianza aportada por el CP<SUB>j</SUB> entre 100 (valores de 0 a 1), m: n&uacute;mero de componentes principales usados, y n: n&uacute;mero de individuos del grupo k.</font></P>     
]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">Se recomienda graficar estos valores con su error est&aacute;ndar para tener una mejor perspectiva para su interpretaci&oacute;n mediante la f&oacute;rmula</font></P>     <P align="justify"><img border="0" src="/img/fbpe/inci/v31n11/Image456.jpg" width="199" height="86"></P>      
<P align="justify"><font size="2" face="Verdana">donde SE(<img border="0" src="/img/fbpe/inci/v31n11/Image455.jpg" width="14" height="19">): error est&aacute;ndar de la <img border="0" src="/img/fbpe/inci/v31n11/Image455.jpg" width="14" height="19">, <img border="0" src="/img/fbpe/inci/v31n11/Image457.jpg" width="13" height="19">: distancia euclidiana promedio ponderada del individuo i del grupo k con respecto a su centroide mediante la f&oacute;rmula</font></P>     
<P align="justify"><img border="0" src="/img/fbpe/inci/v31n11/Image458.jpg" width="311" height="49"></P>      
<P align="justify"><font size="2" face="Verdana">,yCP<SUB>ij</SUB>,<img border="0" src="/img/fbpe/inci/v31n11/Image453.jpg" width="34" height="24">, %Var (CP<SUB>j</SUB>), m y n igual que anteriormente.</font></P>      
<P align="justify"><font size="2" face="Verdana">La medida permite identificar a los individuos at&iacute;picos del grupo, es decir, aquellos que presentan datos no comunes. Adem&aacute;s, permite comparar la dispersi&oacute;n dentro de diferentes grupos de un mismo ACP para determinar la homogeneidad de los mismos.</font></P>  <B>    <P align="justify"><font size="2" face="Verdana">Ejemplos del uso de la medida de variabilidad intra-grupo</font></P> </B>     <P align="justify"><font size="2" face="Verdana">Para ejemplificar el uso de esta medida se utilizar&aacute;n varios ejemplos en diferentes estudios de caracterizaci&oacute;n. El primero involucra datos anat&oacute;micos de durazneros mexicanos, ‘Nemaguard’ y almendro (N&uacute;&ntilde;ez-Col&iacute;n et al., 2006) con repeticiones de cada genotipo (variable clasificatoria); el segundo contiene datos morfol&oacute;gicos de tejocote de tres or&iacute;genes o clases (datos no publicados de Carlos N&uacute;&ntilde;ez-Col&iacute;n); y el tercero utiliza una base de datos anat&oacute;micos de tallos de seis l&iacute;neas de fr&iacute;jol en condiciones de exceso de humedad (Hern&aacute;ndez, 2005) utilizando repeticiones de cada l&iacute;nea, y a la denominaci&oacute;n de la l&iacute;nea como variable categ&oacute;rica. Finalmente se usa una cuarta base de datos construida a partir de informaci&oacute;n anat&oacute;mica de hojas de ocho genotipos de aguacate (Gonz&aacute;lez, 2004) utilizando repeticiones para cada genotipo (variable clasificatoria).</font></P>      <P align="justify"><font size="2" face="Verdana">Variables anat&oacute;micas de durazneros mexicanos, ‘Nemaguard’ y almendro</font></P>     <P align="justify"><font size="2" face="Verdana">En este estudio (N&uacute;&ntilde;ez-Col&iacute;n et al., 2006) se evaluaron 25 caracteres anat&oacute;micos en cinco materiales de duraznos &quot;criollos&quot; (Prunus persica) de M&eacute;xico, el portainjerto ‘Nemaguard’ y un almendro (Prunus dulcis), con cinco repeticiones de cada uno. La prueba de variabilidad interna se realiz&oacute; para determinar la homogeneidad o heterogeneidad que presentaban y compararlos entre s&iacute;, lo que servir&iacute;a para relacionar su tipo de reproducci&oacute;n (auto o alogamia).</font></P>     ]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">Los dos primeros CP con valores propios de 9,548 y 4,009 representaron 38,19 y 16,03% de la variabilidad de los datos y lograron explicar el 54,23% de la varianza total. A partir de la proyecci&oacute;n de los individuos de los grupos establecidos (<a href="#f2">Figura 2</a>) se puede apreciar que no existe una tendencia para ninguno de los grupos, por lo que la mayor&iacute;a de &eacute;stos no son homog&eacute;neos.</font></P>     <P align="justify"><font size="2" face="Verdana">A partir de los valores de proyecci&oacute;n del ACP de cada individuo se calcul&oacute;  para cada uno de los k grupos, que en este ejemplo en particular son siete. Tambi&eacute;n se obtuvo el error est&aacute;ndar de cada estimaci&oacute;n (<a href="#f3">Figura 3</a>). Se observa que el almendro presenta el mayor error est&aacute;ndar, lo que se asocia con la existencia de uno o m&aacute;s individuos at&iacute;picos, lo que se observa en la dispersi&oacute;n de las OTU en los dos primeros CP (<a href="#f2">Figura 2</a>).</font></P>      <P align="center"><a name="f2"><img border="0" src="/img/fbpe/inci/v31n11/Image459.jpg" width="378" height="313"></a></P>      
<P align="center"><a name="f3"><img border="0" src="/img/fbpe/inci/v31n11/Image460.jpg" width="318" height="325"></a></P>      
<P align="justify"><font size="2" face="Verdana">El gr&aacute;fico permite determinar que el almendro presenta al menos un individuo at&iacute;pico, por su alto error est&aacute;ndar. Tambi&eacute;n indica que los duraznos de Temascaltepec y Sombrerete son los m&aacute;s homog&eacute;neos del estudio, con bajo valor de la  y del error est&aacute;ndar, as&iacute; como que en este estudio existe una homogeneidad general, a excepci&oacute;n del almendro.</font></P>     <P align="justify"><font size="2" face="Verdana">Con esto se tiene, mediante una gr&aacute;fica y con un solo valor, lo que se tendr&iacute;a que determinar en la obtenci&oacute;n de medidas de dispersi&oacute;n de cada una de las variables evaluadas, lo que representa una disminuci&oacute;n de trabajo y de tiempo.</font></P>      <P align="justify"><font size="2" face="Verdana">Variables morfol&oacute;gicas de tejocote de tres diferentes or&iacute;genes</font></P>     <P align="justify"><font size="2" face="Verdana">En el segundo ejemplo se evaluaron, a partir de datos no publicados de Carlos N&uacute;&ntilde;ez-Col&iacute;n, 46 genotipos de tejocote (Crataegus spp.), 22 accesiones provenientes de Chiapas, 13 de Puebla y 6 del Estado de M&eacute;xico, mediante 27 caracteres morfol&oacute;gicos de toda la planta, en donde se pretende determinar en cu&aacute;l de estos tres or&iacute;genes existe mayor variabilidad, esto se realiza para conocer el nivel de domesticaci&oacute;n, su estado silvestre o ambos, lo que permitir&aacute; discutir su posible centro de origen, as&iacute; como determinar si existen individuos con caracter&iacute;sticas diferentes por su lugar de procedencia.</font></P>     <P align="justify"><font size="2" face="Verdana">Los dos primeros CP con valores propios de 7,984 y 5,183, representaron 29,57 y 19,20% de la variabilidad de los datos y lograron explicar el 48,77% de la varianza total. A partir de la proyecci&oacute;n de los individuos de los grupos establecidos (<a href="#f4">Figura 4</a>) se puede observar que los individuos de Chiapas est&aacute;n distribuidos generalmente en la parte negativa del CP1 y separados de los de los de Puebla y M&eacute;xico, pero existe una gran dispersi&oacute;n en los tres or&iacute;genes.</font></P>      <P align="center"><a name="f4"><img border="0" src="/img/fbpe/inci/v31n11/Image461.jpg" width="377" height="321"></a></P>      
]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">A partir de las coordenadas de cada punto en el gr&aacute;fico se procedi&oacute; al c&aacute;lculo del centroide para obtener la , a la cual se le calcul&oacute; el error est&aacute;ndar para representarlo gr&aacute;ficamente (<a href="#f5">Figura 5</a>). En este caso se puede observar que las accesiones de Puebla presentan una gran dispersi&oacute;n, las de Chiapas una dispersi&oacute;n intermedia y, en contraste, las accesiones del Estado de M&eacute;xico son las m&aacute;s homog&eacute;neas.</font></P>      <P align="center"><a name="f5"><img border="0" src="/img/fbpe/inci/v31n11/Image462.jpg" width="315" height="314"></a></P>      
<P align="justify"><font size="2" face="Verdana">Por el gran error est&aacute;ndar que presenta las accesiones de Puebla se puede intuir que existen algunos genotipos at&iacute;picos dentro de este origen, a lo que se puede deber la alta dispersi&oacute;n. En los de Chiapas, aunque presentan una varianza interna alta, el bajo error est&aacute;ndar permite intuir que no existen individuos at&iacute;picos, mientras que los del Estado de M&eacute;xico son los que presentan mayor homogeneidad.</font></P>      <P align="justify"><font size="2" face="Verdana">Variables anat&oacute;micas de l&iacute;neas de fr&iacute;jol en estr&eacute;s</font></P>     <P align="justify"><font size="2" face="Verdana">En el tercer ejemplo se estudiaron seis diferentes l&iacute;neas de fr&iacute;jol evaluando tres plantas de cada l&iacute;nea, sometidas a estr&eacute;s por exceso de humedad (Hern&aacute;ndez, 2005) mediante 15 variables anat&oacute;micas. Se pretende identificar si cada l&iacute;nea es homog&eacute;nea en las condiciones estudiadas, as&iacute; como, te&oacute;ricamente, cu&aacute;l es la l&iacute;nea m&aacute;s adaptada a condiciones de inundaci&oacute;n.</font></P>     <P align="justify"><font size="2" face="Verdana">Los tres primeros CP con valores propios de 4,32; 2,80 y 2,56 representaron 28,8; 18,66 y 17,07% de la variabilidad de los datos y lograron explicar el 64,53% de la varianza total. A partir de la proyecci&oacute;n de los individuos de las diferentes l&iacute;neas (<a href="#f6">Figura 6</a>), se puede observar que los individuos correspondientes al genotipo 45 se encuentran en la extrema inferior derecha, los del genotipo 33 en la parte izquierda media y los del 13 en el centro de la gr&aacute;fica, las otras l&iacute;neas no presentan una ubicaci&oacute;n t&iacute;pica.</font></P>      <P align="center"><a name="f6"><img border="0" src="/img/fbpe/inci/v31n11/Image463.jpg" width="370" height="317"></a></P>      
<P align="justify"><font size="2" face="Verdana">A partir de las coordenadas de cada punto en el gr&aacute;fico se procedi&oacute; al c&aacute;lculo del centroide para obtener la , a la cual se le calcul&oacute; el error est&aacute;ndar para representarlo gr&aacute;ficamente (<a href="#f7">Figura 7</a>). En este caso se puede observar que las l&iacute;neas 33 y 45 son las m&aacute;s homog&eacute;neas mientras que, por el contrario las l&iacute;neas 64, 13 y 28 son las m&aacute;s heterog&eacute;neas.</font></P>      <P align="center"><a name="f7"><img border="0" src="/img/fbpe/inci/v31n11/Image464.jpg" width="332" height="319"></a></P>      
<P align="justify"><font size="2" face="Verdana">Por el alto error est&aacute;ndar que presentan las l&iacute;neas 28 y 43 se puede intuir que existen algunos individuos at&iacute;picos dentro de esta l&iacute;nea, a lo que se puede deber la alta dispersi&oacute;n. Las l&iacute;neas 13 y 64 presentan una varianza interna alta pero el bajo error est&aacute;ndar permite intuir que no existen individuos at&iacute;picos.</font></P>      ]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">Variables anat&oacute;micas de hoja de aguacate</font></P>     <P align="justify"><font size="2" face="Verdana">En el cuarto ejemplo se estudiaron ocho diferentes genotipos de aguacate evaluando tres plantas de cada genotipo, mediante 12 variables anat&oacute;micas de hoja (Gonz&aacute;lez, 2004). Se pretende identificar la relaci&oacute;n existente entre la anatom&iacute;a de la hoja y el potencial fotosint&eacute;tico.</font></P>     <P align="justify"><font size="2" face="Verdana">Los tres primeros CP con valores propios de 5,1068; 1,696 y 1,4984 representaron 42,56; 14,13 y 12,49% de la variabilidad de los datos y lograron explicar el 69,18% de la varianza total. A partir de la proyecci&oacute;n de los individuos de los genotipos (<a href="#f8">Figura 8</a>) se puede observar que los individuos de los genotipos Hass y Gem se encuentran muy dispersos en diversos cuadrantes, caso similar los correspondientes al Reed, mientras que los otros genotipos presentan una menor dispersi&oacute;n.</font></P>      <P align="center"><a name="f8"><img border="0" src="/img/fbpe/inci/v31n11/Image465.jpg" width="263" height="312"></a></P>      
<P align="justify"><font size="2" face="Verdana">A partir de las coordenadas de cada punto en el gr&aacute;fico se procedi&oacute; al c&aacute;lculo del centroide para obtener la , a la cual se le calcul&oacute; el error est&aacute;ndar para representarlo gr&aacute;ficamente (<a href="#f9">Figura 9</a>). En este caso se puede observar que los genotipos Harvest, Marvel y Nobel son los m&aacute;s homog&eacute;neos y los genotipos Hass y Gem son los m&aacute;s heterog&eacute;neos.</font></P>      <P align="center"><a name="f9"><img border="0" src="/img/fbpe/inci/v31n11/Image466.jpg" width="339" height="307"></a></P>      
<P align="justify"><font size="2" face="Verdana">Por el error est&aacute;ndar alto que presentan los genotipos Hass, Gem y Reed se puede intuir que existen algunos individuos at&iacute;picos dentro de este genotipo, a lo que se puede deber la alta dispersi&oacute;n, probablemente por causas de muestreo ya que se tratan de clones.</font></P>  <B>    <P align="justify"><font size="2" face="Verdana">Consideraciones finales y conclusiones</font></P> </B>     <P align="justify"><font size="2" face="Verdana">La prueba propuesta es una herramienta &uacute;til cuando se requiera encontrar la variabilidad intra-grupo de una serie de datos obtenidos de an&aacute;lisis de caracterizaci&oacute;n y as&iacute; poder evaluar si la media es realmente representativa para cada accesi&oacute;n, si alg&uacute;n dato es muy desproporcionado conforme a los dem&aacute;s datos, o bien describir la variabilidad de grupos preestablecidos.</font></P>     <P align="justify"><font size="2" face="Verdana">Al igual que en la mayor&iacute;a de los an&aacute;lisis multivariables factoriales, para darle una interpretaci&oacute;n biol&oacute;gica a esta prueba el investigador puede correlacionar los vectores propios de las variables m&aacute;s representativas dentro de los valores propios evaluados, a fin de poder explicar en qu&eacute; variables son mayores las diferencias dentro de cada grupo preestablecido.</font></P>     ]]></body>
<body><![CDATA[<P align="justify"><font size="2" face="Verdana">Se debe tomar en cuenta que solamente se est&aacute; evaluando cierto porcentaje de la varianza total, aquella que explican los CP que se utilicen, por lo que se debe tener cuidado en seleccionar el n&uacute;mero adecuado de CP a evaluar y se debe preestablecer los grupos de acuerdo al inter&eacute;s que se tenga.</font></P> <B>     <P align="justify"><font size="2" face="Verdana">REFERENCIAS</font></P> </B>     <!-- ref --><P align="justify"><font size="2" face="Verdana">1. Dur&aacute;n Rodr&iacute;guez R, Sahag&uacute;n Castellanos J (1992) La interacci&oacute;n gen&eacute;tico - ambiental en la genotecnia vegetal. Rev. Chapingo 79-80: 13-16</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013775&pid=S0378-1844200600110000600001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">2. Gonz&aacute;lez-Andr&eacute;s F (2001) Caracterizaci&oacute;n morfol&oacute;gica. En Gonz&aacute;lez-Andr&eacute;s F, Pita Villamil JM (Eds.) Conservaci&oacute;n y caracterizaci&oacute;n de recursos filogen&eacute;ticos. Instituto Nacional de Educaci&oacute;n Agr&iacute;cola. Valladolid, Espa&ntilde;a. pp. 199-217.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013776&pid=S0378-1844200600110000600002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">3. Gonz&aacute;lez Calder&oacute;n VM (2004) Anatom&iacute;a de hojas de ocho cultivares de aguacatero (Persea americana Mill.). Tesis. Universidad Aut&oacute;noma Chapingo. M&eacute;xico. 32 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013777&pid=S0378-1844200600110000600003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">4. Hair JFJr, Anderson RE, Tatham RL, Black WC (2001) An&aacute;lisis Multivariante. 5ª ed. Traducido por Prense E, Cano D. Prentice Hall. Madrid, Espa&ntilde;a. 799 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013778&pid=S0378-1844200600110000600004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">5. Hern&aacute;ndez S&aacute;nchez E (2005) Anatom&iacute;a de xilema de tallo en seis cultivares de frijol (Phaseolus vulgaris L.) en condiciones de exceso de humedad. Tesis. Universidad Aut&oacute;noma Chapingo. M&eacute;xico. 51 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013779&pid=S0378-1844200600110000600005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">6. Infante Gil S, Z&aacute;rate de Lara GP (2000) M&eacute;todos Estad&iacute;sticos, un Enfoque Interdisciplinario. Editorial Trillas. M&eacute;xico. 643 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013780&pid=S0378-1844200600110000600006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">7. Johnson DE (1998) M&eacute;todos Multivariados Aplicados al An&aacute;lisis de Datos. Traducido por P&eacute;rez Castellanos H. International Thomson Editores. M&eacute;xico. 566 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013781&pid=S0378-1844200600110000600007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">8. N&uacute;&ntilde;ez-Col&iacute;n CA, Barrientos-Priego AF (2004) Variabilidad interna, un uso alternativo del an&aacute;lisis en componentes principales. Proc. Interam. Soc. Trop. Horticult. 48: 203-207.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013782&pid=S0378-1844200600110000600008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">9. N&uacute;&ntilde;ez-Col&iacute;n CA, Barrientos-Priego AF, Rodr&iacute;guez-P&eacute;rez JE, Nieto-&Aacute;ngel R (2006) Variabilidad anat&oacute;mica de los sistemas de conducci&oacute;n y estom&aacute;tico de genotipos de Prunus spp. de diferentes or&iacute;genes. Pesq. Agropec. Bras. 41: 233-241.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013783&pid=S0378-1844200600110000600009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify"><font size="2" face="Verdana">10. Sahag&uacute;n Castellanos J (1994) Estad&iacute;stica Descriptiva y Probabilidad, una Perspectiva Biol&oacute;gica. Universidad Aut&oacute;noma Chapingo. M&eacute;xico. 341 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1013784&pid=S0378-1844200600110000600010&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body>
<back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Durán]]></surname>
<given-names><![CDATA[Rodríguez R]]></given-names>
</name>
<name>
<surname><![CDATA[Sahagún]]></surname>
<given-names><![CDATA[Castellanos J]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[La interacción genético - ambiental en la genotecnia vegetal]]></article-title>
<source><![CDATA[Rev. Chapingo]]></source>
<year>1992</year>
<volume>79-80</volume>
<page-range>13-16</page-range></nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[González-Andrés]]></surname>
<given-names><![CDATA[F]]></given-names>
</name>
</person-group>
<source><![CDATA[Caracterización morfológica. En González-Andrés F, Pita Villamil JM (Eds.) Conservación y caracterización de recursos filogenéticos.]]></source>
<year>2001</year>
<page-range>199-217</page-range><publisher-name><![CDATA[Instituto Nacional de Educación Agrícola. Valladolid]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[González Calderón]]></surname>
<given-names><![CDATA[VM]]></given-names>
</name>
</person-group>
<source><![CDATA[Anatomía de hojas de ocho cultivares de aguacatero (Persea americana Mill.).]]></source>
<year>2004</year>
</nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hair]]></surname>
<given-names><![CDATA[JFJr]]></given-names>
</name>
<name>
<surname><![CDATA[Anderson]]></surname>
<given-names><![CDATA[RE]]></given-names>
</name>
<name>
<surname><![CDATA[Tatham]]></surname>
<given-names><![CDATA[RL]]></given-names>
</name>
<name>
<surname><![CDATA[Black]]></surname>
<given-names><![CDATA[WC]]></given-names>
</name>
</person-group>
<source><![CDATA[Análisis Multivariante]]></source>
<year>2001</year>
<page-range>799</page-range><publisher-loc><![CDATA[Madrid ]]></publisher-loc>
<publisher-name><![CDATA[Prentice Hall.]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hernández Sánchez]]></surname>
<given-names><![CDATA[E]]></given-names>
</name>
</person-group>
<source><![CDATA[Anatomía de xilema de tallo en seis cultivares de frijol (Phaseolus vulgaris L.) en condiciones de exceso de humedad]]></source>
<year>2005</year>
<page-range>51</page-range><publisher-name><![CDATA[Universidad Autónoma Chapingo.]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Infante]]></surname>
<given-names><![CDATA[Gil S]]></given-names>
</name>
<name>
<surname><![CDATA[Zárate de Lara]]></surname>
<given-names><![CDATA[GP]]></given-names>
</name>
</person-group>
<source><![CDATA[]]></source>
<year>2000</year>
</nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Johnson]]></surname>
<given-names><![CDATA[DE]]></given-names>
</name>
</person-group>
<source><![CDATA[Métodos Multivariados Aplicados al Análisis de Datos. Traducido por Pérez Castellanos H.]]></source>
<year>1998</year>
<page-range>566</page-range><publisher-name><![CDATA[International Thomson Editores]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Núñez-Colín]]></surname>
<given-names><![CDATA[CA]]></given-names>
</name>
<name>
<surname><![CDATA[Barrientos-Priego]]></surname>
<given-names><![CDATA[AF]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Variabilidad interna, un uso alternativo del análisis en componentes principales]]></article-title>
<source><![CDATA[Proc. Interam. Soc. Trop. Horticult.]]></source>
<year>2004</year>
<volume>48</volume>
<page-range>203-207</page-range></nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Núñez-Colín]]></surname>
<given-names><![CDATA[CA]]></given-names>
</name>
<name>
<surname><![CDATA[Barrientos-Priego]]></surname>
<given-names><![CDATA[AF]]></given-names>
</name>
<name>
<surname><![CDATA[Rodríguez-Pérez]]></surname>
<given-names><![CDATA[JE]]></given-names>
</name>
<name>
<surname><![CDATA[Nieto-Ángel]]></surname>
<given-names><![CDATA[R]]></given-names>
</name>
</person-group>
<article-title xml:lang="es"><![CDATA[Variabilidad anatómica de los sistemas de conducción y estomático de genotipos de Prunus spp]]></article-title>
<source><![CDATA[de diferentes orígenes. Pesq. Agropec. Bras.]]></source>
<year>2006</year>
<volume>41</volume>
<page-range>233-241</page-range></nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Sahagún Castellanos]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<source><![CDATA[Estadística Descriptiva y Probabilidad, una Perspectiva Biológica]]></source>
<year>1994</year>
<page-range>341</page-range><publisher-name><![CDATA[Universidad Autónoma Chapingo]]></publisher-name>
</nlm-citation>
</ref>
</ref-list>
</back>
</article>