<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0798-0264</journal-id>
<journal-title><![CDATA[Archivos Venezolanos de Farmacología y Terapéutica]]></journal-title>
<abbrev-journal-title><![CDATA[AVFT]]></abbrev-journal-title>
<issn>0798-0264</issn>
<publisher>
<publisher-name><![CDATA[Sociedad Venezolana de Farmacológia  y Farmacológia Clínica y Terapéutica. Escuela de MedicinaJosé Maria Vargas. Cátedra de Farmacológia, piso 3, esquina san jacinto, San José Caracas]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0798-02642016000200001</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Aplicación de lógica difusa y algoritmos genéticos para clasificación de tratamientos contra enfermedades neoplásicas malignas]]></article-title>
<article-title xml:lang="en"><![CDATA[Application of fuzzy logic and genetic algorithms for classification of malignant neoplastic diseases treatments]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[León]]></surname>
<given-names><![CDATA[Miguel]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[de Lameda]]></surname>
<given-names><![CDATA[Belkys L]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Lameda]]></surname>
<given-names><![CDATA[Carlos]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Chacon]]></surname>
<given-names><![CDATA[José Gerardo]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Martínez]]></surname>
<given-names><![CDATA[María Sofía]]></given-names>
</name>
<xref ref-type="aff" rid="A05"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Rojas]]></surname>
<given-names><![CDATA[Joselyn]]></given-names>
</name>
<xref ref-type="aff" rid="A03"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Contreras -Velásquez]]></surname>
<given-names><![CDATA[Julio]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Graterol -Rivas]]></surname>
<given-names><![CDATA[Modesto]]></given-names>
</name>
<xref ref-type="aff" rid="A06"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Wilches Durán]]></surname>
<given-names><![CDATA[Sandra]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Aguirre]]></surname>
<given-names><![CDATA[Miguel]]></given-names>
</name>
<xref ref-type="aff" rid="A05"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Vera]]></surname>
<given-names><![CDATA[Miguel]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Cerda]]></surname>
<given-names><![CDATA[Marcos]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Garicano]]></surname>
<given-names><![CDATA[Carlos]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Hernández]]></surname>
<given-names><![CDATA[Juan Diego]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Arias]]></surname>
<given-names><![CDATA[Victor]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Graterol]]></surname>
<given-names><![CDATA[Rosemily]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Chacín]]></surname>
<given-names><![CDATA[Maricarmen]]></given-names>
</name>
<xref ref-type="aff" rid="A05"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Bermúdez]]></surname>
<given-names><![CDATA[Valmore]]></given-names>
</name>
<xref ref-type="aff" rid="A05"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad Centroccidental Lisandro Alvarado (UCLA)  ]]></institution>
<addr-line><![CDATA[Barquisimeto ]]></addr-line>
<country>Venezuela</country>
</aff>
<aff id="A02">
<institution><![CDATA[,Universidad Nacional Experimental Politécnica Antonio José de Sucre  ]]></institution>
<addr-line><![CDATA[Barquisimeto ]]></addr-line>
<country>Venezuela</country>
</aff>
<aff id="A03">
<institution><![CDATA[,Harvard Medical School Brigham and Women’s Hospital Pulmonary and Critical Care Medicine Department]]></institution>
<addr-line><![CDATA[Boston MA]]></addr-line>
<country>USA</country>
</aff>
<aff id="A04">
<institution><![CDATA[,Universidad Simón Bolívar Grupo de investigación Altos Estudios de Frontera (ALEF) ]]></institution>
<addr-line><![CDATA[Cúcuta ]]></addr-line>
<country>Colombia</country>
</aff>
<aff id="A05">
<institution><![CDATA[,Universidad del Zulia Centro de investigación de Enfermedades Endocrino-Metabólicas ]]></institution>
<addr-line><![CDATA[Maracaibo ]]></addr-line>
<country>Venezuela</country>
</aff>
<aff id="A06">
<institution><![CDATA[,Universidad del Zulia Centro de Estudios de la Empresa ]]></institution>
<addr-line><![CDATA[Maracaibo ]]></addr-line>
<country>Venezuela</country>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>06</month>
<year>2016</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>06</month>
<year>2016</year>
</pub-date>
<volume>35</volume>
<numero>2</numero>
<fpage>36</fpage>
<lpage>41</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_arttext&amp;pid=S0798-02642016000200001&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_abstract&amp;pid=S0798-02642016000200001&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_pdf&amp;pid=S0798-02642016000200001&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[Un clasificador difuso es un sistema que asigna una etiqueta de clase a un objeto basado en la descripción del mismo y hace uso de conjuntos difusos como parte de su operación. Su funcionamiento puede ser optimizado mediante algoritmos genéticos, garantizando soluciones viables. El artículo propone un clasificador difuso optimizado utilizando un algoritmo genético hibridado con una técnica de agrupamiento difuso. Se implementa un prototipo y se evalúa con conjuntos de datos referenciales sintéticos como posibles problemas de clasificación de tratamientos contra enfermedades neoplásicas malignas. Se compara los resultados con otros clasificadores encontrados en la literatura sobre los mismos datos de prueba. La conclusión es que el método propuesto obtuvo resultados similares a los comparados con funciones de pertenencia más fáciles de interpretar.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[A fuzzy classifier is a system that assigns a class label to object based on a description of it and makes use of fuzzy sets as part of its operation. Its functioning can be optimized using genetic algorithms, ensuring viable solutions. The paper proposes a fuzzy classifier optimized using a genetic algorithm hybridized with a fuzzy clustering technique. A prototype is implemented and evaluated with synthetic reference data sets as possible classification problems treatments for malignant neoplastic diseases. The results are compared with other classifiers found in the literature on the same test data. The conclusion is that the proposed method obtained similar results with functions easier to interpret.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[lógica difusa]]></kwd>
<kwd lng="es"><![CDATA[algoritmos genéticos]]></kwd>
<kwd lng="es"><![CDATA[clasificador difuso]]></kwd>
<kwd lng="es"><![CDATA[algoritmo genético híbrido]]></kwd>
<kwd lng="es"><![CDATA[enfermedades neoplásicas malignas]]></kwd>
<kwd lng="en"><![CDATA[fuzzy logic]]></kwd>
<kwd lng="en"><![CDATA[genetic algorithms]]></kwd>
<kwd lng="en"><![CDATA[fuzzy classifier]]></kwd>
<kwd lng="en"><![CDATA[hybrid genetic algorithm]]></kwd>
<kwd lng="en"><![CDATA[malignant neoplastic diseases]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[ <p align="center"><font face="Verdana"><b>Aplicación de lógica difusa y  algoritmos genéticos para clasificación de tratamientos contra enfermedades  neoplásicas malignas</b></font></p>     <p align="center"><font face="Verdana"><b>Application of fuzzy logic and genetic  algorithms for classification of malignant neoplastic diseases treatments</b></font></p>     <p align="center"><font face="Verdana" size="2">Miguel León, MgSc<sup>1</sup>,  Belkys L. de Lameda<sup>1</sup>*, Carlos Lameda, MgSc<sup>2</sup>, José Gerardo  Chacon, MgSc, PhD<sup>4</sup>, María Sofía Martínez, MD<sup>5</sup>, Joselyn  Rojas, MD, MgSc<sup>3,5</sup>, Julio Contreras -Velásquez, MgSc<sup>4</sup>,  Modesto Graterol -Rivas, MgSc, PhD<sup>6</sup>, Sandra Wilches Durán, MgSc<sup>4</sup>,  Miguel Aguirre, MD, MgSc<sup>5</sup>, Miguel Vera, MgSc, PhD<sup>4</sup>, Marcos  Cerda, MgSc<sup>4</sup>, Carlos Garicano, MD<sup>4</sup>, Juan Diego Hernández  MD, MgSc<sup>4</sup>, Victor Arias, Ing<sup>4</sup>, Rosemily Graterol, MgSc<sup>4</sup>,  Maricarmen Chacín, MD, MgSc<sup>5</sup>, Valmore Bermúdez, MD, MPH, MgSc, PhD<sup>5</sup></font></p>     <p align="justify"><font face="Verdana" size="2"><sup>1</sup> Universidad  Centroccidental Lisandro Alvarado (UCLA), Barquisimeto, Venezuela</font></p>     <p align="justify"><font face="Verdana" size="2"><sup>2</sup> Universidad  Nacional Experimental Politécnica &quot;Antonio José de Sucre&quot;, Barquisimeto,  Venezuela</font></p>     <p align="justify"><font face="Verdana" size="2"><sup>3</sup> Pulmonary and  Critical Care Medicine Department. Brigham and Women’s Hospital. Harvard Medical  School. Boston, MA. USA 02115.</font></p>     <p align="justify"><font face="Verdana" size="2"><sup>4</sup> Grupo de  investigación Altos Estudios de Frontera (ALEF), Universidad Simón Bolívar,  Cúcuta, Colombia</font></p>     <p align="justify"><font face="Verdana" size="2"><sup>5</sup> Centro de  investigación de Enfermedades Endocrino-Metabólicas. Universidad del Zulia,  Maracaibo, Venezuela.</font></p>     <p align="justify"><font face="Verdana" size="2"><sup>6</sup> Centro de Estudios  de la Empresa. Universidad del Zulia, Maracaibo, Venezuela.</font></p>     <p align="justify"><font face="Verdana" size="2">*Autor para correspondencia:  Belkys L. de Lameda. Universidad Centroccidental Lisandro Alvarado (UCLA).  E-mail: <a href="mailto:belkislopez@cantv.net">belkislopez@cantv.net</a></font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2"><b>Resumen</b></font></p>     <p align="justify"><font face="Verdana" size="2">Un clasificador difuso es un  sistema que asigna una etiqueta de clase a un objeto basado en la descripción  del mismo y hace uso de conjuntos difusos como parte de su operación. Su  funcionamiento puede ser optimizado mediante algoritmos genéticos, garantizando  soluciones viables. El artículo propone un clasificador difuso optimizado  utilizando un algoritmo genético hibridado con una técnica de agrupamiento  difuso. Se implementa un prototipo y se evalúa con conjuntos de datos  referenciales sintéticos como posibles problemas de clasificación de  tratamientos contra enfermedades neoplásicas malignas. Se compara los resultados  con otros clasificadores encontrados en la literatura sobre los mismos datos de  prueba. La conclusión es que el método propuesto obtuvo resultados similares a  los comparados con funciones de pertenencia más fáciles de interpretar.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Palabras Clave: </b>lógica  difusa, algoritmos genéticos, clasificador difuso, algoritmo genético híbrido,  enfermedades neoplásicas malignas.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Abstract</b></font></p>     <p align="justify"><font face="Verdana" size="2">A fuzzy classifier is a system  that assigns a class label to object based on a description of it and makes use  of fuzzy sets as part of its operation. Its functioning can be optimized using  genetic algorithms, ensuring viable solutions. The paper proposes a fuzzy  classifier optimized using a genetic algorithm hybridized with a fuzzy  clustering technique. A prototype is implemented and evaluated with synthetic  reference data sets as possible classification problems treatments for malignant  neoplastic diseases. The results are compared with other classifiers found in  the literature on the same test data. The conclusion is that the proposed method  obtained similar results with functions easier to interpret.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Keywords:</b> fuzzy logic,  genetic algorithms, fuzzy classifier, hybrid genetic algorithm, malignant  neoplastic diseases</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Introducción</b></font></p>     <p align="justify"><font face="Verdana" size="2">En la actualidad los sistemas  de clasificación son usados en aplicaciones de diversas áreas, desde  clasificación automática de correo electrónico (spam), sugerencias de productos  en tiendas virtuales, hasta en módulos de identificación de objetos en el  creciente número de desarrollos de visión artificial<sup>1</sup>. Para ampliar  su uso se deben mejorar cualidades como interpretabilidad y exactitud. La  interpretabilidad de un sistema de clasificación es la capacidad de utilizar y  producir elementos necesarios para el proceso de clasificación que sean fáciles  de comprender y tengan sentido para un usuario humano. En un sistema difuso,  estos elementos pueden ser: la base de reglas, los atributos y variables  lingüísticas utilizados para representar un objeto. Por otra parte, la exactitud  de un clasificador puede entenderse como la proporción de objetos clasificados  correctamente.</font></p>     <p align="justify"><font face="Verdana" size="2">Un clasificador difuso es un  sistema de clasificación que incluye el uso de conjuntos difusos o lógica difusa  como parte de su operación o entrenamiento<sup>2</sup>. El clasificador predice  la etiqueta de clase, mientras la descripción del objeto se presenta en forma de  un vector que contiene los valores de las características (atributos)  considerados relevantes para la tarea de clasificación. Por lo general, el  clasificador aprende a predecir las etiquetas de clase usando un algoritmo de  entrenamiento y un conjunto de datos de entrenamiento.</font></p>     <p align="justify"><font face="Verdana" size="2">Cuando un conjunto de datos de  entrenamiento no está disponible, un clasificador puede ser diseñado a partir de  conocimientos previos y experiencia. Una vez entrenado, el clasificador está  preparado para funcionar en los objetos no conocidos<sup>2,3</sup> Por esta  razón, podría considerarse que un clasificador entrenado, se desempeña de manera  autónoma sobre nuevos conjuntos de datos, sin que haya sido explícitamente  programado para tratar con cada caso específico. Se espera que los  clasificadores difusos puedan separar correctamente un máximo número de  patrones, mientras que el número de características y el número de reglas  difusas puede mantenerse bajo para incrementar la generalidad del sistema y  mejorar su interpretabilidad.</font></p>     ]]></body>
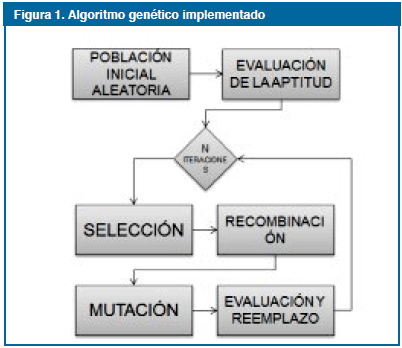
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">Para un clasificador sencillo,  se puede obtener un sistema de clasificación basado en información proporcionada  por expertos humanos; sin embargo, es difícil construir un sistema de  clasificación difusa para un sistema complejo, donde la experiencia del experto  es incompleta<sup>4</sup>. Uno de los tipos de clasificador difuso, quizás el  más común, es el basado en reglas si-entonces, donde cada una de las  características del objeto es asociada a una variable lingüística a la cual  pertenece con cierto grado. Este grado de pertenencia es representado dentro del  sistema con una función que se denomina función de pertenencia.</font></p>     <p align="justify"><font face="Verdana" size="2">Los clasificadores difusos  incluyen una variedad de parámetros configurables, usualmente dependientes de la  apreciación del diseñador o de la experiencia aportada por personas que se  desempeñan en el área determinada. La identificación de los parámetros en un  sistema difuso se compara a un problema de optimización, donde se busca  determinar valores para los parámetros que optimicen el clasificador basándose  en un criterio de evaluación dado. Por lo tanto, pueden también aplicarse  técnicas de optimización y búsqueda para la identificación de parámetros<sup>5</sup>.  Una técnica de optimización y búsqueda ampliamente estudiada, son los algoritmos  genéticos, destacados por un buen balance entre exploración y explotación del  espacio de búsqueda<sup>6</sup>.</font></p>     <p align="justify"><font face="Verdana" size="2">El aprendizaje efectivo de los  datos para el correcto funcionamiento del clasificador difuso depende de  parámetros asociados a los elementos del mismo. La selección puede ser realizada  de manera manual con la ayuda del experto, sin embargo, a menudo resulta  conveniente y más efectivo que estos sean generados automáticamente mediante la  utilización de una técnica de optimización y búsqueda. Los algoritmos genéticos,  son una técnica de optimización y búsqueda que imita el proceso de evolución  natural y en teoría presentan un óptimo balance entre la exploración (búsqueda  global) y explotación (búsqueda local) del espacio de búsqueda<sup>7</sup>.  Pueden ser usados para la identificación de parámetros en el sistema de  clasificación difuso.</font></p>     <p align="justify"><font face="Verdana" size="2">Estos algoritmos usan  principios inspirados por la genética de la población natural, y proveen una  búsqueda robusta en espacios complejos; de este modo ofrecen un enfoque válido a  problemas que requieren búsquedas eficientes y eficaces<sup>6</sup>. También  pueden ser hibridados con otras técnicas de optimización y búsqueda con el fin  de aumentar sus capacidades. Por ejemplo, incorporar métodos de búsqueda local  dentro de la operación de un algoritmo genético puede ayudar a superar la  mayoría de los obstáculos que surgen como resultado de tener tamaños de  población finitos<sup>7</sup>. Además, un sistema híbrido puede acelerar la  velocidad de convergencia mientras se preserva la capacidad del algoritmo  genético de evitar quedar atrapado fácilmente en mínimos locales.</font></p>     <p align="justify"><font face="Verdana" size="2">Tomando como base lo expuesto,  la investigación propone diseñar un clasificador difuso optimizado mediante un  algoritmo genético híbrido.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Metodología</b></font></p>     <p align="justify"><font face="Verdana" size="2">La investigación es proyectiva<sup>8</sup>,  se inicia con una revisión documental de alternativas de optimización de los  clasificadores difusos, el uso de las técnicas de agrupamiento para la  generación inicial de la base de reglas, maneras de optimizar los parámetros de  las funciones de pertenencia, cómo aplicar algoritmos genéticos para la  identificación automática de dichos parámetros, cómo utilizar una función de  objetivo múltiple para la maximización de la exactitud del clasificador, al  igual que la minimización del conjunto de reglas para la conservación de la  interpretabilidad de las variables lingüísticas en el clasificador difuso.</font></p>     <p align="justify"><font face="Verdana" size="2">La siguiente fase es diseñar la  arquitectura de construcción y las partes que lo conforman, incluyendo el  sistema difuso de clasificación y el algoritmo genético híbrido a dos fases para  el entrenamiento, que optimiza los objetivos expuestos previamente. Luego, se  implementa y evalúa el prototipo. Se evalúa teniendo en cuenta atributos como la  exactitud del clasificador en relación al conjunto de datos de entrenamiento, es  decir, la capacidad de aprender el patrón de datos de entrenamiento. La  exactitud se mide con la capacidad de generalización, es decir, la capacidad de  predecir correctamente la etiqueta de clase de objetos no vistos anteriormente  por el clasificador.</font></p>     <p align="justify"><font face="Verdana" size="2">También se tiene en cuenta la  forma de las funciones de pertenencia, la cantidad de variables lingüísticas  utilizadas, el tamaño del conjunto de reglas y la cantidad de variables  utilizadas en las reglas, para realizar un análisis sobre la interpretabilidad  del sistema de clasificación y la capacidad de ser asimilado por un usuario  humano para describir la tarea de clasificación. Finalmente, se compararan los  resultados obtenidos sobre rendimiento e interpretabilidad con otros trabajos y  clasificadores reportados en la literatura sobre los mismos datos de prueba,  para concluir sobre la efectividad del clasificador diseñado.</font></p>     <p align="justify"><font face="Verdana" size="2">El desarrollo del trabajo se  realiza siguiendo una metodología de desarrollo iterativo e incremental. Se  implementa un sistema de clasificación basado en reglas difusas de la forma  si-entonces, que utiliza un algoritmo genético para optimizar la selección de  los parámetros de las funciones de pertenencia y la base de reglas durante el  proceso de entrenamiento del clasificador (<a href="#fig1">Figura 1</a>).</font></p>     ]]></body>
<body><![CDATA[<p align="center"><a name="fig1"> <img border="0" src="/img/fbpe/avft/v35n2/art01fig1.gif" width="402" height="348"></a></p>     
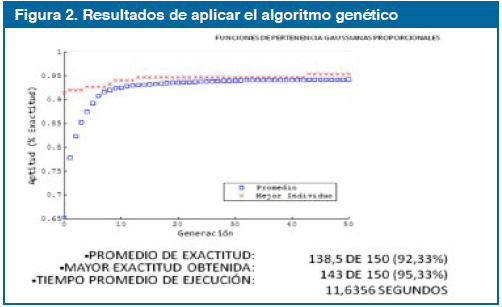
<p align="justify"><font face="Verdana" size="2">El algoritmo genético está a su  vez hibridado con la técnica de búsqueda Fuzzy C-Means Clustering, para mejorar  su efectividad. El híbrido es un algoritmo a dos fases, que ejecuta la técnica  de agrupamiento clustering para construir una base de reglas inicial, con el fin  de aumentar la calidad de las soluciones y producir un sistema final  considerablemente interpretable. Posteriormente, se aplica un algoritmo genético  modificado, que optimiza simultáneamente la base de reglas y los parámetros de  las funciones de pertenencia, utilizando el sistema inicial como punto de  partida para acelerar la velocidad de convergencia en las regiones más  prometedoras, sin dejar atrás su capacidad de exploración del espacio de  búsqueda, los resultados de aplicar este algoritmo se muestran en la  <a href="#fig2">Figura 2</a>.</font></p>     <p align="center"><a name="fig2"> <img border="0" src="/img/fbpe/avft/v35n2/art01fig2.gif" width="502" height="307"></a></p>     
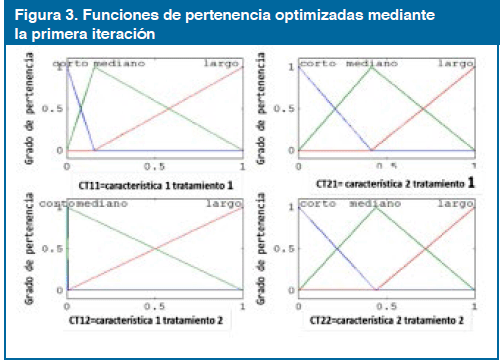
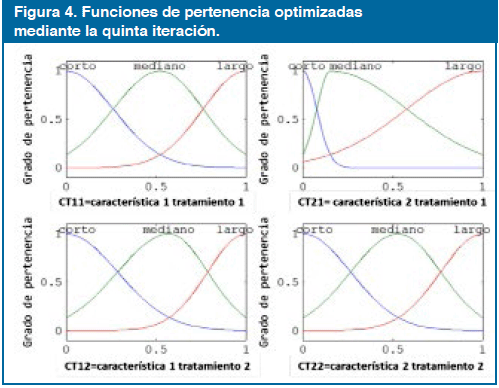
<p align="justify"><font face="Verdana" size="2">La función de evaluación  utilizada en el algoritmo genético está orientada a optimizar un objetivo  múltiple: la maximización de la exactitud del clasificador y aunado a la  minimización del número de reglas. Para la función multiobjetivo, el algoritmo  genético incorpora una población con cadenas de implementación doble de  codificación real para las funciones pertenencia y codificación binaria para el  conjunto de reglas. Se utiliza, para cada uno de los atributos que describen el  objeto a clasificar, un número de variables lingüísticas pequeño «tres», para  contribuir en la mejora de la interpretabilidad.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Resultados</b></font></p>     <p align="justify"><font face="Verdana" size="2">En la evaluación del sistema,  se comprueba con conjuntos de datos referenciales «benchmark»; el primer caso  puede constituir un problema de clasificación de datos sintéticos que pueden  representar un tipo de enfermedad «E1», cuyo estudio es común entre  investigaciones de sistemas de clasificación; y el segundo caso representa una  variación en los datos que pueden representar una segunda enfermedad «E2». Con  los resultados obtenidos se realizan comparaciones de desempeño con otras  investigaciones y sistemas desarrollados.</font></p>     <p align="justify"><font face="Verdana" size="2">El problema de clasificación de  la data sintética 1 «DA1», es un problema referencial (benchmark) en estudios de  clasificación y reconocimiento de patrones. Contiene 150 medidas que representan  dos tratamientos para la enfermedad 1, con cuatro características; dos  características para el tratamiento 1 y dos características para el tratamiento  2; en 50 muestras para cada una de tres tipos de pacientes clasificados por  edad: pacientes menores de 20 años, pacientes entre 20 a 40 años, y pacientes  mayores de 40 años.</font></p>     <p align="justify"><font face="Verdana" size="2">El sistema propuesto, consta de  tres funciones de pertenencia representativas de tres variables lingüísticas:  «corto», «mediano» y «largo»; para cada una de las cuatro variables de entrada  del clasificador, correspondientes a las características en el conjunto de  datos. En la elaboración del sistema de clasificación, se utiliza dentro del  ambiente MATLAB, la herramienta Fuzzy Logic Toolbox, que provee funciones y  aplicaciones para el análisis, diseño y simulación de sistemas basados en lógica  difusa.</font></p>     <p align="justify"><font face="Verdana" size="2">En una primera iteración se  utilizaron funciones de pertenencia triangulares para representar los valores de  las variables lingüísticas. La base de reglas, presenta cuatro reglas  previamente definidas por<sup>9</sup>, luego se establecen restricciones a las  posibles variaciones en la distribución de funciones de pertenencia para  simplificar el sistema de inferencia e incrementar la interpretabilidad del  sistema por un experto humano. Se construye el algoritmo genético básico que  tendría el objetivo de mejorar el porcentaje de exactitud en la clasificación de  los datos de entrenamiento, únicamente optimizando los parámetros de las  funciones de pertenencia de las variables de entrada.</font></p>     <p align="justify"><font face="Verdana" size="2">Luego de la ejecución de este  sistema inicial, se observa un techo en el mejoramiento de la exactitud del  clasificador en el problema de la Flor de Iris, que permite establecer criterios  para la generación de sistemas de clasificación difusos fácilmente  interpretables y explicables por parte de humanos (<a href="#fig3">Figura 3</a>). En la segunda  iteración, se disminuye las restricciones establecidas en la primera iteración,  con lo cual el espacio de búsqueda para la evolución de funciones de pertenencia  resulta demasiado grande como para atender a condiciones de interpretabilidad.  La cantidad de posibles soluciones no compensó la carga computacional agregada  para el problema de E1.</font></p>     ]]></body>
<body><![CDATA[<p align="center"><a name="fig3"> <img border="0" src="/img/fbpe/avft/v35n2/art01fig3.gif" width="502" height="363"></a></p>     
<p align="justify"><font face="Verdana" size="2">Varios autores<sup>10,11</sup>,  sugieren el uso de funciones de pertenencia Gaussianas, exponen que estas sirven  para no dejar partes del espacio de entrada sin cubrir como sucede con las  funciones de pertenencia triangulares<sup>2</sup>, al mismo tiempo que los  modelos resultantes presentan mayor exactitud<sup>12</sup>. En la tercera  iteración se utilizan funciones de pertenencia Gaussianas para representar los  valores de las variables lingüísticas, obteniendo un mejor desempeño. Se diseñan  dos versiones: una que permita la evolución independiente de los parámetros de  las funciones; la otra tiene una restricción que mantiene una concordancia entre  las funciones de pertenencia. El uso de funciones de pertenencia Gaussianas, en  particular, las funciones de pertenencia independientes, muestran un incremento  en techo de exactitud, aunque se obtiene una menor interpretabilidad.</font></p>     <p align="justify"><font face="Verdana" size="2">En la cuarta iteración, se  propone evolucionar la base de reglas del clasificador, junto con los parámetros  de las funciones de pertenencia, con el fin de aumentar el proceso de  optimización y crear un clasificador más complejo. Para evolucionar la base de  reglas simultáneamente con los parámetros de las funciones de pertenencia, se  modifica el algoritmo genético y la codificación de los cromosomas. Una parte de  los cromosomas se codifican de forma mixta, conservando la codificación original  para guardar los valores para los parámetros de las funciones de pertinencia. La  otra porción de los cromosomas se codifican con una representación binaria,  siendo más conveniente para representar la base de reglas.</font></p>     <p align="justify"><font face="Verdana" size="2">El uso de codificaciones de  población mixtas resulta ser práctico para la optimización simultánea de  elementos de diferente naturaleza, al mismo tiempo que los operadores  modificados del algoritmo genético siguen manteniendo sus propiedades. El  algoritmo genético funciona con buena efectividad sobre la optimización de  objetivos múltiples, comprobando que se puede generar un clasificador con un  alto desempeño y mínimo número de reglas, aunque se utilicen pocas funciones de  pertenencia.</font></p>     <p align="justify"><font face="Verdana" size="2">Para la quinta iteración se  desea mejorar la velocidad de convergencia del algoritmo genético y aumentar su  capacidad para conseguir mejores soluciones en la configuración del  clasificador. Para ello se modifica el proceso de optimización, combinando el  algoritmo genético con otra técnica de optimización y búsqueda, en sus estudios<sup>12,13,14</sup>  proponen la inicialización del espacio de búsqueda, utilizando métodos  iterativos como algoritmos de agrupamiento para descubrir reglas difusas a  partir de los datos de entrenamiento. El propósito de los algoritmos de  agrupamiento es identificar agrupaciones naturales en la información de  conjuntos de datos amplios para producir una representación concisa del  comportamiento de un sistema<sup>15</sup>. Fuzzy Logic Toolbox provee funciones  para el análisis de datos a través de algoritmos de Clustering, entre ellos el  algoritmo Fuzzy C-Means Clustering (FCM), el cual es una técnica de agrupamiento  de datos, en el que cada punto de dato pertenece en cierto grado a cada grupo  (cluster).</font></p>     <p align="justify"><font face="Verdana" size="2">El FCM produce principalmente  dos resultados, el conjunto difuso que indica el valor de pertenencia de cada  punto para cada grupo, y las coordenadas n-dimensionales de los centroides o  baricentros de los grupos. En otras investigaciones<sup>16,12</sup>, se utiliza  Fuzzy Clustering para producir un número de grupos igual o mayor al número de  clases posibles. Luego se formula una regla para cada grupo, de forma que cada  variable de entrada corresponda a una sola función de pertenencia.</font></p>     <p align="justify"><font face="Verdana" size="2">Se propone utilizar un nuevo  método heurístico para la formulación de reglas utilizando FCM como paso previo,  en combinación a la optimización interpretada por el algoritmo genético, para  lograr una hibridación en forma de algoritmo a dos fases. El método fija  inicialmente la cantidad de funciones de pertenencia (variables lingüísticas)  para determinar, a partir de los grupos, los parámetros de estas funciones en  anticipación a la formulación de las reglas.</font></p>     <p align="justify"><font face="Verdana" size="2">El nuevo método propuesto para  generar sistemas iniciales, evidencia ser más efectivo; utilizar un  procedimiento heurístico para derivar las funciones de pertenencia manteniendo  las restricciones resulta ser práctico y de bajo costo computacional. Además, la  inicialización del espacio de búsqueda genera mejores soluciones con respecto a  la exactitud del clasificador, aunque el número de reglas no se pueda llevar al  mínimo, las reglas pertenecientes a una misma clase resultan muy similares,  permitiendo ser combinadas intuitivamente por un humano o algún algoritmo objeto  de otro trabajo. La proposición del uso de tres variables lingüísticas facilita  la formulación de las reglas en lenguaje humano aumentando aún más las  interpretabilidad del sistema. La <a href="#fig4">Figura 4</a> muestra las Funciones de Pertenencia  Optimizadas mediante la quinta iteración.</font></p>     <p align="center"><a name="fig4"> <img border="0" src="/img/fbpe/avft/v35n2/art01fig4.gif" width="499" height="388"></a></p>     
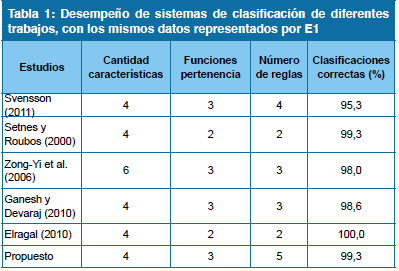
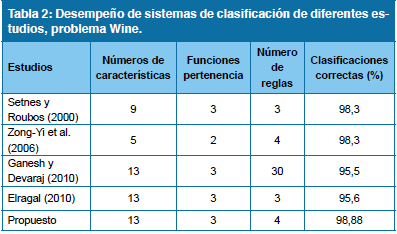
<p align="justify"><font face="Verdana" size="2">Los problemas utilizados para  la comprobación del presente trabajo, son problemas referenciales (benchmark) en  estudios de clasificación y reconocimiento de patrones. Esto permite la  comparación de los resultados con otros trabajos en la literatura. La  <a href="#tab1">Tabla 1</a>  muestra los resultados de diferentes trabajos sobre el problema de clasificación  con los mismos datos empleados en el caso de para tratamiento 1. Los trabajos  que obtienen mayor porcentaje de exactitud en la clasificación fueron los de<sup>12,17</sup>  sin embargo éstos usan un modelo de clasificador que emite como salida un único  valor numérico, el cual es extrapolado para obtener la etiqueta de clase.</font></p>     ]]></body>
<body><![CDATA[<p align="center"><a name="tab1"> <img border="0" src="/img/fbpe/avft/v35n2/art01tab1.gif" width="399" height="271"></a></p>     
<p align="justify"><font face="Verdana" size="2">Trabajar con un número de  reglas menor al número de dos clases, que se interpolan para generar salidas de  tres clases distintas, descarta la posibilidad de interpretación del sistema por  parte de humanos. En contraste, el sistema utilizado en este trabajo emite una  salida para cada clase y determina la etiqueta de clase mediante el principio de  “el ganador se lo lleva todo” (winner-take-all). En cualquier caso, las  funciones de pertenencia y las variables lingüísticas de este trabajo, podrían  considerarse como las que poseen mayor sentido semántico. Por otra parte, la  <a href="#tab2">Tabla 2</a> muestra los resultados de diferentes trabajos sobre el problema  representados por E2.</font></p>     <p align="center"><a name="tab2"> <img border="0" src="/img/fbpe/avft/v35n2/art01tab2.gif" width="397" height="234"></a></p>     
<p align="justify"><font face="Verdana" size="2">Los estudios de<sup>12,13</sup>,  incorporan un método de selección de características para reducir la cantidad de  variables de entradas; sin embargo, no superan el porcentaje de exactitud de  este estudio, que resulta ser el mayor de entre los trabajos comparados, con una  cantidad viable de reglas. La minimización de características podría ser un  punto interesante de incorporar como objetivo adicional al método de  optimización.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Conclusiones</b></font></p>     <p align="justify"><font face="Verdana" size="2">El principal hallazgo es que el  procedimiento heurístico para derivar las funciones de pertenencia manteniendo  las restricciones, de la quinta iteración resulta ser más efectivo y de bajo  costo computacional. El clasificador propuesto genera resultados con exactitud,  así como funciones de pertenencia con mayor sentido semántico, comparados con  resultados de otros estudios contrastados.</font></p>     <p align="justify"><font face="Verdana" size="2">Los resultados de esta  investigación sugieren la posibilidad de implementar clasificadores difusos  semejantes al diseñado en entornos donde se requiera la verificación o  entendimiento de los procesos automáticos por parte del humano, reemplazando  procesos de caja negra.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>Referencias</b></font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">1. Tan P, Steinbach M, Kumar V.  Introduction to Data Mining. Boston:Pearson;2005.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602743&pid=S0798-0264201600020000100001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">2. Kuncheva L. Studies in  Fuzziness and Soft Computing, Fuzzy Classifier Design. UK:Physica-Verlag; 2000.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602744&pid=S0798-0264201600020000100002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">3. Toosi AN, Kahani M. A new  approach to intrusion detection based on an evolutionary soft computing model  using neuro-fuzzy classifiers. Computer communications, 2007;30(10):2201-12.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602745&pid=S0798-0264201600020000100003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">4. Zong-yi X, Yuan-long H,  Zhong-zhi T, Li-min J. Construction of Fuzzy Classification System Based on  Multi-objective Genetic Algorithm. Sixth International Conference on Intelligent  Systems Design and Applications, ISDA’06 IEEE Computer Society. 2006;2: 1029–34.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602746&pid=S0798-0264201600020000100004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">5. Yen J, Langari R. Fuzzy  logic: intelligence, control, and information. USA:Prentice-Hall Inc;1999.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602747&pid=S0798-0264201600020000100005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">6. Cordón O, Herrera F,  Hoffmann F, Magdalena L. Genetic fuzzy systems. Singapore: World Scientific  Publishing Company;2001.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602748&pid=S0798-0264201600020000100006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">7. El-Mihoub T, Hopgood A,  Nolle L, Battersby A. Hybrid Genetic Algorithms: A Review. Engineering Letters,  2007;13(2):124-37.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602749&pid=S0798-0264201600020000100007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">8. Hurtado de Barrera J.  Metodología de la Investigación Holística. Venezuela: Fundación SYPAL; 2012.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602750&pid=S0798-0264201600020000100008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">9. Ishibuchi H, Nozaki K,  Yamamoto N, Tanaka H. Selecting fuzzy ifthen rules for classification problems  using genetic algorithms. IEEE Transactions on Fuzzy Systems, 1995;3(3):260-70.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602751&pid=S0798-0264201600020000100009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">10. Abe S. Pattern  Classification: Neuro-fuzzy methods and their comparison. UK:Springer Verlag;2001.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602752&pid=S0798-0264201600020000100010&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">11. Chiu, S. Extracting fuzzy  rules from data for function approximation and pattern classification. Fuzzy  Information Engineering: A Guided Tour of Applications. New Jersey:John Wiley &amp;  Sons;1997.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602753&pid=S0798-0264201600020000100011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">12. Setnes M, Roubos H. GA-fuzzy  modeling and classification: complexity and performance. IEEE Transactions on  Fuzzy Systems, 2000;8(5):509-22.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602754&pid=S0798-0264201600020000100012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">13. Zong-Yi X, Yuan-Long H,  Yong Z, Li-Min J. A Multi-objective GA based Fuzzy Modeling Approach for  Constructing Pareto-optimal Fuzzy systems. International Journal of Computer  Science and Network Security, 2007;6(5):213-19.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602755&pid=S0798-0264201600020000100013&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">14. Pulkkinen P. Multiobjective  identification of fuzzy models with hybrid methods. International Journal of  Approximate Reasoning, 2008;48(2):526-43.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602756&pid=S0798-0264201600020000100014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">15. D’Urso P, Massari R. Fuzzy  clustering of human activity patterns. Fuzzy Sets and Systems, 2013;215:29-54.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602757&pid=S0798-0264201600020000100015&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">16. Abonyi J, Szeifert F.  Supervised fuzzy clustering for the identification of fuzzy classifiers. Pattern  Recognition Letters, 2003;24(14):2195- 207.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602758&pid=S0798-0264201600020000100016&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">17. Elragal H. Using Swarm  Intelligence for Improving Accuracy of Fuzzy Classifiers. International Journal  of Electrical and Computer Engineering, 2010;5(2):105-12.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=602759&pid=S0798-0264201600020000100017&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body>
<back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Tan]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
<name>
<surname><![CDATA[Steinbach]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[Kumar]]></surname>
<given-names><![CDATA[V]]></given-names>
</name>
</person-group>
<source><![CDATA[Introduction to Data Mining]]></source>
<year>2005</year>
<publisher-loc><![CDATA[Boston ]]></publisher-loc>
<publisher-name><![CDATA[Pearson]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Kuncheva]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
</person-group>
<source><![CDATA[Studies in Fuzziness and Soft Computing, Fuzzy Classifier Design]]></source>
<year>2000</year>
<publisher-name><![CDATA[Physica-Verlag]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Toosi]]></surname>
<given-names><![CDATA[AN]]></given-names>
</name>
<name>
<surname><![CDATA[Kahani]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A new approach to intrusion detection based on an evolutionary soft computing model using neuro-fuzzy classifiers]]></article-title>
<source><![CDATA[Computer communications]]></source>
<year>2007</year>
<volume>30</volume>
<numero>10</numero>
<issue>10</issue>
<page-range>2201-12</page-range></nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="confpro">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Zong-yi]]></surname>
<given-names><![CDATA[X]]></given-names>
</name>
<name>
<surname><![CDATA[Yuan-long]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
<name>
<surname><![CDATA[Zhong-zhi]]></surname>
<given-names><![CDATA[T]]></given-names>
</name>
<name>
<surname><![CDATA[Li-min]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<source><![CDATA[Construction of Fuzzy Classification System Based on Multi-objective Genetic Algorithm]]></source>
<year>2006</year>
<volume>2</volume>
<conf-name><![CDATA[Sixth International Conference on Intelligent Systems Design and Applications, ISDA’06 IEEE Computer Society]]></conf-name>
<conf-loc> </conf-loc>
<page-range>1029-34</page-range></nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Yen]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Langari]]></surname>
<given-names><![CDATA[R]]></given-names>
</name>
</person-group>
<source><![CDATA[Fuzzy logic: intelligence, control, and information]]></source>
<year>1999</year>
<publisher-name><![CDATA[Prentice-Hall Inc]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Cordón]]></surname>
<given-names><![CDATA[O]]></given-names>
</name>
<name>
<surname><![CDATA[Herrera]]></surname>
<given-names><![CDATA[F]]></given-names>
</name>
<name>
<surname><![CDATA[Hoffmann]]></surname>
<given-names><![CDATA[F]]></given-names>
</name>
<name>
<surname><![CDATA[Magdalena]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
</person-group>
<source><![CDATA[Genetic fuzzy systems]]></source>
<year>2001</year>
<publisher-loc><![CDATA[Singapore ]]></publisher-loc>
<publisher-name><![CDATA[World Scientific Publishing Company]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[El-Mihoub]]></surname>
<given-names><![CDATA[T]]></given-names>
</name>
<name>
<surname><![CDATA[Hopgood]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Nolle]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
<name>
<surname><![CDATA[Battersby]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Hybrid Genetic Algorithms: A Review]]></article-title>
<source><![CDATA[Engineering Letters]]></source>
<year>2007</year>
<volume>13</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>124-37</page-range></nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hurtado de Barrera]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<source><![CDATA[Metodología de la Investigación Holística]]></source>
<year>2012</year>
<publisher-name><![CDATA[Fundación SYPAL]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Ishibuchi]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
<name>
<surname><![CDATA[Nozaki]]></surname>
<given-names><![CDATA[K]]></given-names>
</name>
<name>
<surname><![CDATA[Yamamoto]]></surname>
<given-names><![CDATA[N]]></given-names>
</name>
<name>
<surname><![CDATA[Tanaka]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Selecting fuzzy ifthen rules for classification problems using genetic algorithms]]></article-title>
<source><![CDATA[IEEE Transactions on Fuzzy Systems]]></source>
<year>1995</year>
<volume>3</volume>
<numero>3</numero>
<issue>3</issue>
<page-range>260-70</page-range></nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Abe]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<source><![CDATA[Pattern Classification: Neuro-fuzzy methods and their comparison]]></source>
<year>2001</year>
<publisher-name><![CDATA[Springer Verlag]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B11">
<label>11</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chiu]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<source><![CDATA[Extracting fuzzy rules from data for function approximation and pattern classification: Fuzzy Information Engineering: A Guided Tour of Applications]]></source>
<year>1997</year>
<publisher-loc><![CDATA[New Jersey ]]></publisher-loc>
<publisher-name><![CDATA[John Wiley & Sons]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B12">
<label>12</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Setnes]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[Roubos]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[GA-fuzzy modeling and classification: complexity and performance]]></article-title>
<source><![CDATA[IEEE Transactions on Fuzzy Systems]]></source>
<year>2000</year>
<volume>8</volume>
<numero>5</numero>
<issue>5</issue>
<page-range>509-22</page-range></nlm-citation>
</ref>
<ref id="B13">
<label>13</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Zong-Yi]]></surname>
<given-names><![CDATA[X]]></given-names>
</name>
<name>
<surname><![CDATA[Yuan-Long]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
<name>
<surname><![CDATA[Yong]]></surname>
<given-names><![CDATA[Z]]></given-names>
</name>
<name>
<surname><![CDATA[Li-Min]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A Multi-objective GA based Fuzzy Modeling Approach for Constructing Pareto-optimal Fuzzy systems]]></article-title>
<source><![CDATA[International Journal of Computer Science and Network Security]]></source>
<year>2007</year>
<volume>6</volume>
<numero>5</numero>
<issue>5</issue>
<page-range>213-19</page-range></nlm-citation>
</ref>
<ref id="B14">
<label>14</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Pulkkinen]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Multiobjective identification of fuzzy models with hybrid methods]]></article-title>
<source><![CDATA[International Journal of Approximate Reasoning]]></source>
<year>2008</year>
<volume>48</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>526-43</page-range></nlm-citation>
</ref>
<ref id="B15">
<label>15</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[D’Urso]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
<name>
<surname><![CDATA[Massari]]></surname>
<given-names><![CDATA[R]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Fuzzy clustering of human activity patterns]]></article-title>
<source><![CDATA[Fuzzy Sets and Systems]]></source>
<year>2013</year>
<volume>215</volume>
<page-range>29-54</page-range></nlm-citation>
</ref>
<ref id="B16">
<label>16</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Abonyi]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Szeifert]]></surname>
<given-names><![CDATA[F]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Supervised fuzzy clustering for the identification of fuzzy classifiers]]></article-title>
<source><![CDATA[Pattern Recognition Letters]]></source>
<year>2003</year>
<volume>24</volume>
<numero>14</numero>
<issue>14</issue>
<page-range>2195- 207</page-range></nlm-citation>
</ref>
<ref id="B17">
<label>17</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Elragal]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Using Swarm Intelligence for Improving Accuracy of Fuzzy Classifiers]]></article-title>
<source><![CDATA[International Journal of Electrical and Computer Engineering]]></source>
<year>2010</year>
<volume>5</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>105-12</page-range></nlm-citation>
</ref>
</ref-list>
</back>
</article>