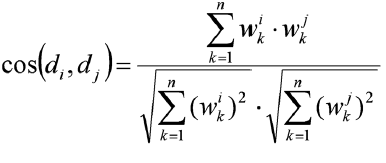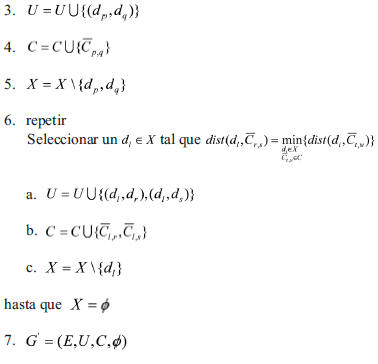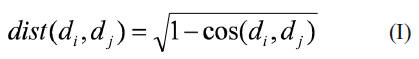
<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>1316-4821</journal-id>
<journal-title><![CDATA[Universidad, Ciencia y Tecnología]]></journal-title>
<abbrev-journal-title><![CDATA[uct]]></abbrev-journal-title>
<issn>1316-4821</issn>
<publisher>
<publisher-name><![CDATA[AutanaBooks S.A.S. Revista de la Universidad Experimental Politécnica Antonio José de Sucre, Vice Rectorado Puerto Ordaz, Venezuela, gestionada en Ecuador por AutanaBooks]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S1316-48212008000300007</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Cálculo de la vecindad mediante grafos en minería de textos]]></article-title>
<article-title xml:lang="en"><![CDATA[VICINITY CALCULATION WITH GRAPHS IN TEXT MINING]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Artigas Fuentes]]></surname>
<given-names><![CDATA[Fernando]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Gil García]]></surname>
<given-names><![CDATA[Reynaldo]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Badía Contelles]]></surname>
<given-names><![CDATA[José Manuel]]></given-names>
</name>
<xref ref-type="aff" rid="A03"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Pons Porrata]]></surname>
<given-names><![CDATA[Aurora]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad de Oriente Facultad de Matemática y Computación ]]></institution>
<addr-line><![CDATA[Santiago de Cuba ]]></addr-line>
</aff>
<aff id="A02">
<institution><![CDATA[,Universidad de Oriente Facultad de Matemática y Computación ]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
</aff>
<aff id="A03">
<institution><![CDATA[,Universidad Jacume I Dpto. de Ingeniería y Ciencia de los Computadores ]]></institution>
<addr-line><![CDATA[Castellón ]]></addr-line>
<country>España</country>
</aff>
<aff id="A04">
<institution><![CDATA[,Universidad de Oriente Facultad de Matemática y Computación ]]></institution>
<addr-line><![CDATA[Santiago de Cuba ]]></addr-line>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>07</month>
<year>2008</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>07</month>
<year>2008</year>
</pub-date>
<volume>12</volume>
<numero>48</numero>
<fpage>163</fpage>
<lpage>170</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_arttext&amp;pid=S1316-48212008000300007&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_abstract&amp;pid=S1316-48212008000300007&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_pdf&amp;pid=S1316-48212008000300007&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[La búsqueda de los documentos más semejantes a uno dado es fundamental en la Minería de Textos, pues es el procedimiento básico de muchas técnicas como la clasificación o la recuperación de información. Los documentos suelen representarse en un espacio de rasgos de alta dimensionalidad, donde cada término que ocurre en el documento se trata como un rasgo y el peso de cada término refleja su importancia en el documento. Existen multitud de técnicas para buscar la vecindad de un objeto, pero disminuyen drásticamente sus prestaciones a medida que crecen las dimensiones. Este problema imposibilita su aplicación al caso de los documentos. En este artículo se presenta un método de acceso basado en una estructura de grafo que determina de forma aproximada la vecindad de un nuevo documento. El método obtenido presenta una selectividad alta y una tasa de error aceptable cuando se usa embebido en un clasificador, comparándolo con el método exhaustivo que evalúa el 100% de los documentos. Como resultado del estudio se concluye que es factible el uso del método propuesto en problemas de muy alta dimensionalidad, como es el caso de la Minería de Textos.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[Searching the most similar documents to a given one is crucial in Text Mining because it is the basic process of many techniques like classification or information retrieval. The documents are usually represented in high-dimensional feature space, where each term appeared in documents is treated as features and the weight of each term reflects its importance in the document. There are many approaches to find the vicinity of an object, but their performance drastically decreases as the number of dimensions grows. This problem prevents its application for documents. In this paper, we present an access method based on a graph structure that determines in an approximate way the vicinity of a novel document. The obtained method has a high selectivity and an acceptable error rate when it is embedded in a classifier and compared with the exhaustive method that evaluates all documents. Our experimental analysis shows that it is feasible the use of the proposed method in problems of very high dimensionality, such as Text Mining.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[Minería de datos]]></kwd>
<kwd lng="es"><![CDATA[Minería de textos]]></kwd>
<kwd lng="es"><![CDATA[Métodos de acceso]]></kwd>
<kwd lng="es"><![CDATA[Indexado en muy alta dimensionalidad]]></kwd>
<kwd lng="es"><![CDATA[Cálculo de la vecindad]]></kwd>
<kwd lng="en"><![CDATA[Data Mining]]></kwd>
<kwd lng="en"><![CDATA[Text Mining]]></kwd>
<kwd lng="en"><![CDATA[Access Methods]]></kwd>
<kwd lng="en"><![CDATA[Very high-dimensional indexing]]></kwd>
<kwd lng="en"><![CDATA[Neighborhood calculation]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[ <p align="center"><b><font face="Verdana">CÁLCULO DE LA VECINDAD MEDIANTE GRAFOS  EN MINERÍA DE TEXTOS </font></b></p>     <p align="center"><font face="Verdana" size="2">Artigas Fuentes, Fernando Gil  García, Reynaldo Badía Contelles, José Manuel Pons Porrata, Aurora </font></p>     <p align="center"><font face="Verdana" size="2">El MSc. Fernando Artigas Fuentes  es Profesor Asistente en el Centro de Estudios de Reconocimiento de Patrones y  Minería de Datos (CERPAMID) Facultad de Matemática y Computación, Universidad de  Oriente, Patricio Lumumba S/N, Santiago de Cuba, telef. (53) 22-635346, correos  electrónicos <a href="mailto:artigas@csd.uo.edu.cu">artigas@csd.uo.edu.cu</a>&nbsp;  y <a href="mailto:artigas@cerpamid.co.cu">artigas@cerpamid.co.cu</a>. </font> </p>     <p align="center"><font face="Verdana" size="2">El Dr. Reynaldo Gil García es  Profesor Auxiliar en el mismo Centro, mismo teléfono, correos electrónicos <a href="mailto:gil@csd.uo.edu.cu">gil@csd.uo.edu.cu</a>&nbsp; y <a href="mailto:gil@cerpamid.co.cu">gil@cerpamid.co.cu</a>. </font></p>     <p align="center"><font face="Verdana" size="2">El dr. José Manuel Badía  Contelles es Profesor Titular en el Dpto. de Ingeniería y Ciencia de los  Computadores, Universidad Jacume I, Av. Los Baynat s/n, 12071, Castellón,  España, Teléfono (34) 964728281, correo electrónico <a href="mailto:badia@icc.uji.es">badia@icc.uji.es</a>. </font></p>     <p align="center"><font face="Verdana" size="2">La Dra. Aurora Pons Porrata es  Profesora Titular en el CERPAMID, misma dirección y teléfono ya citados, correos  electrónicos <a href="mailto:aurora@csd.uo.edu.cu">aurora@csd.uo.edu.cu</a>&nbsp;  y <a href="mailto:aurora@cerpamid.co.cu">aurora@cerpamid.co.cu</a> .</font></p>     <p><b><font face="Verdana" size="2">Resumen: </font></b></p>     <p align="justify"><font face="Verdana" size="2">La búsqueda de los documentos más semejantes a  uno dado es fundamental en la Minería de Textos, pues es el procedimiento básico  de muchas técnicas como la clasificación o la recuperación de información. Los  documentos suelen representarse en un espacio de rasgos de alta dimensionalidad,  donde cada término que ocurre en el documento se trata como un rasgo y el peso  de cada término refleja su importancia en el documento. Existen multitud de  técnicas para buscar la vecindad de un objeto, pero disminuyen drásticamente sus  prestaciones a medida que crecen las dimensiones. Este problema imposibilita su  aplicación al caso de los documentos. En este artículo se presenta un método de  acceso basado en una estructura de grafo que determina de forma aproximada la  vecindad de un nuevo documento. El método obtenido presenta una selectividad  alta y una tasa de error aceptable cuando se usa embebido en un clasificador,  comparándolo con el método exhaustivo que evalúa el 100% de los documentos. Como  resultado del estudio se concluye que es factible el uso del método propuesto en  problemas de muy alta dimensionalidad, como es el caso de la Minería de Textos.</font></p>     <p align="justify"><font face="Verdana" size="2"><b>&nbsp;Palabras clave:</b> Minería de datos/  Minería de textos/ Métodos de acceso/ Indexado en muy alta dimensionalidad/  Cálculo de la vecindad. </font></p>     <p align="justify"><b><font face="Verdana" size="2">VICINITY CALCULATION WITH GRAPHS IN TEXT  MINING </font></b></p>     ]]></body>
<body><![CDATA[<p align="justify"><b><font face="Verdana" size="2">Summary: </font></b></p>     <p align="justify"><font face="Verdana" size="2">Searching the most similar documents to a given  one is crucial in Text Mining because it is the basic process of many techniques  like classification or information retrieval. The documents are usually  represented in high-dimensional feature space, where each term appeared in  documents is treated as features and the weight of each term reflects its  importance in the document. There are many approaches to find the vicinity of an  object, but their performance drastically decreases as the number of dimensions  grows. This problem prevents its application for documents. In this paper, we  present an access method based on a graph structure that determines in an  approximate way the vicinity of a novel document. The obtained method has a high  selectivity and an acceptable error rate when it is embedded in a classifier and  compared with the exhaustive method that evaluates all documents. Our  experimental analysis shows that it is feasible the use of the proposed method  in problems of very high dimensionality, such as Text Mining. </font></p>     <p align="justify"><font face="Verdana" size="2"><b>Keywords:</b> Data Mining/ Text Mining/  Access Methods/ Very high-dimensional indexing/ Neighborhood calculation. </font> </p>     <p align="justify"><font face="Verdana" size="2">Manuscrito finalizado en Santiago de Cuba, el  2008/01/10, recibido el 2008/02/07, en su forma final (aceptado) el 2008/03/10. </font></p>     <p align="justify"><font face="Verdana" size="2"><b>I. INTRODUCCIÓN</b> </font> </p>     <p align="justify"><font face="Verdana" size="2">La búsqueda de los documentos más semejantes a uno dado es fundamental en la  Minería de Textos, pues es el procedimiento básico de muchas técnicas como la  clasificación o la recuperación de información. Los documentos suelen  representarse en un espacio de rasgos de alta dimensionalidad, donde cada  término que ocurre en el documento se trata como un rasgo y el peso de cada  término refleja su importancia en el documento. Debido a los grandes volúmenes  de información textual existentes en la actualidad y a que el cálculo de las  semejanzas entre documentos es un proceso muy costoso dada su alta  dimensionalidad, la reducción drástica del número de semejanzas calculadas  durante este tipo de búsquedas reviste una importancia crucial. </font> </p>     <p align="justify"><font face="Verdana" size="2">En la literatura  aparecen numerosas propuestas de métodos de acceso a objetos multidimensionales,  que los organizan de&nbsp; algún modo, garantizando que dado un objeto de  consulta puedan recuperarse los objetos más relacionados con éste, usando un  determinado criterio de comparación (más cercanos, más semejantes, etc.). Los  objetos así obtenidos son conocidos como la vecindad del objeto de consulta. </font> </p>     <p align="justify"><font face="Verdana" size="2">Un  tipo especial de método multidimensional es el basado en espacios métricos. La  mayoría de los métodos de este tipo propuestos en la literatura sufren el  problema conocido como “maldición de la dimensionalidad” [1], que consiste en  que cuando se incrementa el número de dimensiones del espacio de representación  de los objetos, disminuye drásticamente la selectividad o se incrementa el  tiempo de procesamiento, por lo que empeoran sus prestaciones. Entre estos  métodos se tiene la familia M-tree [2], que disminuye drásticamente sus  prestaciones a partir de 25 dimensiones. </font> </p>     <p align="justify"><font face="Verdana" size="2">Para resolver el problema de la  maldición de la dimensionalidad se han diseñado métodos especiales que lo  enfocan de diversas maneras. En 1996 Dickerson [3], propuso un método basado en  un grafo o malla conexa, construida mediante una variante del método de  triangulación de Delaunay [4], con todos los objetos que forman parte del  problema. En esta malla cada objeto queda conectado con aquellos que se  encuentran más cercanos a éste en el espacio de representación. Pero esta  estructura se usa sólo para encontrar la vecindad de los objetos que forman  parte de ella. Además, en el caso de los documentos, tampoco es posible utilizar  el método de Delaunay, debido a que lo común en la MT es contar con más  dimensiones que documentos y este método requiere precisamente lo contrario. En  1997 Nene y Naya [5], propusieron una variante de un método de Friedman [6],  para encontrar el vecino más cercano, que se basa en la construcción de una  estructura de datos, en la que se almacenan algunos datos precalculados que  luego van a ser usados para las búsquedas, evitando que sean calculados en ese  momento. </font> </p>     <p align="justify"><font face="Verdana" size="2">La construcción de esta estructura es costosa en tiempo, pero se  realiza una sola vez. Para su construcción se ordenan los objetos por la primera  dimensión y durante la etapa de búsqueda, los objetos candidatos a solución son  aquellos que están encerrados entre un conjunto de hiperplanos, calculados para  esa dimensión según la consulta. Luego se sigue un proceso de descarte para el  resto de las coordenadas. Este algoritmo resulta costoso en tiempo cuando el  número de las dimensiones es muy alto. Otras propuestas más recientes, como son  el VA-file [7], y el IQ-tree [8], consideradas como métodos de compresión,  mantienen buenas prestaciones hasta dimensiones mucho mayores; han sido probadas  por sus autores hasta 500 dimensiones, pero siguen siendo métodos de búsqueda  exhaustiva, aunque usan espacios de representación más simples. </font> </p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">El IQ-tree se  comporta mejor que el VA-file, pero para espacios de sólo unas decenas de  dimensiones. Otra vía propuesta en la literatura ha sido reducir la  dimensionalidad del espacio, aplicando diferentes técnicas de selección de  rasgos [9] [10],, hasta un valor apropiado que permita aplicar las técnicas  existentes. Actualmente se trabaja en el desarrollo de algoritmos más eficientes  de búsqueda de los k-vecinos más cercanos que reduzcan el porcentaje de  distancias calculadas, pero estos trabajos se centran en espacios de hasta  algunos centenares de dimensiones [11] [12]. En este artículo se propone un  método de acceso con una estructura de indexado en forma de grafo que permite  determinar en forma aproximada la vecindad de un documento dado como consulta.  Este método se usa en clasificación supervisada, y presenta buenas prestaciones  para espacios de muy alta dimensionalidad (decenas de miles de dimensiones). </font> </p>     <p align="justify"><font face="Verdana" size="2">El  método reduce drásticamente la cantidad de semejanzas calculadas para obtener la  vecindad de un documento mientras la calidad de la clasificación es similar a la  obtenida con la búsqueda exhaustiva de la vecindad. El trabajo está organizado  como sigue: en el desarrollo se muestran las principales ideas usadas para el  diseño del método propuesto, se describen la estructura de datos y los  algoritmos de búsqueda propuestos, así como los experimentos realizados para  evaluar sus prestaciones. Luego se presenta un análisis de los resultados  obtenidos y finalmente se dan las conclusiones a este trabajo. </font> </p>     <p align="justify"><b><font face="Verdana" size="2">II. DESARROLLO </font></b> </p>     <p align="justify"><b><font face="Verdana" size="2">1.  Materiales y métodos </font></b> </p>     <p align="justify"><font face="Verdana" size="2"><b>1.1 Componentes de los métodos de indexado y  características deseadas</b> </font> </p>     <p align="justify"><font face="Verdana" size="2">Los métodos de indexado están formados por dos  componentes: la estructura de indexado, que determina la organización de los  datos y la estrategia de búsqueda, que determina el algoritmo con el que se  recorre la estructura de indexado. La estructura de indexado puede ser un  arreglo, una lista, un árbol, un grafo (que es el que se usa en esta propuesta),  etc., o cualquier combinación de éstas. Las principales estrategias de búsqueda  reportadas en la literatura son: la exhaustiva (tomada como referencia para el  resto de los métodos), con particionamiento [13] con múltiples etapas [14].,  Omni [15], aproximada [16] y búsqueda en el espacio de solución [17]. En el  presente caso, se propone una estrategia que consta de dos etapas, mezclando una  búsqueda exhaustiva en un pequeño conjunto de objetos con la estrategia de mejor  en profundidad para obtener una solución aproximada de la vecindad. </font> </p>     <p align="justify"><font face="Verdana" size="2">Una vez que se selecciona una combinación de estructura de indexado y  estrategia de búsqueda, se espera que el método formado cumpla con la mayoría de  las propiedades siguientes: </font> </p>     <p align="justify"><font face="Verdana" size="2">• Alta capacidad de página: que la cantidad de  objetos que pueden ser almacenados en un tamaño determinado de memoria sea  máxima. </font> </p>     <p align="justify"><font face="Verdana" size="2">• Alta selectividad: que un elevado porcentaje de objetos que no  pertenecen a la solución de una consulta no sean visitados durante las  búsquedas. • Comportamiento escalable en cuanto a la dimensionalidad: que no  empeoren las prestaciones a medida que crece el problema a tratar. </font> </p>     <p align="justify"><font face="Verdana" size="2">• Garantía de  que los objetos más semejantes se encuentren cercanos en la estructura de  indexado. </font> </p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">• Facilidad de paralelización: debido a que, por lo general, los  problemas tratados son de gran tamaño y es deseable aprovechar la potencia de  cálculo de las arquitecturas paralelas. En Minería de Textos es usual comparar  dos documentos di,dj utilizando la medida de semejanza del coseno. Como el  método propuesto se basa en un espacio métrico se necesita una función de  distancia, que puede obtenerse como el dual de la semejanza coseno mediante la  expresión: </font> </p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07.1.jpg" width="419" height="59"></font></p>     
<p align="justify"><font face="Verdana" size="2">donde la función coseno se calcula de la siguiente forma:</font></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07.2.gif" width="386" height="163"></font></p>     
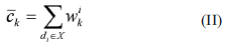
<p align="justify">&nbsp;</p>     <p align="justify"><font face="Verdana" size="2">donde n es el número de términos (dimensiones) del espacio de representación  w<sub>ik</sub> y w<sub>jk</sub> son los pesos del término k en los documentos d<sub>i</sub>  y d<sub>j</sub>, respectivamente.</font></p>     <p align="justify"><font face="Verdana" size="2">Esta función de distancia retorna valores entre 0 y 1. El valor 0 se  corresponde (al ser el dual de la semejanza) con la máxima semejanza entre los  objetos, mientras que el valor 1 se corresponde con la mínima. Usualmente, a  partir de un documento de consulta se desea conocer de su vecindad los primeros  k-vecinos (k-NN) en orden decreciente de semejanza (o creciente de distancia) y  los vecinos que se encuentran a menos de un radio dado (o con semejanza mayor  que un umbral), entre otros casos. En el apartado siguiente se explica cómo se  construye la estructura de indexado y cómo a partir de un documento de consulta  se calcula su vecindad. </font></p>     <p align="justify"><b><font face="Verdana" size="2">1.2. Método de acceso propuesto </font></b></p>     <p align="justify"><font face="Verdana" size="2">Al igual que otros  métodos, en este caso se cuenta con dos conjuntos de documentos, el primero, y  más pequeño (E), es conocido como conjunto de entrenamiento y es usado para  construir la estructura de indexado; el segundo (T), que cuenta con un enorme  volumen de documentos, es usado como consulta o conjunto de prueba. De los  métodos descritos se ha utilizado la idea del uso de un grafo y de dividir el  problema en dos etapas: construir primero la estructura de indexado con el  conjunto de entrenamiento de modo offline y una sola vez, por lo que no importa  su costo en tiempo, y realizar las consultas (o búsquedas) online tantas veces  como se requiera y con el menor costo en uso de CPU y tiempo posibles,  reduciendo el número de distancias entre documentos calculadas. Otra idea  aplicada es el uso de centroides de grupos de documentos como pivotes durante la  construcción de la estructura. Un centroide  <img border="0" src="/img/fbpe/uct/v12n48/art07.3.gif" width="120" height="23">,  es el documento representativo de un conjunto de documentos X. Éste puede ser  calculado de distintas formas, por ejemplo, como el vector suma de todos los  documentos del conjunto. En ese caso cada componente <img border="0" src="/img/fbpe/uct/v12n48/art07.4.gif" width="20" height="24">se calcula como:</font></p>     
<p align="justify"><font face="Verdana" size="2">&nbsp;<img border="0" src="/img/fbpe/uct/v12n48/art07.5.jpg" width="230" height="58"></font></p>     
]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">donde w<sub>ik</sub> se corresponde con el peso del término k en el documento <img border="0" src="/img/fbpe/uct/v12n48/art07.6.gif" width="38" height="18"> </font> </p>     
<p align="justify"><font face="Verdana" size="2">Si el conjunto X está constituido sólo por dos documentos {d<sub>p</sub>, d<sub>q</sub>},  por comodidad en la notación, en lugar de  <img border="0" src="/img/fbpe/uct/v12n48/art07.7.jpg" width="142" height="22"></font></p>     
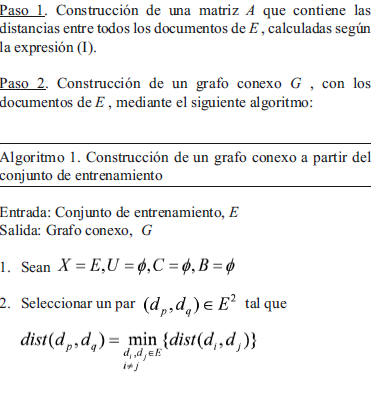
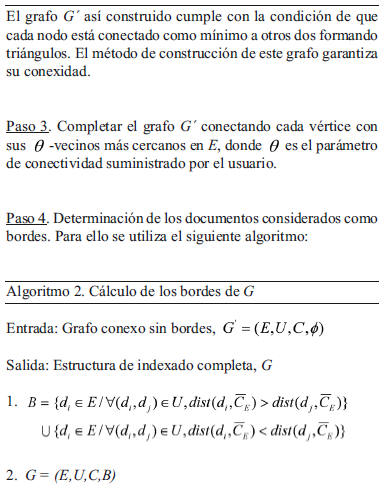
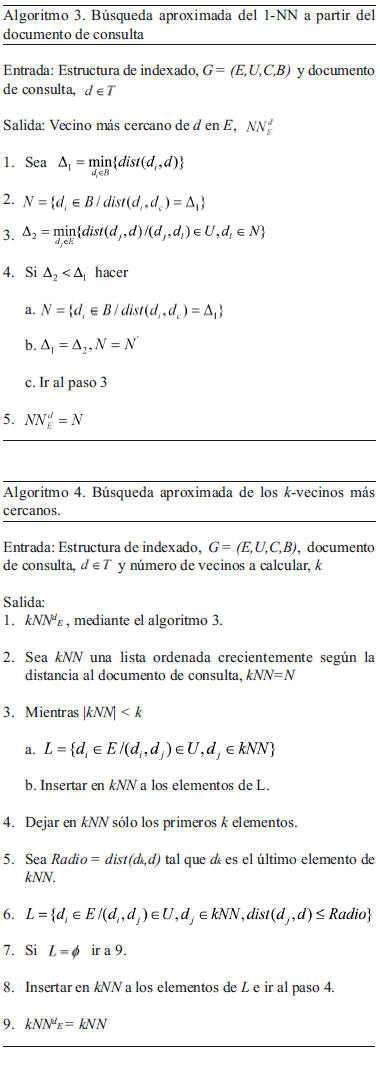
<p align="justify"><font face="Verdana" size="2">La idea general del método propuesto es la siguiente: construir a partir de  los documentos del conjunto de entrenamiento un grafo conexo contenido en un  hiper-anillo, con centro en el centroide del conjunto y con dos bordes: uno  interior, alrededor del centroide y formado por una selección de los documentos  más cercanos a éste; y otro exterior, formado por una selección de los  documentos más alejados de él. La fase de consulta se realiza en dos etapas. En  la primera se determina, usando el método exhaustivo, cuál de los documentos que  pertenecen a los bordes es el más cercano al documento de consulta. Este  documento se toma como punto de entrada a la estructura y utilizando el criterio  del mejor en profundidad se sigue un proceso de selección y descarte de  documentos hasta que se obtiene el vecino más cercano. El proceso se detiene  cuando no es posible seguir avanzando en la estructura sin alejarse del  documento de consulta. El vecino más cercano encontrado pudiera ser el verdadero  o una aproximación. Si se desea que la respuesta a la consulta contenga más  documentos se aplica una última fase de búsqueda (kNN). Partiendo del vecino más  cercano encontrado en la etapa anterior, se explora el grafo siguiendo una  estrategia de primero en profundidad y se va construyendo el conjunto solución  agregando nuevos documentos cercanos al de consulta hasta que se obtengan en un  número de k , ordenados en orden creciente de distancia. A partir de estas  ideas, las hipótesis que serán comprobadas con el método propuesto son: </font></p>     <p align="justify"><font face="Verdana" size="2">• La  suma del número de documentos que pertenecen a los bordes y el número de  documentos que es evaluado durante el resto del proceso de búsqueda es menor que  el total de documentos en la estructura, en contraposición con el método  exhaustivo, que evalúa el 100% de los documentos. </font></p>     <p align="justify"><font face="Verdana" size="2">• Si el método se usa embebido  en un clasificador de documentos, (que es el objetivo final con que se ha  diseñado) los resultados obtenidos en la clasificación son en alto grado  semejantes a los obtenidos cuando se usa en las mismas condiciones el método  exhaustivo. </font></p>     <p align="justify"><font face="Verdana" size="2"><b>1.3 Construcción de la estructura de indexado</b> </font></p>     <p align="justify"><font face="Verdana" size="2">La estructura de  indexado propuesta es un grafo G=(E,U,C,B), donde los vértices son los  documentos del conjunto de entrenamiento E={d1,d2,...,dn}, U es el conjunto de  las aristas (relaciones de distancias entre los vértices); C contiene a los  centroides de todos los pares de vértices relacionados en U ; y B es el conjunto  de los elementos de E que pertenecen a los bordes del grafo. G se obtiene a  partir de E y de un valor de conectividad  <img border="0" src="/img/fbpe/uct/v12n48/art07.8.gif" width="23" height="17">suministrado,  mediante la secuencia de pasos siguiente:</font></p>     
<p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07.9.jpg" width="377" height="406"></font></p>     
<p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07.10.jpg" width="378" height="364"></font></p>     
<p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07.11.jpg" width="390" height="502"></font></p>     
]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2"><b>1.4 Estrategia de búsqueda </b></font></p>     <p align="justify"><font face="Verdana" size="2">La estrategia de búsqueda que se sigue para encontrar el vecino más cercano y  los k vecinos más cercanos del conjunto de entrenamiento a un documento de  consulta se describe en los algoritmos 3 y 4, respectivamente.</font></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07.2.jpg" width="380" height="1069"></font></p>     
<p align="justify"><font face="Verdana" size="2"><b>2. Resultados  </b></font></p>     <p align="justify"><font face="Verdana" size="2"><b>Experimentos realizados</b> </font></p>     <p align="justify"><font face="Verdana" size="2">Para comprobar la efectividad del método se tomó como  base la colección de documentos Reuters Corpus Versión 1 (RCV1- v2). Esta  colección contiene un total de 800000 documentos, clasificados manualmente en  103 tópicos. Se usó la partición LYRL2004 que contiene 23149 documentos de  entrenamiento y 781265 documentos de prueba, conformando un espacio de  representación de 47152 dimensiones. Para comprobar la selectividad del método  propuesto se procedió como sigue: </font></p>     <p align="justify"><font face="Verdana" size="2"><u>Experimento 1.</u> Estudio de la selectividad. Se  construyeron 6 subconjuntos de entrenamiento de diferentes tamaños,  seleccionando el 5, 10, 15, 20, 25 y 30% del conjunto de entrenamiento original,  manteniendo la distribución de probabilidades de los tópicos y se construyeron  los grafos correspondientes. Se seleccionaron, además, 20000 documentos de  prueba de forma aleatoria. Para cada documento de prueba se halló el vecino más  cercano utilizando las seis estructuras de indexado creadas. En cada grafo se  calculó el porcentaje promedio de distancias calculadas en los documentos de  prueba. Utilizando los mismos datos se compararon los vecinos más cercanos de  cada documento de prueba obtenidos por el método exhaustivo de búsqueda y el  método propuesto, calculando en cada grafo los porcentajes de soluciones exactas  obtenidas. Además, se reportó para cada grafo el tiempo promedio consumido por  las consultas. </font></p>     <p align="justify"><font face="Verdana" size="2"><u>Experimento 2.</u> Estudio del porcentaje de soluciones aproximadas  obtenidas en las consultas al variar el factor de conectividad durante la  construcción de la estructura de indexado. Se construyó un subconjunto de  entrenamiento seleccionando 4000 documentos del conjunto de entrenamiento  original. Se seleccionaron, además, 20000 documentos de prueba de forma  aleatoria. Se construyeron grafos usando como factor de conectividad 10, 20, 30  y 40. Para cada documento de prueba se halló el vecino más cercano utilizando  las cuatro estructuras de indexado creadas. En cada grafo se calculó el  porcentaje promedio de distancias calculadas en los documentos de prueba y el  porcentaje de soluciones aproximadas obtenidas. Para comprobar si el uso del  método propuesto en un problema de clasificación afecta o no la calidad, se  procedió como se explica a continuación. Artigas, F. et al. Cálculo de la vecinidad mediante grafos en minería de textos 168  </font></p>     <p align="justify"><font face="Verdana" size="2"><u>Experimento 3</u>. Aplicación del  método a la clasificación de documentos. Se seleccionaron 9884 documentos de  entrenamiento (lo que representa el 35% del conjunto original). El espacio de  representación de estos documentos es de 31761 dimensiones. Se seleccionaron  además 20000 objetos de prueba de forma aleatoria. Para el experimento se usó el  conocido clasificador k -NN (18) que asigna el documento de consulta a la clase  (o tópico) más votada. Se denominará clasificador-1 al uso en el k -NN del  método de búsqueda exhaustivo para la obtención de los k - vecinos más cercanos,  y clasificador-2 cuando en su lugar se usa el método de búsqueda propuesto.  </font></p>     <p align="justify"><font face="Verdana" size="2">En  ambos clasificadores se varió el parámetro k en los valores 1, 3, 5 y 10 y se  clasificó a los documentos de prueba. Para evaluar la calidad de la  clasificación se usaron las tradicionales medidas de Precisión, que mide del  total de documentos clasificados la porción que lo fue correctamente;  Relevancia, que mide de los documentos pertenecientes a un tópico la porción que  le fue asignado; y la medida F1 que es la media armónica de las anteriores. Para  obtener la medida F1 sobre todos los tópicos se utilizaron las variantes micro y  macro-promediadas, así como la global (19), debido a que los tópicos de la  colección utilizada difieren significativamente en tamaño. La medida macro-F1  asigna igual importancia a todos los tópicos, mientras que la micro-F1 y la F1  global asignan una mayor importancia a los tópicos más poblados. </font></p>     ]]></body>
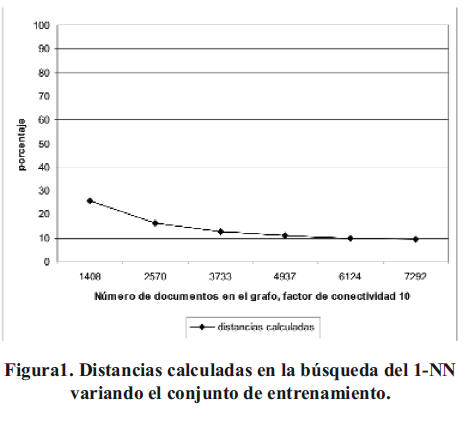
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">Todos los  experimentos anteriores fueron realizados usando implementaciones del método  propuesto y del exhaustivo sobre C estándar y compilados con el gcc 4.1.2, sobre  un Pentium D a 3.40 MHz y 2 Gb de RAM, con la distribución Gentoo del Linux y el  kernel 2.6.23 para 64 bits. </font></p>     <p align="justify"><font face="Verdana" size="2"><b>3.</b> <b>Discusión de los resultados</b> </font></p>     <p align="justify"><font face="Verdana" size="2">Como resultado del  experimento 1 se obtuvieron los datos que se muestran en la <a href="#f1">Figura 1</a>.</font></p>     <p align="justify"><font face="Verdana" size="2"><a name="f1"></a></font></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07f1.jpg" width="467" height="437"></font></p>     
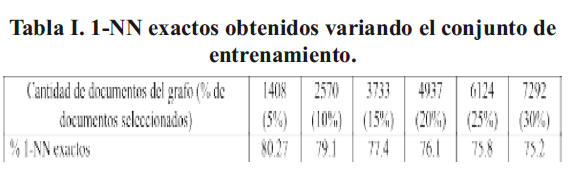
<p align="justify"><font face="Verdana" size="2">Como se aprecia, a medida que aumenta el número  de documentos de entrenamiento en la estructura de indexado, menor es el  porcentaje promedio de comparaciones entre éstos y el documento de consulta,  llegando a ser menor del 10% cuando contiene aproximadamente 6000 documentos.  Por lo tanto, la selectividad del método se incrementa con el aumento del tamaño  del conjunto de entrenamiento. Es necesario tener en cuenta de que en este  porcentaje se incluye el costo fijo de evaluar todos los documentos que  pertenecen a los bordes del grafo. En la <a href="#t1">Tabla I </a>se muestran  los porcentajes de vecinos más cercanos exactos obtenidos por el método  propuesto.</font></p>     <p align="justify"><a name="t1"></a></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07t1.jpg" width="574" height="181"></font></p>     
<p align="justify"><font face="Verdana" size="2">Se nota que en todos los casos  se obtiene un alto porcentaje de soluciones exactas. Como se muestra en la <a href="#f2">Figura 2</a>, el tiempo promedio consumido por las consultas se  mantiene estable en el método propuesto, siendo menor que para el método  exhaustivo a partir de grafos con más de 1000 documentos.</font></p>     <p align="justify"><a name="f2"></a></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07f2.jpg" width="564" height="306"></font></p>     
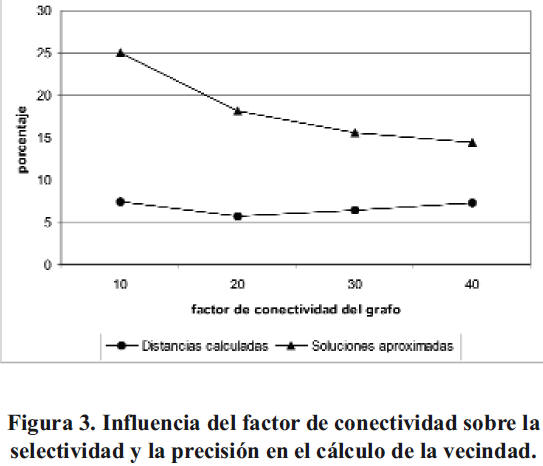
<p align="justify"><font face="Verdana" size="2">Como resultado del Experimento  2, en la <a href="#f3">Figura 3</a> se muestra cómo disminuye el porcentaje de  soluciones aproximadas, al aumentar el factor de conectividad del grafo,  mientras que el porcentaje promedio de documentos comparados se mantiene  relativamente estable.</font></p>     <p align="justify"><a name="f3"></a></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07f3.jpg" width="543" height="466"></font></p>     
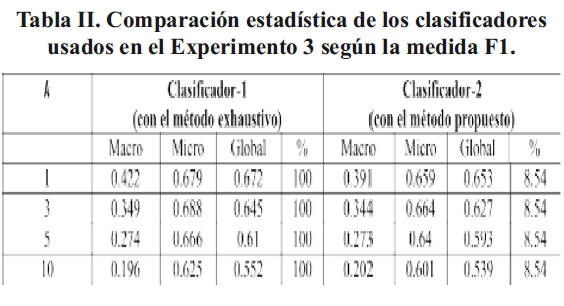
<p align="justify">&nbsp;</p>     <p align="justify"><font face="Verdana" size="2">La <a href="#t2">Tabla II</a>  muestra un resumen de los resultados obtenidos en el Experimento 3. Como se  aprecia, la calidad de la clasificación obtenida en ambos métodos es similar,  con la ventaja adicional de que se reduce sustancialmente el número de  comparaciones entre documentos realizadas en el método propuesto y, por tanto,  el tiempo necesario para realizar el mismo número de clasificaciones.</font></p>     <p align="justify"><a name="t2"></a></p>     <p align="justify"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/uct/v12n48/art07f2.jpg" width="564" height="306"></font></p>     
<p align="justify"><font face="Verdana" size="2">Nótese que en los experimentos  reportados el porcentaje promedio de distancias calculadas al incrementar el k  no varía en el método propuesto. Esto se debe a que la búsqueda de los k vecinos  más cercanos (k&gt;1) no implica cálculos adicionales de distancias, porque éstas  ya fueron calculadas durante el recorrido realizado en el grafo durante la  búsqueda del vecino más cercano. Como resultado del análisis del comportamiento  de la selectividad, calidad en la clasificación y costo en tiempo del método  propuesto se concluye que es factible su uso en problemas de Minería de Textos  que requieran del cálculo de la vecindad de una consulta por semejanza en los  rangos de cantidad de objetos de entrenamiento mostrados. </font></p>     <p align="justify"><font face="Verdana" size="2"><b>III. CONCLUSIONES </b> </font></p>     ]]></body>
<body><![CDATA[<p align="justify"><font face="Verdana" size="2">A continuación se resumen las  principales conclusiones obtenidas con el método de búsqueda de vecindad  propuesto aplicado a la clasificación de documentos. 1. La selectividad crece  con la cantidad de documentos presentes en el grafo, llegando a ser del 90%  cuando este número llega a 6000, reduciendo drásticamente la cantidad de  comparaciones necesarias durante las búsquedas. 2. El costo en tiempo es mucho  menor en el método propuesto que en la estrategia de búsqueda exhaustiva a  partir de grafos con más de 1000 documentos. 3. El porcentaje de soluciones  exactas obtenidas durante las búsquedas es alto y se incrementa con el aumento  del factor de conectividad usado en la construcción de la estructura de  indexado. 4. La calidad de la clasificación obtenida para la colección Reuters  (RCV1-v2), usando el método propuesto, es similar a la obtenida con el método  exhaustivo. 5. Resulta factible el uso del método propuesto en problemas de  Minería de Textos, que involucran espacios de representación de muy alta  dimensionalidad. </font></p>     <p align="justify"><font face="Verdana" size="2"><b>IV. REFERENCIAS </b></font> </p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">1. Schek, H. et al. “A  quantitative analysis and performance study for similarity-search methods in  high-dimensional spaces”, VLDB´98, New York, 1998, pp: 194-205. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532965&pid=S1316-4821200800030000700001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">2. Ciaccia, P. et al. “M-tree:  an efficient access method for similarity search in metric spaces”, VLDB´97,  Atenas, 1997, pp: 426-435. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532966&pid=S1316-4821200800030000700002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">3. Dickerson, M. “Algorithms  for proximity problems in higher dimensions”, Computational geometry theory and  applications, vol. 5, 1996, pp: 277-291. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532967&pid=S1316-4821200800030000700003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">4. Bern, M. et al. “Probably  good mesh generation”, J. Computer and Systems Science, vol. 48, 1994, pp: 384-  409. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532968&pid=S1316-4821200800030000700004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">5. Nene, S. y Nayar, S. “A  simple algorithm for nearest neighbour search in high dimensions”, IEEE  Transactions on Pattern Analysis and Machine Intelligence”, vol. 19, num. 9,  1997, pp: 969-1003. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532969&pid=S1316-4821200800030000700005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">6. Friedman, J. et al. “An  algorithm for finding nearest neighbors”, IEEE Transactions on Computer, C-24,  Oct 1975, pp: 1000-1006. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532970&pid=S1316-4821200800030000700006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">7. Weber, R. y Blott, S. “An  approximation based data structure for similarity search”, Technical report 24,  ESPRIT project ERMES (no. 9141), 1997, pp: 1-25. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532971&pid=S1316-4821200800030000700007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">8. Berchtold, S. et al.  “Independent quantization: an index compression technique for high-dimensional  data spaces”, ICDE´00, San Diego, USA, 2000, pp: 577-588. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532972&pid=S1316-4821200800030000700008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">9. Yang, Y. y Pederson, J. “A  comparative study on feature selection in text categorization”, ICML’97,  Nashville, 1997, pp: 412-420. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532973&pid=S1316-4821200800030000700009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><p align="justify"><font face="Verdana" size="2">10. Ciesielski, K. et al.  “Histogram-based dimensionality reduction of term vectors space”, CISIM’07, vol.  28, Artigas, F. et al. Cálculo de la vecinidad mediante grafos en minería de  textos 170 num. 30, 2007, pp: 103-108. </font></p>     <!-- ref --><p align="justify"><font face="Verdana" size="2">11. Young-Sheng, C. et al.  “Fast and versatile algorithm for nearest neighbor search based on a lower bound  tree”, Pattern recognition letters, Elsevier, New York, vol. 40, num. 2, 2007,  pp: 360-375. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532975&pid=S1316-4821200800030000700011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">12. Gómez-Ballester, E. et al.  “Some improvements in tree based nearest neighbour search algorithms”, CIARP’2003,  Spring-Verlag, Berlin, 2003, pp: 456-463. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532976&pid=S1316-4821200800030000700012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">13. Hjaltason, G. y Samet, H.  “Ranking in spatial databases”, Symposium on Large Spatial Databases, Portlan,  1995, pp: 83-95. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532977&pid=S1316-4821200800030000700013&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">14. Seidl, T. y Kriegel, H.  “Optimal multi-step k-nearest neighbor search”, SIGMOD´98, Seattle, Washington,  USA, 1998, pp: 154-165. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532978&pid=S1316-4821200800030000700014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">15. Pagel, B. et al. “Deflating  the dimensionality curse using multiple fractal dimensions”, ICDE, San Diego,  USA, 2000, pp: 589-598. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532979&pid=S1316-4821200800030000700015&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">16. Ciaccia, P. y Patella, M.  “Pac nearest neighbour queries: approximate and controlled search in high-dimensional  and metric spaces”, ICDE´00, Washington DC, 2000, pp: 244. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532980&pid=S1316-4821200800030000700016&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">17. M. R. K. y Shahabi, C.  “Voronoi-based k nearest neighbor search for spatial network databases”,  VLDB´2004, Toronto, 2004, pp: 840-851. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532981&pid=S1316-4821200800030000700017&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">18. Dasarathy, B. V. “Nearest  Neighbor (NN) Norms: NN Pattern Classification Techniques”, Los Alamitos,  California, IEEE Computer Society Press, 1991, 447 págs. </font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532982&pid=S1316-4821200800030000700018&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p align="justify"><font face="Verdana" size="2">19. Sebastiani, F. “Machine  learning in automated text categorization”, ACM Computing Survey, vol. 34, num.  1, 2002, pp: 1-47.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=2532983&pid=S1316-4821200800030000700019&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body>
<back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Schek]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<source><![CDATA[A quantitative analysis and performance study for similarity-search methods in high-dimensional spaces]]></source>
<year>1998</year>
<page-range>194-205</page-range><publisher-loc><![CDATA[New York ]]></publisher-loc>
<publisher-name><![CDATA[VLDB´98]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Ciaccia]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
</person-group>
<source><![CDATA[M-tree: an efficient access method for similarity search in metric spaces]]></source>
<year>1997</year>
<page-range>426-435</page-range><publisher-loc><![CDATA[Atenas ]]></publisher-loc>
<publisher-name><![CDATA[VLDB´97]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Dickerson]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<source><![CDATA[Algorithms for proximity problems in higher dimensions]]></source>
<year>1996</year>
<volume>5</volume>
<page-range>277-291</page-range></nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Bern]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<source><![CDATA[Probably good mesh generation]]></source>
<year>1994</year>
<volume>48</volume>
<page-range>384- 409</page-range></nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Nene]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
<name>
<surname><![CDATA[Nayar]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A simple algorithm for nearest neighbour search in high dimensions]]></article-title>
<source><![CDATA[IEEE Transactions on Pattern Analysis and Machine Intelligence]]></source>
<year>1997</year>
<volume>19</volume>
<numero>9</numero>
<issue>9</issue>
<page-range>969-1003</page-range></nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Friedman]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<source><![CDATA[An algorithm for finding nearest neighbors]]></source>
<year>Oct </year>
<month>19</month>
<day>75</day>
<page-range>1000-1006</page-range></nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Weber]]></surname>
<given-names><![CDATA[R]]></given-names>
</name>
<name>
<surname><![CDATA[Blott]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<source><![CDATA[An approximation based data structure for similarity search]]></source>
<year>1997</year>
<volume>9141</volume>
<page-range>1-25</page-range><publisher-name><![CDATA[Technical report 24]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Berchtold]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
</person-group>
<source><![CDATA[Independent quantization: an index compression technique for high-dimensional data spaces]]></source>
<year>2000</year>
<page-range>577-588</page-range><publisher-loc><![CDATA[San Diego ]]></publisher-loc>
<publisher-name><![CDATA[ICDE´00]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Yang]]></surname>
<given-names><![CDATA[Y]]></given-names>
</name>
<name>
<surname><![CDATA[Pederson]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<source><![CDATA[A comparative study on feature selection in text categorization]]></source>
<year>1997</year>
<page-range>412-420</page-range><publisher-loc><![CDATA[Nashville ]]></publisher-loc>
<publisher-name><![CDATA[ICML’97]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Ciesielski]]></surname>
<given-names><![CDATA[K]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Histogram-based dimensionality reduction of term vectors space]]></article-title>
<source><![CDATA[CISIM’07]]></source>
<year>2007</year>
<volume>28</volume>
<numero>30</numero>
<issue>30</issue>
<page-range>103-108</page-range></nlm-citation>
</ref>
<ref id="B11">
<label>11</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Young-Sheng]]></surname>
<given-names><![CDATA[C]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Fast and versatile algorithm for nearest neighbor search based on a lower bound tree]]></article-title>
<source><![CDATA[Elsevier]]></source>
<year>2007</year>
<volume>40</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>360-375</page-range><publisher-loc><![CDATA[New York ]]></publisher-loc>
</nlm-citation>
</ref>
<ref id="B12">
<label>12</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Gómez-Ballester]]></surname>
<given-names><![CDATA[E]]></given-names>
</name>
</person-group>
<source><![CDATA[Some improvements in tree based nearest neighbour search algorithms]]></source>
<year>2003</year>
<page-range>456-463</page-range><publisher-loc><![CDATA[Berlin ]]></publisher-loc>
<publisher-name><![CDATA[Spring-Verlag]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B13">
<label>13</label><nlm-citation citation-type="confpro">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hjaltason]]></surname>
<given-names><![CDATA[G]]></given-names>
</name>
<name>
<surname><![CDATA[Samet]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<source><![CDATA[Ranking in spatial databases]]></source>
<year></year>
<conf-name><![CDATA[ Symposium on Large Spatial Databases]]></conf-name>
<conf-date>1995</conf-date>
<conf-loc>Portlan </conf-loc>
<page-range>83-95</page-range></nlm-citation>
</ref>
<ref id="B14">
<label>14</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Seidl]]></surname>
<given-names><![CDATA[T]]></given-names>
</name>
<name>
<surname><![CDATA[Kriegel]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<source><![CDATA[Optimal multi-step k-nearest neighbor search]]></source>
<year>1998</year>
<page-range>154-165</page-range><publisher-loc><![CDATA[Seattle^eWashington Washington]]></publisher-loc>
</nlm-citation>
</ref>
<ref id="B15">
<label>15</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Pagel]]></surname>
<given-names><![CDATA[B]]></given-names>
</name>
</person-group>
<source><![CDATA[Deflating the dimensionality curse using multiple fractal dimensions]]></source>
<year>2000</year>
<page-range>589-598</page-range><publisher-loc><![CDATA[San Diego ]]></publisher-loc>
<publisher-name><![CDATA[ICDE]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B16">
<label>16</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Ciaccia]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
<name>
<surname><![CDATA[Patella]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<source><![CDATA[Pac nearest neighbour queries: approximate and controlled search in high-dimensional and metric spaces]]></source>
<year>2000</year>
<publisher-loc><![CDATA[^eWashington DC Washington DC]]></publisher-loc>
<publisher-name><![CDATA[ICDE´00]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B17">
<label>17</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[M. R]]></surname>
<given-names><![CDATA[K]]></given-names>
</name>
<name>
<surname><![CDATA[Shahabi]]></surname>
<given-names><![CDATA[C]]></given-names>
</name>
</person-group>
<source><![CDATA[Voronoi-based k nearest neighbor search for spatial network databases]]></source>
<year>2004</year>
<page-range>840-851</page-range><publisher-loc><![CDATA[Toronto ]]></publisher-loc>
<publisher-name><![CDATA[VLDB´2004]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B18">
<label>18</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Dasarathy]]></surname>
<given-names><![CDATA[B. V]]></given-names>
</name>
</person-group>
<source><![CDATA[Nearest Neighbor (NN) Norms: NN Pattern Classification Techniques]]></source>
<year>1991</year>
<page-range>447</page-range><publisher-loc><![CDATA[Los Alamitos^eCalifornia California]]></publisher-loc>
<publisher-name><![CDATA[IEEE Computer Society Press]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B19">
<label>19</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Sebastiani]]></surname>
<given-names><![CDATA[F]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Machine learning in automated text categorization]]></article-title>
<source><![CDATA[ACM Computing Survey]]></source>
<year>2002</year>
<volume>34</volume>
<numero>1</numero>
<issue>1</issue>
<page-range>1-47</page-range></nlm-citation>
</ref>
</ref-list>
</back>
</article>