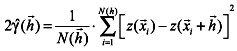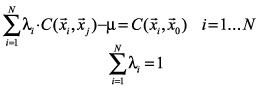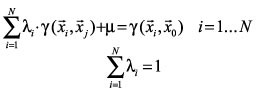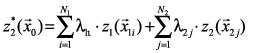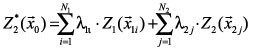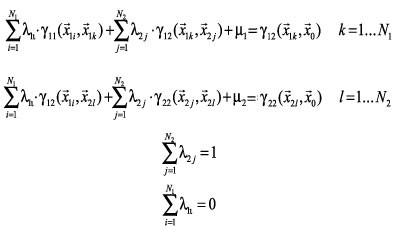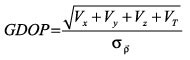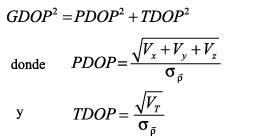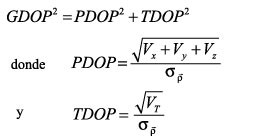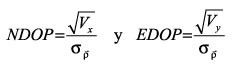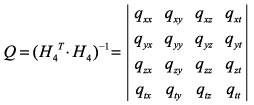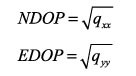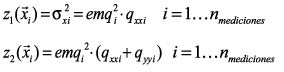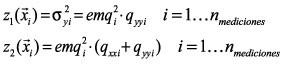<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0378-1844</journal-id>
<journal-title><![CDATA[Interciencia]]></journal-title>
<abbrev-journal-title><![CDATA[INCI]]></abbrev-journal-title>
<issn>0378-1844</issn>
<publisher>
<publisher-name><![CDATA[ASOCIACIÓN INTERCIENCIA]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0378-18442007000900005</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Método para optimizar las mediciones topográficas con aparatos gps]]></article-title>
<article-title xml:lang="en"><![CDATA[A method to optimize topographic measurements using gps devices]]></article-title>
<article-title xml:lang="pt"><![CDATA[Um método para optimize medidas topograficas usando dispositivos do gps]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Ortiz-Marín]]></surname>
<given-names><![CDATA[Rafael]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[del Río-Cidoncha]]></surname>
<given-names><![CDATA[María Gloria]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Martínez-Palacios]]></surname>
<given-names><![CDATA[Juan]]></given-names>
</name>
<xref ref-type="aff" rid="A03"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Cobos-Gutiérrez]]></surname>
<given-names><![CDATA[Carlos]]></given-names>
</name>
<xref ref-type="aff" rid="A04"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad de Valladolid, España Escuela de Administración de Le Mans, Francia Universidad de Sevilla (US), España]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
<country>España</country>
</aff>
<aff id="A02">
<institution><![CDATA[,Departamento de Ingeniería Gráfica, ESI  ]]></institution>
<addr-line><![CDATA[Sevilla ]]></addr-line>
</aff>
<aff id="A03">
<institution><![CDATA[,ESI-US  ]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
<country>España</country>
</aff>
<aff id="A04">
<institution><![CDATA[,Universidad Politécnica de Madrid Universidad Politécnica de Cataluña ]]></institution>
<addr-line><![CDATA[ ]]></addr-line>
<country>España</country>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>09</month>
<year>2007</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>09</month>
<year>2007</year>
</pub-date>
<volume>32</volume>
<numero>9</numero>
<fpage>586</fpage>
<lpage>592</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_arttext&amp;pid=S0378-18442007000900005&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_abstract&amp;pid=S0378-18442007000900005&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://ve.scielo.org/scielo.php?script=sci_pdf&amp;pid=S0378-18442007000900005&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[Hasta hoy, en el levantamiento topográfico mediante satélites artificiales, para conocer las coordenadas de un lugar, o bien se medía reiteradamente en él un determinado número de veces y se hacía la media para obtener el valor más probable, o con una sola medición se suponía que ésa era la coordenada del sitio. Éstas eran las técnicas usadas, independientemente del número de épocas o del tiempo de colocación en el punto. En el primer caso se tenía una nube de puntos, de los que no se sabía cuales eran las mediciones qué más se aproximaban a las coordenadas del sitio donde estaba posicionada la antena GPS. Ahora, aplicando un método basado en técnicas Geoestadísticas, concretamente el cokrigeado, se puede extraer de esa nube de puntos, un subconjunto, cuya media mejora la exactitud de la media que se obtenía con el conjunto de todos ellos. La aplicación de esta metodología es la que se desarrolla en este artículo.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[Until today, to know the coordinates of a place one could measure several times and after that calculate the average in order to obtain the more probable value. Another option was doing only one measure and suppose that was the coordinate of that place. These were the techniques always used. First case, had a cloud of points but it didn’t know which measurements were nearest to the place were the GPS antenna was situated. Now applying a method based on geostatistic techniques, concretely the cokriging one, it can extract a subgroup of that cloud of points, whose average improves the exactitude of the average that it can obtain with the group of all of them. This methodology is developed in this paper.]]></p></abstract>
<abstract abstract-type="short" xml:lang="pt"><p><![CDATA[Até hoje, no exame topográfico por meio dos satélites artificiais, para saber as coordenadas um lugar, ou era repetidamente moderado nele um determinado número de vezes e média foi feito para obter mais o valor provável, ou com uma única medida supos aquela que um era a coordenada do local. Estas eram as técnicas usadas, independentemente do número das épocas ou da época de posicionar no ponto. No primeiro caso uma nuvem dos pontos foi tida, de que não se soube porque eram as medidas o que veio perto de mais às coordenadas do local onde a antena GPS foi posicionada. Agora, aplicando um método baseado em técnicas de Geoestadísticas, concreta o cokrigeado um, pode ser extraído dessa nuvem dos pontos, um subgrupo, cuja melhoria média o exactitude da média que foi obtida com o jogo de todo. A aplicação desta metodologia é essa que é desenvolvida neste artigo.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[Autocorrelación Espacial]]></kwd>
<kwd lng="es"><![CDATA[Cokrigeado]]></kwd>
<kwd lng="es"><![CDATA[GPS]]></kwd>
<kwd lng="es"><![CDATA[Semivariograma]]></kwd>
<kwd lng="es"><![CDATA[Variables Regionalizadas]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[   <B>    <P align="center" style="line-height: 100%"><font face="Verdana" size="3">M&Eacute;TODO PARA OPTIMIZAR LAS MEDICIONES TOPOGR&Aacute;FICAS CON APARATOS GPS</font></P>     <P align="center" style="line-height: 100%"><font face="Verdana" size="2">Rafael Ortiz-Mar&iacute;n, Mar&iacute;a Gloria del R&iacute;o-Cidoncha, Juan Mart&iacute;nez-Palacios y Carlos Cobos-Guti&eacute;rrez</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Rafael Ortiz-Mar&iacute;n</font></B><font face="Verdana" size="2">. Ingeniero Industrial, Universidad de Valladolid, Espa&ntilde;a. M.B.A., Escuela de Administraci&oacute;n de Le Mans, Francia. Doctor, Universidad de Sevilla (US), Espa&ntilde;a. Profesor, Escuela Superior de Ingenieros (ESI), US, Espa&ntilde;a. e-mail: rafortiz@esi.us.es</font></P> <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Mar&iacute;a Gloria del R&iacute;o-Cidoncha</font></B><font face="Verdana" size="2">. Arquitecta, Doctora Ingeniero Industrial y Master en E-Learning, US, Espa&ntilde;a. Direcci&oacute;n: Departamento de Ingenier&iacute;a Gr&aacute;fica, ESI, Av. De los Descubrimientos s/n, Isla de la Cartuja, 41092 Sevilla, Espa&ntilde;a. e-mail: cidoncha@esi.us.es</font></P> <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Juan Mart&iacute;nez-Palacios</font></B><font face="Verdana" size="2">. Ingeniero Industrial y DEA en Gesti&oacute;n de la Producci&oacute;n, ESI-US, Espa&ntilde;a. Profesor, ESI-US, Espa&ntilde;a. e-mail: juanmp@esi.us.es</font></P> <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Carlos Cobos-Guti&eacute;rrez</font></B><font face="Verdana" size="2">. Ingeniero de Caminos Canales y Puertos, Universidad Polit&eacute;cnica de Madrid, Espa&ntilde;a. Doctor, Universidad Polit&eacute;cnica de Catalu&ntilde;a, Espa&ntilde;a. Profesor ESI, US, Espa&ntilde;a. e-mail: ccobos@esi.us.es</font> </P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"><b>RESUMEN</b></font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Hasta hoy, en el levantamiento topogr&aacute;fico mediante sat&eacute;lites artificiales, para conocer las coordenadas de un lugar, o bien se med&iacute;a reiteradamente en &eacute;l un determinado n&uacute;mero de veces y se hac&iacute;a la media para obtener el valor m&aacute;s probable, o con una sola medici&oacute;n se supon&iacute;a que &eacute;sa era la coordenada del sitio. &Eacute;stas eran las t&eacute;cnicas usadas, independientemente del n&uacute;mero de &eacute;pocas o del tiempo de colocaci&oacute;n en el punto. En el primer caso se ten&iacute;a una nube de puntos, de los que no se sab&iacute;a cuales eran las mediciones qu&eacute; m&aacute;s se aproximaban a las coordenadas del sitio donde estaba posicionada la antena GPS. Ahora, aplicando un m&eacute;todo basado en t&eacute;cnicas Geoestad&iacute;sticas, concretamente el cokrigeado, se puede extraer de esa nube de puntos, un subconjunto, cuya media mejora la exactitud de la media que se obten&iacute;a con el conjunto de todos ellos. La aplicaci&oacute;n de esta metodolog&iacute;a es la que se desarrolla en este art&iacute;culo.</font></P>  <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">A METHOD TO OPTIMIZE TOPOGRAPHIC MEASUREMENTS USING GPS DEVICES</font></P> </B>    ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"><b>SUMMARY</b></font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Until today, to know the coordinates of a place one could measure several times and after that calculate the average in order to obtain the more probable value. Another option was doing only one measure and suppose that was the coordinate of that place. These were the techniques always used. First case, had a cloud of points but it didn’t know which measurements were nearest to the place were the GPS antenna was situated. Now applying a method based on geostatistic techniques, concretely the cokriging one, it can extract a subgroup of that cloud of points, whose average improves the exactitude of the average that it can obtain with the group of all of them. This methodology is developed in this paper.</font></P>  <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">UM M&Eacute;TODO PARA OPTIMIZE MEDIDAS TOPOGRAFICAS USANDO DISPOSITIVOS DO GPS</font></P> </B>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"><b>RESUMO</b></font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">At&eacute; hoje, no exame topogr&aacute;fico por meio dos sat&eacute;lites artificiais, para saber as coordenadas um lugar, ou era repetidamente moderado nele um determinado n&uacute;mero de vezes e m&eacute;dia foi feito para obter mais o valor prov&aacute;vel, ou com uma &uacute;nica medida supos aquela que um era a coordenada do local. Estas eram as t&eacute;cnicas usadas, independentemente do n&uacute;mero das &eacute;pocas ou da &eacute;poca de posicionar no ponto. No primeiro caso uma nuvem dos pontos foi tida, de que n&atilde;o se soube porque eram as medidas o que veio perto de mais &agrave;s coordenadas do local onde a antena GPS foi posicionada. Agora, aplicando um m&eacute;todo baseado em t&eacute;cnicas de Geoestad&iacute;sticas, concreta o cokrigeado um, pode ser extra&iacute;do dessa nuvem dos pontos, um subgrupo, cuja melhoria m&eacute;dia o exactitude da m&eacute;dia que foi obtida com o jogo de todo. A aplica&ccedil;&atilde;o desta metodologia &eacute; essa que &eacute; desenvolvida neste artigo.</font></P>  <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">PALABRAS CLAVE / Autocorrelaci&oacute;n Espacial / Cokrigeado / GPS / Semivariograma / Variables Regionalizadas /</font></P> </B><FONT SIZE=2>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Recibido: 12/07/2006. Modificado: 26/07/2007. Aceptado: 30/07/2007.</font></P> </FONT><B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Introducci&oacute;n</font></P> </B>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Se pretende mejorar los resultados obtenidos a partir de series de observaciones de distinta duraci&oacute;n de un mismo punto. Dichas observaciones fueron realizadas con equipos de c&oacute;digo y se calcularon, en postproceso, empleando una estaci&oacute;n de referencia fija y pr&oacute;xima. La idea esencial es la obtenci&oacute;n, a partir de todas las observaciones realizadas de un punto, de aquel subconjunto de las mismas cuya media se aproxime m&aacute;s a las coordenadas que se suponen exactas.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">La distribuci&oacute;n de las mediciones alrededor del punto en cuesti&oacute;n sigue una distribuci&oacute;n de Rayleigh, que es una distribuci&oacute;n normal bidimensional con desviaciones t&iacute;picas iguales. Esto permite hablar de la probabilidad de que en una medici&oacute;n tal o cual punto se encuentre fuera de un circulo de un di&aacute;metro determinado, pero no se conoce qu&eacute; puntos aceptar y cuales rechazar.</font></P>     ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Desde punto de vista te&oacute;rico, el empleo de la geoestad&iacute;stica se fundamenta en el hecho de ser una herramienta &uacute;til para el estudio de las variables num&eacute;ricas distribuidas en el espacio (Chauvet, 1994). Se puede entonces sugerir la idea de interpretar esto en t&eacute;rminos de funci&oacute;n aleatoria. As&iacute;, a cada punto del espacio se le asocia una variable aleatoria (VA) <I>Z</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="16" height="16">), para dos puntos diferentes   e , se tendr&aacute;n entonces dos VAs <I>Z</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) y <I>Z</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05y.jpg" width="15" height="21">) diferentes pero no independientes, y es precisamente su grado de correlaci&oacute;n el encargado de reflejar la continuidad de cualquier fen&oacute;meno en estudio, de modo que el &eacute;xito de esta t&eacute;cnica es la determinaci&oacute;n de la funci&oacute;n de correlaci&oacute;n espacial de los datos (Zhang <I>et al</I>., 1995).</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">En base a ello se ha aplicado la teor&iacute;a de la variable regionalizada, que permite seleccionar los puntos que m&aacute;s se aproximan al valor real de las coordenadas del v&eacute;rtice en cuesti&oacute;n, rechazando los dem&aacute;s puntos. Las coordenadas planim&eacute;tricas (X,Y) se analizan independientemente, dado que los mejores valores obtenidos no tienen porqu&eacute; corresponder a la misma serie, ni mucho menos a una misma observaci&oacute;n.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El m&eacute;todo consiste en asignar a cada una de las mediciones obtenidas y a cada par de coordenadas X e Y, las variables regionalizadas para las coordenadas X, las coordenadas Y y las variables regionalizadas cruzadas XY. Estas variables permiten definir el semivariograma te&oacute;rico, y a partir de &eacute;ste, el semivariograma modelo. Por medio de la interpolaci&oacute;n por krigeado y cokrigeado, y utilizando el semivariograma modelo, se calculan de nuevo estas variables regionalizadas en los puntos de las mediciones. De todas las mediciones se seleccionan aquellas que tienen la variable regionalizada con un menor valor. Las mediciones as&iacute; seleccionadas coinciden con las coordenadas que m&aacute;s se aproximan a las coordenadas reales del v&eacute;rtice.</font></P>  <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Conceptos Te&oacute;ricos.</font> </P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Elementos geoestad&iacute;sticos utilizados</font></P> </B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Este ep&iacute;grafe presenta los principales conceptos te&oacute;ricos necesarios para el desarrollo de este trabajo. Se inicia con una definici&oacute;n de la variable regionalizada, luego se define el variograma y se calcula el estimador del variograma y, por &uacute;ltimo, se ofrece una r&aacute;pida visi&oacute;n del c&aacute;lculo de los pesos para la interpolaci&oacute;n mediante el krigeado y el cokrigeado.</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Variable regionalizada</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Seg&uacute;n (Blais y Carlier, 1968), citados por Olea (1975), una variable regionalizada es una funci&oacute;n num&eacute;rica con distribuci&oacute;n espacial que var&iacute;a de un punto a otro con continuidad aparente, pero cuyas variaciones no pueden ser representadas por una funci&oacute;n matem&aacute;tica simple. La teor&iacute;a de la variable regionalizada presupone que una variaci&oacute;n de una variable puede ser expresada por la suma de tres componentes (Burrough, 1986), a saber: i) una componente estructural, asociada a un valor medio constante o a una tendencia constante; ii) una componente aleatoria espacialmente correlacionada; y iii) un ruido aleatorio o error residual.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">S&iacute;  <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">representa una posici&oacute;n en una, dos o tres dimensiones, entonces el valor de la variable Z en , est&aacute; dada (Burrough, 1986) por</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua1.jpg" width="139" height="23">&nbsp;&#8195;&#8195;(1)</font></P>      
]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde <I>m</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">): funci&oacute;n determin&iacute;stica que describe la componente estructural de Z en <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="16" height="16">, e'(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">): t&eacute;rmino estoc&aacute;stico que var&iacute;a localmente y depende espacialmente de <I>m</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">), y e'': ruido aleatorio no correlacionado, con distribuci&oacute;n normal de media cero y varianza s<SUP>2</SUP>.</font></P>  <I>    
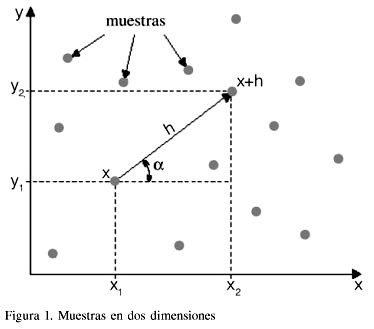
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El variograma</font></P> </I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El variograma es una herramienta b&aacute;sica de soporte de las t&eacute;cnicas de krigeado, que permite representar cuantitativamente la variaci&oacute;n de un fen&oacute;meno regionalizado en el espacio (Huijbregts, 1975).</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Sean dos variables regionalizadas, X e Y, donde X= <I>Z</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) y Y= <I>Z</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">+<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">). En el caso objeto de este trabajo se hallan referidas a un mismo atributo medido en dos posiciones diferentes, conforme se ilustra en la  <a href="#fig1">Figura 1</a>, donde <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16"> define una posici&oacute;n, de componentes (<I>x<SUB>i</SUB></I>,<I>y<SUB>i</SUB></I>), y  <img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19"> un vector distancia (m&oacute;dulo y direcci&oacute;n) que separa los dos puntos.</font></P>      
<P align="center" style="line-height: 100%"><a name="fig1"> <img border="0" src="/img/fbpe/inci/v32n9/art05fig1.jpg" width="374" height="329"></a></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El nivel de dependencia entre esas dos variables regionalizadas X e Y, este representado por el variograma, 2g(<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">), y &eacute;ste est&aacute; definido como la esperanza matem&aacute;tica del cuadrado de la diferencia entre los valores de puntos en el espacio, separados por un vector distancia  <img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="39">:</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua2.jpg" width="315" height="28">    2)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Generalizando a una muestra <I>z</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) <I>i</I>=1,2,...,<I>n</I>, el variograma se estima (Journel y Huijbregts, 1978) seg&uacute;n</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua3.jpg" width="237" height="51">&nbsp;        (3)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde 2(<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">): variograma estimado; <I>N</I>(<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">): n&uacute;mero de pares de valores medidos, <I>z</I>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB>) y <I>z</I>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB>+<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">), separados por un vector distancia <I>h</I>; y <I>z</I>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB>) y <I>z</I>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB>+<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">): valores de la i-&eacute;sima observaci&oacute;n de la variable regionalizada, recogidos en los en los puntos <SUB> <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i </SUB>y<SUB> <I> <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</I></SUB>+<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19"> (<I>i</I>=1,...<I>n</I>), separados por un vector .</font></P>     
]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Muchos autores definen el variograma de forma distinta a la Ec. 3, considerando lo que com&uacute;nmente se describe como semivariograma:</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua4.jpg" width="338" height="35">      (4)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">An&aacute;logamente la funci&oacute;n semivariograma se puede estimar por</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua5.jpg" width="235" height="48">&nbsp;       (5)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde <I>N</I>(), <I>z</I>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19"></SUB>) y <I>z</I>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB>+<img border="0" src="/img/fbpe/inci/v32n9/art05h1.jpg" width="12" height="19">) tienen el mismo significado que en f&oacute;rmulas anteriores.</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El semivariograma y la covarianza est&aacute;n relacionados (Journel y Huijbregts, 1978) por la ecuaci&oacute;n</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua6.jpg" width="121" height="27">     (6)</font></P>  <I>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El krigeado</font></P> </I>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Conocido el semivariograma de la variable y existiendo dependencia espacial entre las muestras, se pueden interpolar valores en cualquier posici&oacute;n del campo de estudio, sin sesgo y con varianza m&iacute;nima. El m&eacute;todo de interpolaci&oacute;n se llama krigeado, nombre que fue dado por (Matheron, 1963) en homenaje al matem&aacute;tico sudafricano Krige. El krigeado consiste en efectuar una ponderaci&oacute;n, es decir, atribuir un peso a cada valor observado. Los pesos son calculados de manera que minimice la varianza de estimaci&oacute;n resultante, teniendo en cuenta las caracter&iacute;sticas geom&eacute;tricas del problema (Matheron, 1970). Al minimizar la varianza de estimaci&oacute;n se garantiza el uso &oacute;ptimo de la informaci&oacute;n disponible (Zhang <I>et al.</I>, 1995).</font></P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Estimador del krigeado</font></I><font face="Verdana" size="2">. Suponiendo que se quieran estimar valores z*, para cualquier posici&oacute;n <I>x</I><SUB>0</SUB>, donde no se tiene valores medidos, y que la estimaci&oacute;n debe ser una combinaci&oacute;n lineal de los valores medidos. Es decir:</font></P>      ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua7.jpg" width="138" height="47">&nbsp;               (7)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde N: n&uacute;mero de valores medidos, <I>z</I>(<I><SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB></I>), que intervienen en la estimaci&oacute;n, y l<I><SUB>i</SUB></I>: pesos asociados a cada valor medido <I>z</I>(<I><SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">i</SUB></I>).</font></P>  <I>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Sistema de ecuaciones del krigeado</font></I><font face="Verdana" size="2">. Para que un estimador sea &oacute;ptimo, no puede ser sesgado y debe tener varianza m&iacute;nima (David, 1977). En t&eacute;rminos matem&aacute;ticos,</font></P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua8.jpg" width="163" height="30">&nbsp; </font></I><font face="Verdana" size="2">(8)</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">y</font></P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua9.jpg" width="334" height="34">&nbsp; </font></I><font face="Verdana" size="2">(9)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Aplicando el m&eacute;todo de los multiplicadores de Lagrange (David, 1977), el sistema de krigeado quedar&aacute; seg&uacute;n las Ecs. 10 u 11 dependiendo que sea en funci&oacute;n de la covarianza o el semivariograma.</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua10.jpg" width="264" height="90">&nbsp;       (10)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua11.jpg" width="267" height="94">&nbsp;      (11)</font></P>  <I>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El cokrigeado</font></P> </I>    ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El m&eacute;todo estad&iacute;stico de interpolaci&oacute;n expuesto en el apartado anterior, el krigeado, es un caso particular del cokrigeado que se analizar&aacute; enseguida. Una vez que exista dependencia espacial para cada una de las variables Z<SUB>1</SUB> y Z<SUB>2</SUB>, y que tambi&eacute;n exista dependencia espacial entre Z<SUB>1</SUB> y Z<SUB>2</SUB>, entonces es posible utilizar el cokrigeado para estimar valores. Esta estimaci&oacute;n puede ser m&aacute;s precisa que el krigeado de una variable simple (Vauclin <I>et al</I>., 1983), cuando el semivariograma cruzado muestra dependencia entre las dos variables.</font></P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Estimador del cokrigeado</font></I><font face="Verdana" size="2">. Suponiendo que se quisiera estimar valores de z<SUP>*</SUP><SUB>2</SUB>, para cualquier localizaci&oacute;n <SUB> <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">0</SUB>, y que la estimaci&oacute;n deba ser una combinaci&oacute;n lineal de ambos z<SUB>1 </SUB>y<SUB> </SUB>z<SUB>2</SUB>, es decir</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua12.jpg" width="261" height="53">&nbsp;       (12)</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde <I>N</I>1 y <I>N</I>2: los n&uacute;meros de puntos vecinos a considerar de <I>Z</I><SUB>1</SUB> y <I>Z</I><SUB>2</SUB>, respectivamente; y l<SUB>1<I>i</I></SUB> y l<SUB>2<I>j</I></SUB>: los pesos asociados a cada valor de <I>Z</I><SUB>1</SUB> y <I>Z</I><SUB>2</SUB>. Tomando <I>z</I><SUB>1</SUB>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">1<I>i</I></SUB>) y <I>z</I><SUB>2</SUB>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">2<I>i</I></SUB>) como solo una realizaci&oacute;n de las funciones aleatorias <I>Z</I><SUB>1</SUB>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">1<I>i</I></SUB>) y <I>Z</I><SUB>2</SUB>(<SUB><img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">2<I>i</I></SUB>), respectivamente, y asumiendo la estacionariedad de orden 2, el estimador puede ser rescrito</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua13.jpg" width="253" height="51">&nbsp;       (13)</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">La Ec. 13 expresa que la estimaci&oacute;n de la variable <I>Z</I><SUB>2</SUB> deber&aacute; ser una combinaci&oacute;n lineal de ambas  <I>Z</I><SUB>1</SUB> y <I>Z</I><SUB>2</SUB>, con los pesos l<SUB>1</SUB> y l<SUB>2<I>  </I></SUB>distribuidos de acuerdo con la dependencia espacial de cada una de las variables entre s&iacute; y la correlaci&oacute;n cruzada entre ellas.</font></P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Sistema de ecuaciones del cokrigeado</font></I><font face="Verdana" size="2">. Para que el estimador sea &oacute;ptimo, no puede ser sesgado y tiene que tener varianza m&iacute;nima. En otras palabras, para que el estimador sea el mejor posible es necesario que no superestime ni subestime valores y que la confianza en las estimaciones sea m&aacute;xima. Matem&aacute;ticamente hablando,</font></P> <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua14.jpg" width="169" height="26">&nbsp; </font></I><font face="Verdana" size="2">(14)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">y</font> </P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua15.jpg" width="366" height="33">&nbsp; </font></I><font face="Verdana" size="2">(15)</font></P>      
]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El sistema de ecuaciones para el cokrigeado queda:</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua16.jpg" width="398" height="230">&nbsp;       (16)</font></P>  <B>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Posicionamiento Espacial. Elecci&oacute;n de las variables regionalizadas</font></P> </B>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Se presentar&aacute; una f&oacute;rmula para calcular el GDOP y sus componentes, como una funci&oacute;n de la geometr&iacute;a de cuatro sat&eacute;lites GPS. Para la navegaci&oacute;n de cuatro sat&eacute;lites GPS, las ecuaciones de navegaci&oacute;n linealizadas son dadas en Jorgensen (1980) como</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua17.jpg" width="83" height="26">&nbsp;             (17)</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde  <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="16" height="16">: vector de dimensi&oacute;n cuatro de las correcciones de la posici&oacute;n y el tiempo,  <img border="0" src="/img/fbpe/inci/v32n9/art05p.jpg" width="14" height="21">: vector de los residuales de las pseudodistancias, y <I>H</I><SUB>4</SUB>: matriz de los cosenos directores asociados al vector de cada sat&eacute;lite.</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">La varianza de los errores de la posici&oacute;n y el tiempo son funciones de los elementos de la diagonal de [<I>H</I><SUB>4</SUB><I><SUP>T</SUP></I><SUB> </SUB>·<SUB> </SUB><I>H</I><SUB>4</SUB>]<SUP>-1</SUP>. Esto conduce al concepto de GDOP (diluci&oacute;n geom&eacute;trica de la precisi&oacute;n) que se define (Sturza, 1983) como</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua18.jpg" width="213" height="44">&nbsp;              (18)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">De manera que</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua19.jpg" width="190" height="60">&nbsp;     (19)</font></P>      
]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">GDOP se puede dividir en las diluciones de precisi&oacute;n en posici&oacute;n y tiempo, PDOP y TDOP respectivamente:</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua20.jpg" width="265" height="140">&nbsp;(20)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">A su vez, el PDOP se puede dividir en HDOP y VDOP, diluciones de precisi&oacute;n en planimetr&iacute;a y altimetr&iacute;a respectivamente, de manera que</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua21.jpg" width="265" height="140">(21)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El HDOP se puede resolver m&aacute;s a fondo en sus componentes X e Y. Si el eje de las X se orienta en una direcci&oacute;n de Oeste a Este, un &quot;al este&quot; DOP (EDOP) y un &quot;al norte&quot; DOP (NDOP) puede definirse (USAF, 1996) como</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua22.jpg" width="233" height="65">&nbsp; &#8194;(22)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El equipo GPS despu&eacute;s del post-procesamiento de los datos, devuelve adem&aacute;s del error cuadr&aacute;tico medio (emq) para cada medici&oacute;n, la matriz Q que es la inversa de la matriz normal de la ecuaci&oacute;n del ajuste por m&iacute;nimos cuadrados (Leica GeoSystem, 1994) y est&aacute; definida como:</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua23.jpg" width="254" height="105">&nbsp;       (23)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">El error cuadr&aacute;tico medio en las soluciones posici&oacute;n, tiempo (PT) se relaciona (USACE, 2003) con la geometr&iacute;a seg&uacute;n la ecuaci&oacute;n</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua24.jpg" width="241" height="44">&nbsp;      (24)</font></P>      
]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde s<SUB>UERE</SUB>: error en la medida de la pseudodistancia, equivalente a s<SUB>r</SUB>; GDOP: factor de geometr&iacute;a que se calcula como</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua25.jpg" width="208" height="34">&nbsp; (25)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Por el mismo razonamiento se pueden definir PDOP, TDOP, HDOP y VDOP, y por supuesto el NDOP y el EDOP (USAF, 1996) como</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua26.jpg" width="136" height="76">&#8195;&#8195;&#8195;&#8195;(26)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">donde <I>q<SUB>xx</I></SUB> y <I>q<SUB>yy</I></SUB> pertenecen a la traza de la matriz Q definida en la Ec 23:</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Esta descomposici&oacute;n permite estudiar separadamente la mejor &quot;X&quot; y la mejor &quot;Y&quot;, que no tienen por qu&eacute; coincidir en el mismo punto.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">La varianza de la posici&oacute;n se puede determinar a partir de la matriz <I>C=emq<SUP>2</SUP>·Q</I> de cada una de las l&iacute;neas base de las mediciones, identificando s<SUB>UERE </SUB>con el <I>emq</I>.</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">s<SUP>2</SUP></font><I><font size="2" face="Verdana"><SUB>x</SUB>=emq<SUP>2</SUP>·q</font><SUB><font face="Verdana" size="2">xx</font> </P> </SUB> </I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para cada base l&iacute;nea de las </font> <I><font size="2" face="Verdana">n</font><SUB><font face="Verdana" size="2">mediciones</font></P> </SUB> </I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">s<SUP>2</SUP></font><I><font size="2" face="Verdana"><SUB>y</SUB>=emq<SUP>2</SUP>·q</font><SUB><font face="Verdana" size="2">yy</font> </P> </SUB> </I>    ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para cada base l&iacute;nea de las <I>n<SUB>mediciones</I></SUB>        (27)</font></P>      <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para cada serie de observaciones se pueden especificar dos variables regionalizadas <I>Z</I><SUB>1</SUB>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) y <I>Z</I><SUB>2</SUB>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) donde   <img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16"> indica el par (<I>X<SUB>i</SUB>,Y<SUB>i</SUB></I>) de la medici&oacute;n en coordenadas UTM, definidas como</font></P>     
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua28.jpg" width="284" height="72">&nbsp;        (28)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">para obtener, la o las mejores coordenadas X de la serie y</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2"> <img border="0" src="/img/fbpe/inci/v32n9/art05ecua29.jpg" width="283" height="67">&nbsp;          (29)</font></P>      
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">para obtener la o las mejores coordenadas Y de la serie.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Evidentemente, el n&uacute;mero de mediciones coincide con el n&uacute;mero de l&iacute;neas base. Como se observa en las Ecs. 28 y 29, para definir las variables regionalizadas  <I>Z</I><SUB>1</SUB>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) y <I>Z</I><SUB>2</SUB>(<img border="0" src="/img/fbpe/inci/v32n9/art05x1.jpg" width="13" height="16">) se han usado las definiciones de NDOP, EDOP y HDOP.</font></P>  <B>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Metodolog&iacute;a</font></P> </B><I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">De campo</font></P> </I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Una vez en el campo, la observaci&oacute;n se efectu&oacute; introduciendo en la unidad de control una serie de par&aacute;metros, a saber: i) m&eacute;todo de posicionamiento, en este caso est&aacute;tico diferencial (la base situada en la Escuela Superior de Ingenieros de Sevilla); ii) m&aacute;scara de elevaci&oacute;n, de 15º; y iii) establecimiento del intervalo de grabaci&oacute;n en segundos (&eacute;pocas). Cada &eacute;poca es un tiempo de grabaci&oacute;n de datos; a menor valor de &eacute;poca, mayor cantidad de datos almacenados en la tarjeta, y por ende, se deber&aacute; elegir un menor tiempo de puesta de observaci&oacute;n para no agotar su capacidad.</font></P>     ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">En cada uno de los v&eacute;rtices se realizaron series de mediciones de 5, 8, 15, 20, 25, 30, 35, 45, 60, 120 &eacute;pocas. Cada serie est&aacute; compuesta al menos por 30 observaciones del v&eacute;rtice en cuesti&oacute;n. En algunos casos ciertos archivos se han repetido, dando lugar a un mayor n&uacute;mero de observaciones.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">En resumen, se puede decir que el archivo de 8 &eacute;pocas del v&eacute;rtice Atalaya de los Barros, por ejemplo, comprende 33 observaciones de ese v&eacute;rtice de 8 &eacute;pocas de duraci&oacute;n cada una (<a href="#tab1">Tabla I</a>). Esta metodolog&iacute;a de trabajo viene impuesta por el objetivo de analizar la precisi&oacute;n de la medida tanto aisladamente como en funci&oacute;n del tiempo de observaci&oacute;n y por tanto del n&uacute;mero de &eacute;pocas.</font></P>      <P align="center" style="line-height: 100%"><a name="tab1"> <img border="0" src="/img/fbpe/inci/v32n9/art05tab1.jpg" width="566" height="592"></a></P>  <I>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">De laboratorio.</font> </P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Aplicaci&oacute;n de la geoestad&iacute;stica</font></P> </I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Al igual que en la observaci&oacute;n para el c&aacute;lculo de las l&iacute;neas bases, aqu&iacute; hay par&aacute;metros correctores. Entre otros se tiene: i) correcci&oacute;n ionosf&eacute;rica y troposf&eacute;rica; ii) tipo de efem&eacute;rides usadas; iii) tipo de datos usados (solo c&oacute;digo); iv) para cada observaci&oacute;n se han obtenido espec&iacute;ficamente las coordenadas GPS en el Sistema WGS 84 formadas por la terna latitud, longitud y altura elipsoidal, las coordenadas Cartesianas (X,Y,Z) y las matrices de varianza-covarianza.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para cada una de las series de mediciones realizadas en los distintos v&eacute;rtices y a distintas &eacute;pocas, se define el valor de las variables regionalizadas en cada uno de los puntos de estas mediciones utilizando las Ecs. 28 y 29. Para cada serie de mediciones se deben obtener: i) la &quot;mejor X&quot; de las mediciones, es decir, la coordenada que m&aacute;s se aproxima al v&eacute;rtice; y ii) la &quot;mejor Y&quot; de las mediciones, &iacute;dem de lo mismo. En ambos casos esto se conseguir&aacute; mediante el cokrigeado, definiendo para obtener la &quot;mejor X&quot; unas variables regionalizadas  <I>Z</I><SUB>1</SUB> y <I>Z</I><SUB>2</SUB> seg&uacute;n las Ecs. 28 y para obtener la &quot;mejor Y&quot; otras variables regionalizadas <I>Z</I><SUB>1</SUB> y <I>Z</I><SUB>2</SUB> seg&uacute;n las Ecs. 29. N&oacute;tese que la definici&oacute;n de la variable <I>Z</I><SUB>2</SUB> es id&eacute;ntica en ambos casos.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Una vez definidas las variables regionalizadas en cada uno de los puntos del plano, para hallar la &quot;mejor X&quot; o la &quot;mejor Y&quot; se procede a calcular los semivariogramas experimentales g<SUB>11</SUB> que corresponde a la variable <I>Z</I><SUB>1</SUB>, g<SUB>22</SUB> que corresponde a la variable <I>Z</I><SUB>2</SUB>, y g<SUB>12</SUB> (semivariograma cruzado) que corresponde a las variables <I>Z</I><SUB>1</SUB> y <I>Z</I><SUB>2</SUB>.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Conseguido el semivariograma omnidireccional deben encontrarse los posibles patrones de anisotrop&iacute;a calculando los variogramas direccionales, para lo cual es de gran ayuda el conocimiento del fen&oacute;meno bajo estudio.</font> </P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Establecidas las direcciones de m&aacute;xima y m&iacute;nima continuidad, se debe seleccionar la tolerancia direccional. Idealmente, deber&iacute;a ser lo menor posible. Lo que ocurre es que con tolerancias direccionales reducidas, el n&uacute;mero de datos abarcados es muy peque&ntilde;o, dando lugar a valores err&aacute;ticos en los variogramas. En la pr&aacute;ctica, se prueban varias tolerancias y se escoge la menor que genera los mejores resultados.</font></P>     ]]></body>
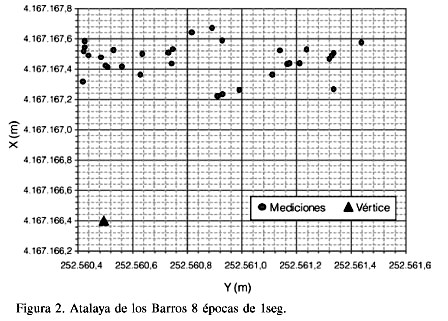
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Conviene indicar que los semivariogramas son muy sensibles a los datos an&oacute;malos (outliers) con valores muy grandes o muy peque&ntilde;os. De forma pr&aacute;ctica, si unos pocos puntos err&aacute;ticos hacen que la forma de estas funciones se vea alterada, es necesario examinarlos cuidadosamente y comprobar que no son fruto de alg&uacute;n tipo de error.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">A partir de los semivariogramas experimentales se debe hallar los semivariogramas modelos. Una vez que se han definido los puntos del variograma experimental, ser&aacute; necesario ajustar un modelo a dichos puntos, denominado variograma te&oacute;rico. Esto se debe a la imposibilidad de trabajar con un variograma como el experimental, carente de una funci&oacute;n matem&aacute;tica precisa (o al menos dif&iacute;cil de caracterizar), y a la necesidad de extender los valores del variograma m&aacute;s all&aacute; de la distancia m&aacute;xima definida. Tambi&eacute;n, por el contrario, ser&aacute; necesaria la extensi&oacute;n del variograma a las proximidades del origen, o sea, para distancias pr&oacute;ximas a 0.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Cuando se realiza el modelado del semivariograma te&oacute;rico, se proponen diversos modelos que se ajusten a los datos experimentales. La elecci&oacute;n de un modelo concreto suele basarse en apreciaciones subjetivas bien documentadas y en la experiencia previa. Sin embargo, puede justificarse la elecci&oacute;n de un modelo en funci&oacute;n de una serie de criterios estad&iacute;sticos, como con el m&eacute;todo de m&iacute;nimos cuadrados ponderado (Cressie, 1985) o con el m&eacute;todo de Jacknife o de validaci&oacute;n cruzada (Isaaks y Srivastava, 1989). Cuando el modelo ha sido identificado, se dice que el variograma ha sido calibrado o validado.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Con los semivariogramas modelos se aplicar&aacute; el <I>cokrigeado</I>, que es solo una modificaci&oacute;n del krigeado ordinario. La variable principal se estima en un punto mediante una combinaci&oacute;n lineal de los datos obtenidos en distintos lugares para las variables primaria y secundaria (una o varias), en este caso solo una. En el cokrigeado es menester la especificaci&oacute;n de las relaciones de dependencia espacial mediante los semivariograma de las diferentes variables y los semivariogramas cruzados.</font></P>  <I>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Aplicaci&oacute;n al v&eacute;rtice Atalaya de los Barros (8 &eacute;pocas de 1seg)</font></P> </I>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Las coordenadas UTM ED50 del v&eacute;rtice Atalaya de los Barros son (<I>X<SUB>v&eacute;rtice</SUB></I>, <I>Y<SUB>v&eacute;rtice</SUB></I>) = (252.560,495; 4.167.166,400) en metros. La representaci&oacute;n en el plano XY de todos los valores observados y del v&eacute;rtice se muestra en la  <a href="#fig2">Figura 2</a></font></P>      <P align="center" style="line-height: 100%"><a name="fig2"> <img border="0" src="/img/fbpe/inci/v32n9/art05fig2.jpg" width="448" height="321"></a></P>      
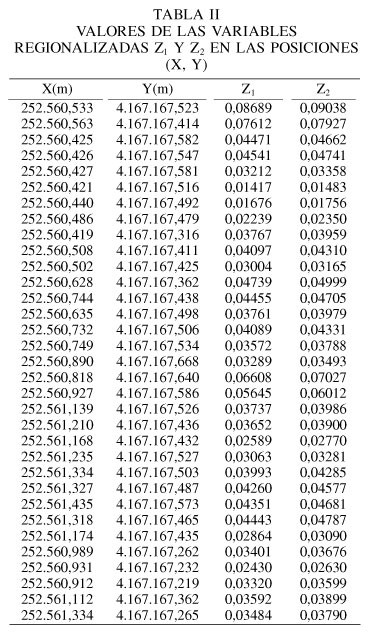
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para calcular la &quot;mejor X&quot;, se halla para cada una de las l&iacute;neas base los valores de las variables regionalizadas Z<SUB>1</SUB> y Z<SUB>2</SUB> seg&uacute;n las Ecs. 28. Estos valores se encuentran en la  <a href="#tab2">Tabla II</a>.</font></P>      <P align="center" style="line-height: 100%"><a name="tab2"> <img border="0" src="/img/fbpe/inci/v32n9/art05tab2.jpg" width="370" height="632"></a></P>      
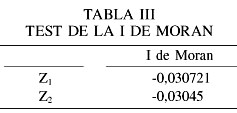
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para ver si las variables Z<SUB>1</SUB> y Z<SUB>2</SUB> que anteriormente se han definido tienen autocorrelaci&oacute;n espacial, se les aplicar&aacute; el test de la I de Moran, con resultados positivos ya que los valores son superiores a la E[1] (Cliff y Ord, 1981). Los resultados para las dos variables se muestran en la  <a href="#tab3">Tabla III</a>.</font></P>      ]]></body>
<body><![CDATA[<P align="center" style="line-height: 100%"><a name="tab3"> <img border="0" src="/img/fbpe/inci/v32n9/art05tab3.jpg" width="237" height="113"></a></P>      
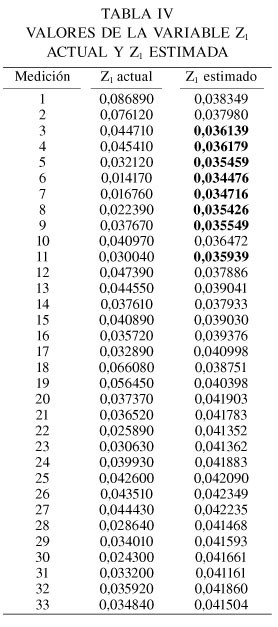
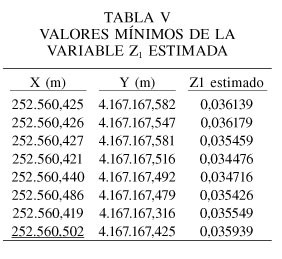
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Siguiendo los pasos detallados en el ep&iacute;grafe anterior se llega a estimar la variable primaria Z<SUB>1</SUB> en los puntos muestrales (<a href="#tab4">Tabla IV</a>); a continuaci&oacute;n las estimaciones de mayor a menor se agrupan en clases (se recomienda crear de 10 a 15 clases) y por &uacute;ltimo se eligen los valores correspondientes a la &uacute;ltima clase. En el caso presente, la &uacute;ltima clase es 0,03618 y sus valores muestrales se exponen en la  <a href="#tab5">Tabla V</a>. Por definici&oacute;n de la variable, estos valores representan el DOP. Cuanto m&aacute;s peque&ntilde;o sea el DOP m&aacute;s exacto es el ajuste de la l&iacute;nea base y, por lo tanto, debe ser la medici&oacute;n de la coordenada del punto. Los puntos muestrales con la variable estimada <I>Z</I><SUB>1</SUB> m&aacute;s peque&ntilde;a, ser&aacute;n los que tengan la coordenada X m&aacute;s cercana al v&eacute;rtice.</font></P>      <P align="center" style="line-height: 100%"><a name="tab4"> <img border="0" src="/img/fbpe/inci/v32n9/art05tab4.jpg" width="278" height="627"></a></P>     
<P align="center" style="line-height: 100%"><a name="tab5"> <img border="0" src="/img/fbpe/inci/v32n9/art05tab5.jpg" width="282" height="259"></a></P>  <B>    
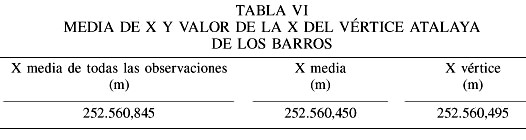
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">An&aacute;lisis de los resultados</font></P> </B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para comprobar que el m&eacute;todo es v&aacute;lido se hicieron mediciones en distintos v&eacute;rtices con distintas &eacute;pocas, y a unos 30 y 60km (Gibarrayo) del v&eacute;rtice de referencia, advirti&eacute;ndose que los resultados obtenidos ten&iacute;an una mejora en la exactitud de las coordenadas UTM X e Y. Solo se mostrar&aacute;n los datos para hallar la &quot;mejor X&quot; en el v&eacute;rtice de Atalaya de los Barros. Atendiendo a lo dicho en el &uacute;ltimo p&aacute;rrafo del ep&iacute;grafe anterior, en la Tabla V que resulta de todo ello el valor de la X subrayado se corresponde con el valor m&aacute;s pr&oacute;ximo a la coordenada &quot;X&quot; del v&eacute;rtice Atalaya de los Barros. Este valor y el resto de los valores, se han obtenido atendiendo al criterio de valor m&iacute;nimo de la variable<I> Z<SUB>1</SUB></I>.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">En la  <a href="#tab6">Tabla VI</a> se compara la media de las X de la <a href="#tab5">Tabla V</a>, la X del v&eacute;rtice Atalaya y la media de las X de todas las observaciones. Como se aprecia, el c&aacute;lculo de la &quot;mejor X&quot; usando el m&eacute;todo de la variable regionalizada, es superior a hacer la media de las X de todas las observaciones.</font></P>      <P align="center" style="line-height: 100%"> <a name="tab6"> <img border="0" src="/img/fbpe/inci/v32n9/art05tab6.jpg" width="526" height="140"></a></P>      
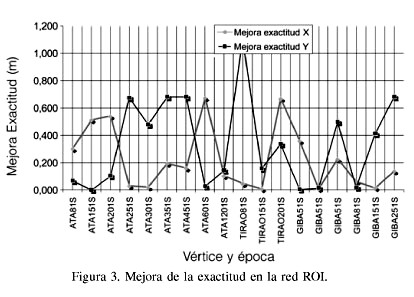
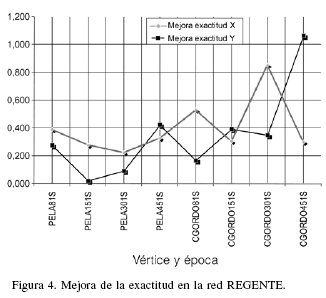
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">En una recopilaci&oacute;n de todos los resultados obtenidos, se compararon las mediciones realizadas en los distintos v&eacute;rtices. Se obtuvo tanto la mejora de la exactitud en la coordenada X como en la coordenada Y, como la diferencia entre la exactitud de la media de todas las observaciones y la exactitud de la media de las observaciones seleccionadas seg&uacute;n el criterio de m&iacute;nimo valor de la VR. Ambos valores se representan en las  <a href="#fig3">Figuras 3</a> y <a href="#fig4">4</a>, para v&eacute;rtices de la red ROI (Red de Orden Inferior) y la red REGENTE (Red Geod&eacute;sica Nacional por T&eacute;cnicas Espaciales).</font></P>      <P align="center" style="line-height: 100%"><a name="fig3"> <img border="0" src="/img/fbpe/inci/v32n9/art05fig3.jpg" width="414" height="297"></a></P>     
]]></body>
<body><![CDATA[<P align="center" style="line-height: 100%"><a name="fig4"> <img border="0" src="/img/fbpe/inci/v32n9/art05fig4.jpg" width="326" height="298"></a></P>  <B>    
<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Conclusiones</font></P> </B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Las t&eacute;cnicas geoestad&iacute;sticas, y en particular el cokrigeado, son de aplicaci&oacute;n a las mediciones GPS. Se han realizado 1234 tomas de datos, de las que en 1099 casos (89,06%) se han obtenido resultados favorables en el test de la I de Moran, lo que indica que existe correlaci&oacute;n espacial (ver Tabla I). Las 135 tomas (10,94%) en las que el test de Moran no ha proporcionado un resultado favorable se han localizado en el v&eacute;rtice de Gibarrayo, en cuya proximidad existen antenas de telefon&iacute;a que han podido influir en la medici&oacute;n por el efecto multicamino y la mayor distancia de este v&eacute;rtice a la base (la distancia de este v&eacute;rtice al m&aacute;ster es de 60km, mientras que la distancia media del resto de v&eacute;rtices analizados es de 30km).</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">La aplicaci&oacute;n de la geoestad&iacute;stica mejora la exactitud de los resultados en las coordenadas planim&eacute;tricas (X,Y), con relaci&oacute;n a las medias de los valores calculados.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Las mejoras obtenidas en la exactitud de la determinaci&oacute;n de las coordenadas UTM X e Y no dependen de la direcci&oacute;n considerada. En algunos casos la mayor mejora corresponde a una direcci&oacute;n y en otros a la contraria.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">No se aprecian influencias del n&uacute;mero de &eacute;pocas en las mejoras que se obtienen aplicando t&eacute;cnicas geoestad&iacute;sticas. Por ello, se propone la realizaci&oacute;n de series de mediciones cortas, entre 8 y 20 &eacute;pocas, para no alargar excesivamente el tiempo de estacionamiento en un punto.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">A la vista de los resultados obtenidos se aconseja un n&uacute;mero de mediciones por serie, entre 33 y 50 veces para cada punto, mejor&aacute;ndose as&iacute; el semivariograma experimental a costa de un mayor tiempo de computaci&oacute;n.</font></P>  <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Desarrollo Futuro</font></P> </B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Partiendo de los modelos te&oacute;ricos elementales de semivariogramas, se propone desarrollar metodolog&iacute;as de c&aacute;lculo de los pesos de &eacute;stos con el fin de conseguir un nuevo modelo te&oacute;rico lineal que se ajuste lo mejor posible al semivariograma experimental. Igualmente, desarrollar nuevas t&eacute;cnicas para obtener el semivariograma te&oacute;rico, como por ejemplo t&eacute;cnicas de bootstrapping.</font></P>     <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Para elegir de todos los puntos vecinos posibles los que proporcionan una varianza m&iacute;nima en el cokrigeado deben desarrollarse t&eacute;cnicas de filtrado.</font></P>     ]]></body>
<body><![CDATA[<P align="justify" style="line-height: 100%"><font face="Verdana" size="2">La influencia de la distancia de los v&eacute;rtices al m&aacute;ster en la aplicaci&oacute;n de esta metodolog&iacute;a a las mediciones con GPS, as&iacute; como la incidencia de otro tipo de se&ntilde;ales (telefon&iacute;a, radio, etc.) sobre la exactitud conseguida con este m&eacute;todo geoestad&iacute;stico requieren de an&aacute;lisis ulterior.</font></P>  <B>    <P align="justify" style="line-height: 100%"><font face="Verdana" size="2">Referencias</font></P> </B>    <!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">1. Blais RA, Carlier PA (1968) Applications Of Geostatistics In Ore Evaluation. En <I>Ore Reserve Estimation And Grade Control.</I> Special Vol. 9. Canadian Institute of Mining and Metalurgy. Montreal, Canada. pp. 41-48.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053799&pid=S0378-1844200700090000500001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">2. Burrough PA (1986) <I>Principles of geographical information systems for land resources assessment</I>. Clarendon Press, Oxford, RU. 193 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053800&pid=S0378-1844200700090000500002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">3. Chauvet P (1994) <I>Aide-Memoire de G&eacute;ostatistique Miniere</I>. &Eacute;cole des Mines. Paris, Francia. 210 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053801&pid=S0378-1844200700090000500003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">4. Cliff A, Ord JK (1981) <I>Spatial Process: Models and Applications</I>. Pion. Londres, RU. 266 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053802&pid=S0378-1844200700090000500004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">5. Cressie N (1985) Fitting variogram models by weighted least square. <I>Math. Geol. 17</I>: 563-586.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053803&pid=S0378-1844200700090000500005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">6. David M (1977) <I>Geostatistical ore reserve estimation</I>. Elsevier. Nueva York, EEUU. 364 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053804&pid=S0378-1844200700090000500006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">7. Huijbregts CJ (1975) Regionalized variables and quantitative analysis of spatial data<I>. </I>En Davis JC, McCullagh MJ (Eds.) <I>Display and analysis of spatial data.</I> Wiley. Londres, RU. pp. 38-53.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053805&pid=S0378-1844200700090000500007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">8. Isaaks EH, Srivastava RM (1989) <I>An introduction to applied geostatistics</I>. Oxford University Press. Nueva York, EEUU. 592 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053806&pid=S0378-1844200700090000500008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">9. Journel AG, Huijbregts, ChJ (1978) <I>Mining Geostatistics</I>. Academic Press. Londres, RU. 600 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053807&pid=S0378-1844200700090000500009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">10. Jorgensen PS (1980) NAVSTAR/Global Positioning System 18-Satellite Constellation. <I>Navigation 27</I>: 89-100.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053808&pid=S0378-1844200700090000500010&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">11. Matheron G (1963) Principles of geostatistics. <I>Econ. Geol. 58</I>: 1246-1266.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053809&pid=S0378-1844200700090000500011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">12. Matheron G (1970) <I>La Th&eacute;orie des Variables Regionalis&eacute;es et ses Applications</I>. Ecole de Mines de Paris. Francia. 212 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053810&pid=S0378-1844200700090000500012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">13. USAF (1996) <I>NAVSTAR GPS User Equipment Introduction</I>. US Space Systems Division. LA, EEUU. 215 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053811&pid=S0378-1844200700090000500013&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">14. Olea RA (1975) <I>Optimum mapping techniques using regionalized variable theory</I>. Series on Spatial Analysis Nº 2. University of Kansas, EEUU. 137 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053812&pid=S0378-1844200700090000500014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">15. Sturza MA (1983) GPS Navigation Using Three Satellites and a Precise Clock. Global Positioning System. <I>Navigation 30</I>: 122-132.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053813&pid=S0378-1844200700090000500015&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">16. USACE (2003) <I>Engineering and Design</I> - <I>NAVSTAR Global Positioning System Surveying</I>. US Army Corps of Engineers. Washington DC, EEUU, 328 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053814&pid=S0378-1844200700090000500016&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">17. Vauclin M, Vieira SR, Vachaud G, Nielsen DR (1983) The Use Of Cokriging With Limited Field Soil Observations. <I>Soil Sci. Soc. Am. J.</I> 47: 175-184.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053815&pid=S0378-1844200700090000500017&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">18. Leica Geosystem (1994) <I>WILD GPS - System 200 User Manual For SKI 2.30</I>. Heerbrugg, Suiza, 137 pp.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053816&pid=S0378-1844200700090000500018&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><P align="justify" style="line-height: 100%"><font face="Verdana" size="2">19. Zhang XF, Van Eijkeren JCH, Heemink AW (1995) On the Weighted Least Squares Method for Fitting a Semivariogram Model. <I>Comput. Geoscie. 21</I>: 605-608.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=1053817&pid=S0378-1844200700090000500019&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body>
<back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Blais]]></surname>
<given-names><![CDATA[RA]]></given-names>
</name>
<name>
<surname><![CDATA[Carlier]]></surname>
<given-names><![CDATA[PA]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Applications Of Geostatistics In Ore Evaluation]]></article-title>
<source><![CDATA[Ore Reserve Estimation And Grade Control]]></source>
<year>1968</year>
<page-range>41-48</page-range><publisher-loc><![CDATA[Montreal ]]></publisher-loc>
<publisher-name><![CDATA[Canadian Institute of Mining and Metalurgy]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Burrough]]></surname>
<given-names><![CDATA[PA]]></given-names>
</name>
</person-group>
<source><![CDATA[Principles of geographical information systems for land resources assessment]]></source>
<year>1986</year>
<page-range>193 pp</page-range><publisher-loc><![CDATA[Oxford ]]></publisher-loc>
<publisher-name><![CDATA[Clarendon Press]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Chauvet]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
</person-group>
<source><![CDATA[Aide-Memoire de Géostatistique Miniere]]></source>
<year>1994</year>
<page-range>210 pp</page-range><publisher-loc><![CDATA[Paris ]]></publisher-loc>
<publisher-name><![CDATA[École des Mines]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Cliff]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Ord]]></surname>
<given-names><![CDATA[JK]]></given-names>
</name>
</person-group>
<source><![CDATA[Spatial Process: Models and Applications]]></source>
<year>1981</year>
<page-range>266 pp</page-range><publisher-loc><![CDATA[Londres ]]></publisher-loc>
<publisher-name><![CDATA[Pion]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Cressie]]></surname>
<given-names><![CDATA[N]]></given-names>
</name>
</person-group>
<source><![CDATA[Fitting variogram models by weighted least square]]></source>
<year>1985</year>
<volume>17</volume>
<page-range>563-586</page-range><publisher-name><![CDATA[Math]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[David]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<source><![CDATA[Geostatistical ore reserve estimation]]></source>
<year>1977</year>
<page-range>364 pp</page-range><publisher-loc><![CDATA[Nueva York ]]></publisher-loc>
<publisher-name><![CDATA[Elsevier]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Huijbregts]]></surname>
<given-names><![CDATA[CJ]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Regionalized variables and quantitative analysis of spatial data]]></article-title>
<person-group person-group-type="editor">
<name>
<surname><![CDATA[Davis]]></surname>
<given-names><![CDATA[JC]]></given-names>
</name>
<name>
<surname><![CDATA[McCullagh]]></surname>
<given-names><![CDATA[MJ]]></given-names>
</name>
</person-group>
<source><![CDATA[Display and analysis of spatial data]]></source>
<year>1975</year>
<page-range>38-53</page-range><publisher-loc><![CDATA[Londres ]]></publisher-loc>
<publisher-name><![CDATA[Wiley]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Isaaks]]></surname>
<given-names><![CDATA[EH]]></given-names>
</name>
<name>
<surname><![CDATA[Srivastava]]></surname>
<given-names><![CDATA[RM]]></given-names>
</name>
</person-group>
<source><![CDATA[An introduction to applied geostatistics]]></source>
<year>1989</year>
<page-range>592 pp</page-range><publisher-loc><![CDATA[Nueva York ]]></publisher-loc>
<publisher-name><![CDATA[Oxford University Press]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Journel]]></surname>
<given-names><![CDATA[AG]]></given-names>
</name>
<name>
<surname><![CDATA[Huijbregts,]]></surname>
<given-names><![CDATA[ChJ]]></given-names>
</name>
</person-group>
<source><![CDATA[Mining Geostatistics]]></source>
<year>1978</year>
<page-range>600 pp</page-range><publisher-loc><![CDATA[Londres ]]></publisher-loc>
<publisher-name><![CDATA[Academic Press]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Jorgensen]]></surname>
<given-names><![CDATA[PS]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[NAVSTAR/Global Positioning System 18-Satellite Constellation]]></article-title>
<source><![CDATA[Navigation]]></source>
<year>1980</year>
<volume>27</volume>
<page-range>89-100</page-range></nlm-citation>
</ref>
<ref id="B11">
<label>11</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Matheron]]></surname>
<given-names><![CDATA[G]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Principles of geostatistics]]></article-title>
<source><![CDATA[Econ. Geol.]]></source>
<year>1963</year>
<volume>58</volume>
<page-range>1246-1266</page-range></nlm-citation>
</ref>
<ref id="B12">
<label>12</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Matheron]]></surname>
<given-names><![CDATA[G]]></given-names>
</name>
</person-group>
<source><![CDATA[La Théorie des Variables Regionalisées et ses Applications]]></source>
<year>1970</year>
<page-range>212 pp</page-range><publisher-name><![CDATA[Ecole de Mines de Paris]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B13">
<label>13</label><nlm-citation citation-type="book">
<collab>USAF</collab>
<source><![CDATA[NAVSTAR GPS User Equipment Introduction]]></source>
<year>1996</year>
<page-range>215 pp</page-range><publisher-loc><![CDATA[LA ]]></publisher-loc>
<publisher-name><![CDATA[US Space Systems Division]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B14">
<label>14</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Olea]]></surname>
<given-names><![CDATA[RA]]></given-names>
</name>
</person-group>
<source><![CDATA[Optimum mapping techniques using regionalized variable theory]]></source>
<year>1975</year>
<page-range>137 pp</page-range><publisher-name><![CDATA[University of Kansas]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B15">
<label>15</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Sturza]]></surname>
<given-names><![CDATA[MA]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[GPS Navigation Using Three Satellites and a Precise Clock]]></article-title>
<source><![CDATA[Global Positioning System. Navigation]]></source>
<year>1983</year>
<volume>30</volume>
<page-range>122-132</page-range></nlm-citation>
</ref>
<ref id="B16">
<label>16</label><nlm-citation citation-type="">
<collab>USACE </collab>
<source><![CDATA[Engineering and Design-NAVSTAR Global Positioning System Surveying: US Army Corps of Engineers]]></source>
<year>2003</year>
<page-range>328</page-range><publisher-loc><![CDATA[Washington^eDC DC]]></publisher-loc>
</nlm-citation>
</ref>
<ref id="B17">
<label>17</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Vauclin]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[Vieira]]></surname>
<given-names><![CDATA[SR]]></given-names>
</name>
<name>
<surname><![CDATA[Vachaud]]></surname>
<given-names><![CDATA[G]]></given-names>
</name>
<name>
<surname><![CDATA[Nielsen]]></surname>
<given-names><![CDATA[DR]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The Use Of Cokriging With Limited Field Soil Observations]]></article-title>
<source><![CDATA[Soil Sci. Soc. Am. J.]]></source>
<year>1983</year>
<volume>47</volume>
<page-range>175-184</page-range></nlm-citation>
</ref>
<ref id="B18">
<label>18</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Geosystem]]></surname>
<given-names><![CDATA[Leica]]></given-names>
</name>
</person-group>
<source><![CDATA[WILD GPS - System 200 User Manual For SKI 2.30.]]></source>
<year>1994</year>
<page-range>137</page-range><publisher-loc><![CDATA[Suiza ]]></publisher-loc>
<publisher-name><![CDATA[Heerbrugg]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B19">
<label>19</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Zhang]]></surname>
<given-names><![CDATA[XF]]></given-names>
</name>
<name>
<surname><![CDATA[Van]]></surname>
<given-names><![CDATA[Eijkeren JCH]]></given-names>
</name>
<name>
<surname><![CDATA[Heemink]]></surname>
<given-names><![CDATA[AW]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[On the Weighted Least Squares Method for Fitting a Semivariogram Model]]></article-title>
<source><![CDATA[Comput. Geoscie.]]></source>
<year>1995</year>
<volume>21</volume>
<page-range>605-608</page-range></nlm-citation>
</ref>
</ref-list>
</back>
</article>